


新智元报道

启元机器人宣布下线5000台具身智能机器人。其具身研究中心锚定“打造首款面向个人的物理AI机器人”目标,判断Physical AI是大语言模型走向物理世界的关键环节,2027年或迎来赛道突破窗口。
目前量产的Q1(小尺寸全身力控人形)与T1(轮足-四足可变形)主要解决硬件稳定性、安全入户及陪伴交互问题,并非家务作业终局产品。真正承载家务能力的轮式H系列仍在迭代中,配套“启元大脑”才是核心体系。在技术路线上,启元融合海外π路线(真机试错成功率高但难规模化)与UMI路线(手持采集泛化佳但成功率低),旨在兼顾真机成功率与数据规模化。

快慢脑分工:通用大模型是教练,自研VLA才是运动员
启元采用借鉴人类双系统认知的“快慢脑”分层架构。GPT-6 Astra等通用大模型作为S2“慢脑”,负责高层任务理解、逻辑推理与长周期规划;自研视觉-语言-动作模型(VLA)作为S1“快脑”,负责接收指令并输出高频连续动作,解决抓取、整理等精细操作。
团队强调,通用大模型不擅长底层动作执行,完全依赖会导致高Token成本与低效。VLA必须与特定本体耦合训练,无法跨硬件通用。当前启元通过API调用GPT,未来若通用模型能理解视频流与空间关系,可作为强化学习的Reward模块加速任务优化。
跳出真机依赖:Hil-UMI重构数据生产链条
针对具身智能数据采集瓶颈,启元推出Hil-UMI范式。传统HG-DAgger模式依赖真机纠错,效率受限;UMI手持采集虽易规模化但缺乏针对性。Hil-UMI增加薄弱环节识别机制,由模型实时分析并指挥数采员定向补录短板数据,形成“识别-采集-更新”闭环。
实验显示,Hil-UMI在整理桌面任务中的采集效率是传统真机模式的5.63倍,且最终完成度更高。该范式利用便携式夹爪实现本体解耦,为众包采集奠定基础。团队坚持数据质量优先于数量,并指出模仿学习存在天花板,需结合后训练与强化学习突破人类水平。

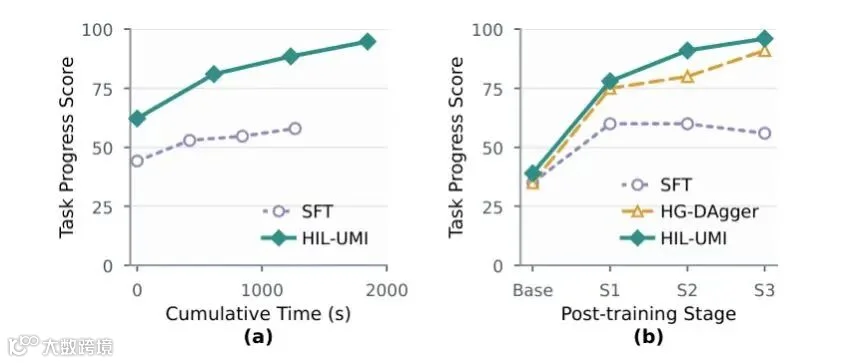
左图为四项任务平均分随累计采集时间的变化;右图为整理桌面任务中各方法随训练阶段的表现
数据算力基建:百万小时仅是阶段性门槛
启元计划2027年数据规模冲击百万小时,但实现通用具身智能仍需千万至上亿小时级数据。数据增长非线性,关键在于任务、物体与环境的多样性覆盖。例如叠衣服场景需覆盖万级家庭与数十万件衣物方能稳定泛化。
算力方面,具身智能训练主体为高冗余视频流,有效信息密度低。在数千卡集群规模下,传统训练跑完一个Epoch需3-6个月。这催生了对视频训练基础设施的迫切需求,需进行筛选、压缩与表征重构。未来目标是拉长上下文窗口至小时甚至天级别,以实现In-Context Learning质变。

C端商业化:95%完成率才是及格线
消费级家务机器人商业化前提是任务完成度达95%以上,低于此标准的产品无法被C端接受。启元策略是集中资源打穿单一Killer Application(如衣物处理全链路),而非追求初期全任务通用。未来家务主力将是新一代轮式H系列,Q1/T1更多承担探索与基础设施角色。
商业化路径包括:寻找酒店、样板间等“家庭同构环境”验证;推进Robot-Ready Home,通过与家装地产结合(如和尚品宅配合资)控制泛化边界;以及将C端终端作为Physical AI时代的数据基础设施,在合规前提下回流海量真实场景数据。
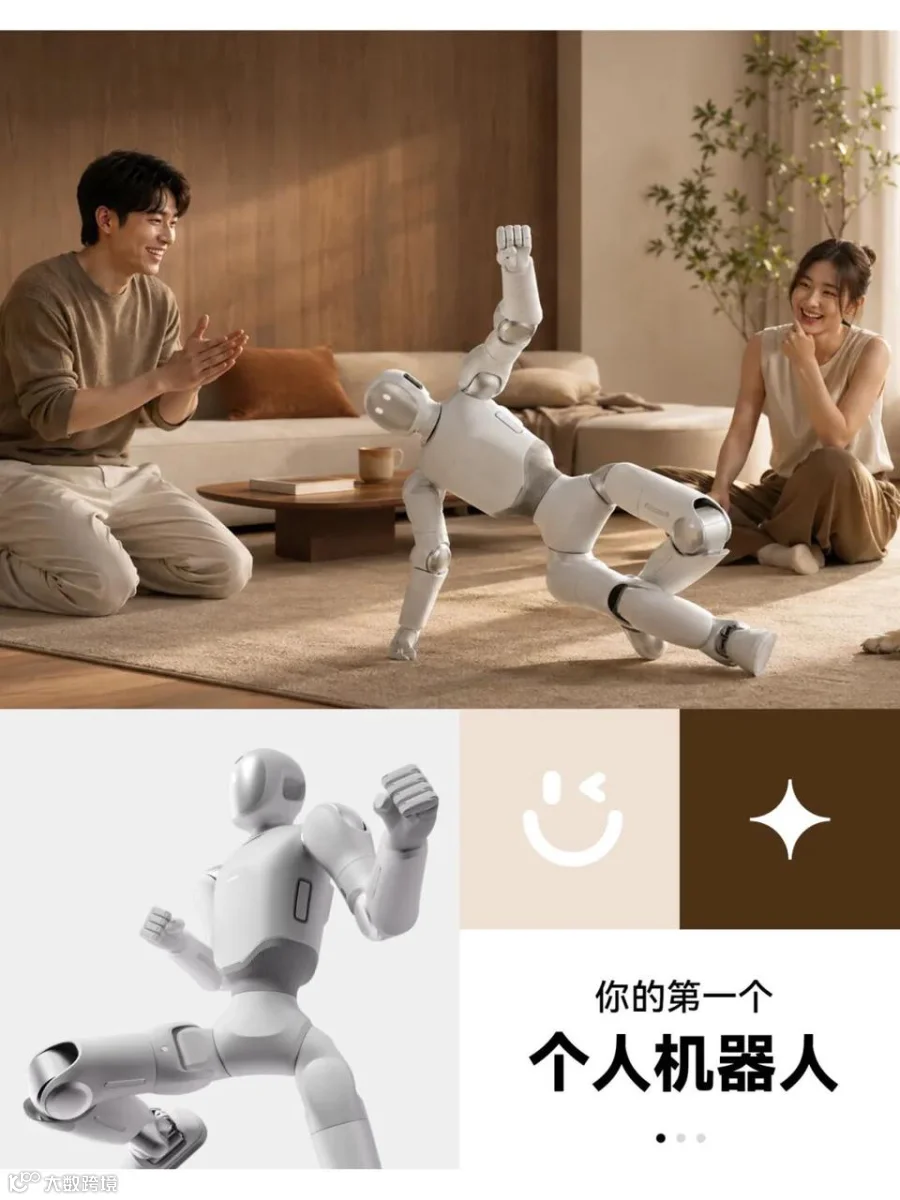
启元Q1

启元T1
竞争壁垒:硬件-数据-范式闭环
面对通用大模型能力跃升的潜在威胁,启元认为大模型属行业公共资源,真正的壁垒在于“本体+高质量数据集+完整训练闭环”。语言模型提供认知但缺乏物理交互“燃料”,OpenAI布局硬件亦出于此逻辑。
当前行业稀缺的是高效数据采集与后训练范式,国内具备地缘优势。启元构建的Physical AI体系涵盖S0运动控制、S1 VLA执行层与S2认知规划层,理想形态类似苹果模式,即硬件、数据与模型深度耦合。尽管面临数据爬坡、工程难度、量产良率及商业模式等多重风险,但物理AI的竞争本质仍是硬件、数据与模型互相咬合的闭环能力。

编辑:Aeneas