

GPT-6 Astra CAD跑分95.9%?新基准ScienceVision揭示AI科学观察短板
近期,GPT-6 Astra在X平台展示的CAD绘图视频引发热议。视频中,涡轮增压器零件建模精细,支持一键拆解,视觉效果出众。其在BenchCAD测试中取得95.9%的高分,甚至引发关于CAD工程师职业前景的讨论。
然而,专业工程师指出:“画得像”不等于“画得对”。模型虽能复刻视觉界面,但在科学原理、几何结构及部件关系上是否准确,仍存疑。业界亟需一个能检验AI对三维科学对象观察与理解能力的专业基准。
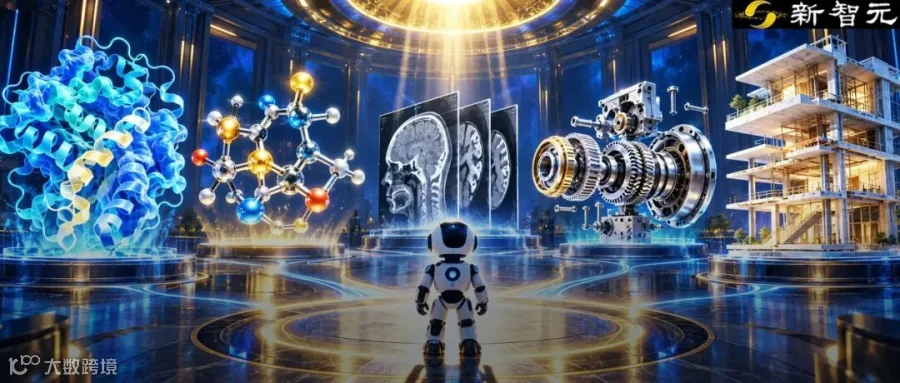
近日,UniPat AI与Elorian AI联合发布了跨学科视觉三维理解与推理基准——ScienceVision。该基准覆盖生物、化学、医学影像、建筑和机械CAD五大领域,旨在评估AI是否具备像科学家一样的观察与推理能力。

测试结果显示,即便是在BenchCAD中表现优异的GPT-6-Astra(搭配Codex),在ScienceVision中也仅获得0.53分(满分1分)。这意味着,在真正的三维科学理解与推理考场上,当前最强模型的及格率刚过一半。

试题详解:模拟专家级三维检视流程
ScienceVision包含250道基于真实三维数据构建的题目,横跨22个子领域。其Demo展示了五个学科的实际检视操作,工具设计高度还原领域专家的工作流:
- 生物学:隐藏蛋白质整体,仅保留柠檬酸分子及邻近离子,测量其间距离。
- 化学:框选晶胞,通过对称操作观察其堆叠结构。
- 医学影像:在CT三个方向切片中定位肾脏病灶边缘。
- 机械CAD:拆解叉车装配体,统计相同零件数量。
- 建筑学:沿坡道测量长度与高差,校验坡度合规性。
这些任务看似简单(旋转、点击、测量),实则要求模型具备清晰的观察逻辑与推理能力。ScienceVision博客已公开原始文件与检视工具,用户可亲身体验通过真实三维检视过程评估AI能力的难度。
填补空白:构建统一跨学科3D评测体系
既往的3D理解基准多服务于日常场景或通用机器人任务,缺乏面向科学领域的系统化评测。科学研究天然依赖三维空间的观察与推理:化学家需测量原子几何关系,放射科医生需在切片间追踪结构,建筑师需确认构件连接。
ScienceVision的核心价值在于填补了这一空白。它强调“斯坦门茨画线”式的洞察力——知道在哪里观察比单纯的数据处理更有价值。该基准统一了不同学科的数据格式与交互逻辑,解决了以往评测中标准不一的问题。
严谨构建:66位专家历时近500小时打磨
Science数据集包含250道题,每道题由真实3D源数据、领域问题、作答要求及专家参考答案组成。评分采用确定性规则,杜绝模糊判断,使其具备转化为强化学习环境的潜力。
构建过程极具挑战:
- 选题科学性:确保问题依赖三维证据,且答案可复核。
- 数据兼容性:处理分子坐标、CT体数据等不同格式,保留关键结构信息。
- 专家验证:依靠领域专家建立可信答案。
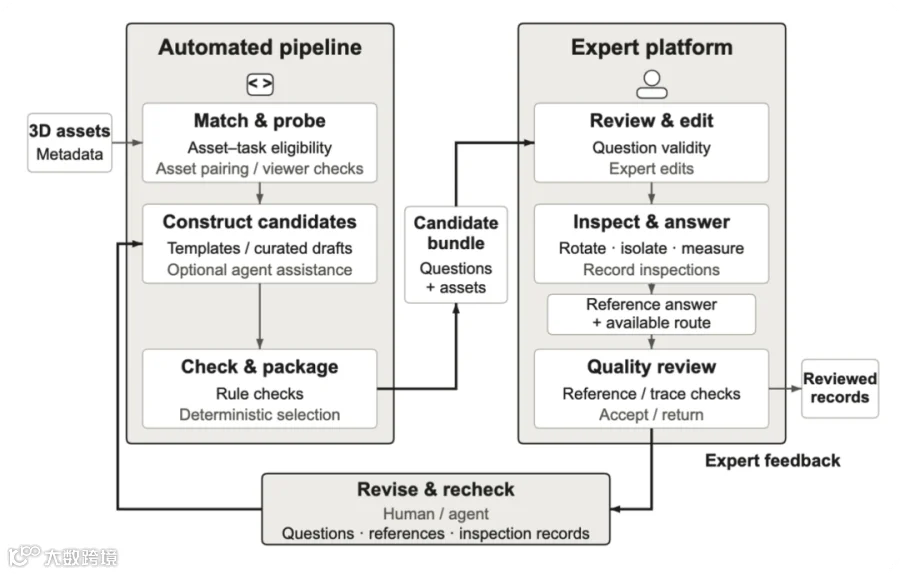
项目采用“机器出题+专家审核”的人机协作模式。UniPat AI组建了涵盖五个领域的66人专家团队,累计投入482.98小时进行审题、标注、操作记录及多轮返修。每道题均附带逐步保存的关键帧操作记录,将黑箱式的科学观察转化为可回放的过程数据。
评测结果:工具赋能效果有限,医学影像成短板
ScienceVision对比了三种证据获取方式:原始代码分析、交互工具辅助、二维渲染图识别。结果显示:
- 总分低迷:最高分仅为0.53(GPT-6-Astra + Codex),完全答对率更低。
- 学科差异:无模型五科全优。GPT-6 Astra在建筑、CAD和化学领先;Claude Fable 5.1在生物领域胜出;Claude Opus 5.5在医学影像表现最佳。
- 二维识别困难:仅凭六张固定角度渲染图,最佳模型得分仅0.30,GPT-6 Astra降至0.25。
- 工具利用不足:提供交互工具后,模型性能提升微弱(最高仅涨0.02)。即便在工具模式下,模型仍倾向于读取原始坐标文件而非进行视觉观察。
- 医学影像异常:模型操作次数是专家的三倍,但得分最低,反映出其在复杂三维医疗数据中的观察推理能力严重不足。

结论表明,当前前沿模型即便拥有充分的数据和工具支持,在面对真实科学任务时,其观察与推理能力仍有巨大提升空间。“点得多”并不等同于“会观察”。
结语:明确AI三维科学观察的能力边界
ScienceVision的独特性体现在三个方面:
- 真三维数据:基于源文件而非截图,要求模型结合领域知识进行拓扑和几何推理。
- 专家工作流工具:通过MCP开放视角切换、隔离、切片等能力,由模型自主决定观察策略。
- 统一确定性评分:跨学科使用同一套评分规则,实现公平比较。
相较于侧重可视化任务执行的SciVisAgentBench,ScienceVision更关注受领域知识约束的结构性问题。它首次在统一框架下量化了AI在三维科学观察上的能力边界,为后续模型优化指明了方向。
资源链接:
GitHub开源链接:https://github.com/UniPat-AI/ScienceVision/
Benchmark链接:https://huggingface.co/datasets/UnipatAI/ScienceVision
论文链接:https://github.com/UniPat-AI/ScienceVision/blob/main/paper/sciencevision.pdf
编辑:所罗门 桃子