

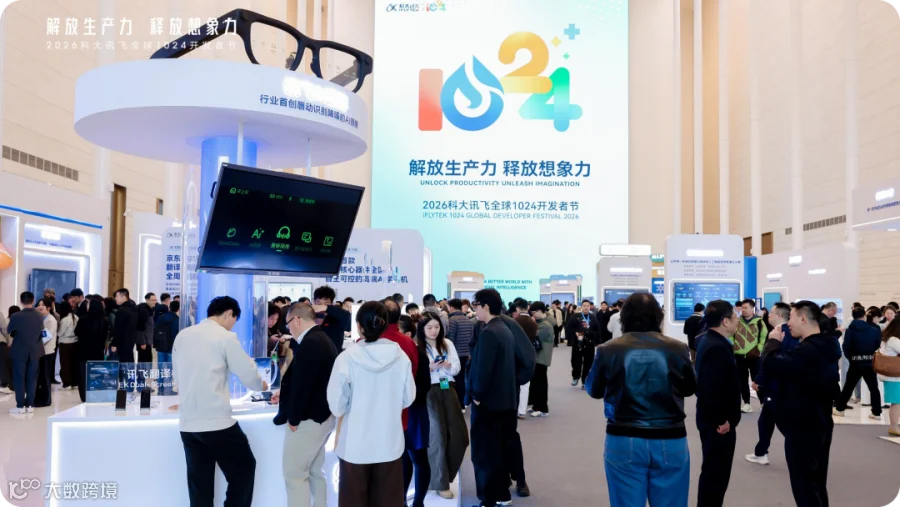
在2026科大讯飞全球1024开发者节现场,讯飞AI眼镜展位前人头攒动。即便在人声鼎沸的嘈杂环境中,仍有大量来自中东、欧洲等地的媒体和客商排队试戴,验证其在极端环境下的收音与翻译能力。
现场演示中,央视记者与精通六国语言的专家进行无障碍对话,翻译字幕实时浮现在镜片上。双方全程保持眼神交流,无需低头查看手机或屏幕,展现了该设备在跨语言沟通场景下的核心优势。
作为一款形态接近普通眼镜的智能硬件,讯飞AI眼镜如何在约40克的重量限制下,解决嘈杂环境中的“听清”、多语种环境下的“听懂”以及交互过程中的“视线维持”三大难题?以下从技术层面进行深度解析。

一、 痛点重构:从“可穿戴屏幕”到“跨语言沟通利器”
回顾2012年发布的Google Glass,其未能普及的主要原因在于缺乏刚需场景,仅作为信息显示的延伸,且受限于价格、续航及隐私争议。相比之下,讯飞AI眼镜聚焦于“跨语言沟通”这一具体痛点。
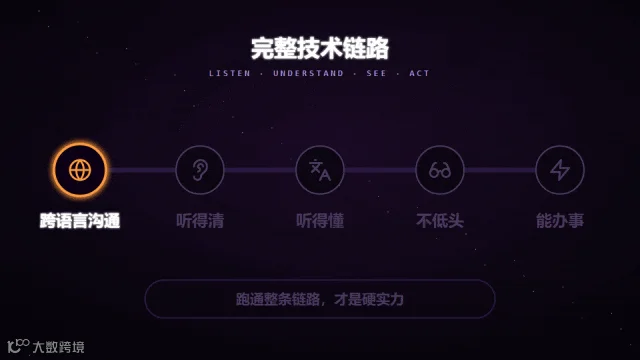
跨语言交流存在三重负担:环境嘈杂导致“听不清”、语言障碍导致“听不懂”、查阅设备导致“总低头”。讯飞AI眼镜的技术研发正是围绕解决这三大负担展开。

二、 第一关:多模态融合,用视觉辅助听觉锁定声源
在嘈杂环境中,精准拾音是准确翻译的前提。讯飞AI眼镜采用了“5+1”麦克风阵列方案:5颗气导麦克风采集环境声音,1颗骨传导麦克风采集佩戴者发声时的骨骼振动。

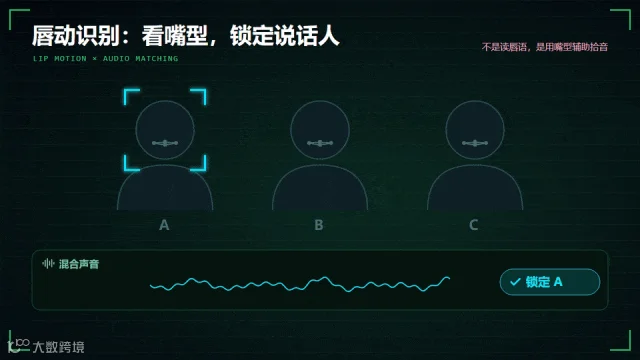
骨传导技术能有效区分“己方声音”与“他人声音”,在通话及面对面交流中提升语音分离效果。更为关键的是,系统引入了摄像头进行唇动识别降噪。
通过追踪对面说话人的唇部关键点,并与音频特征进行多模态融合分析,系统能够精准锁定正在发声的目标人物,抑制背景噪声。这并非传统的读唇语技术,而是利用视觉信息辅助声学模型,实现“看谁翻谁”的精准拾音。

三、 第二关:场景化翻译策略,支持离线与行业定制
针对不同的沟通场景,讯飞AI眼镜设计了四种差异化的翻译模式,而非单一功能的简单复用:
- 旁听同传:采用全向收音,适用于会议等长时间连续语音场景;
- 面对面翻译:采用定向收音,锁定眼前对话人,支持双向语言切换;
- 线上同传:针对远程视频会议优化;
- 通话翻译:结合骨传导拾音,支持克隆音色播报译文。
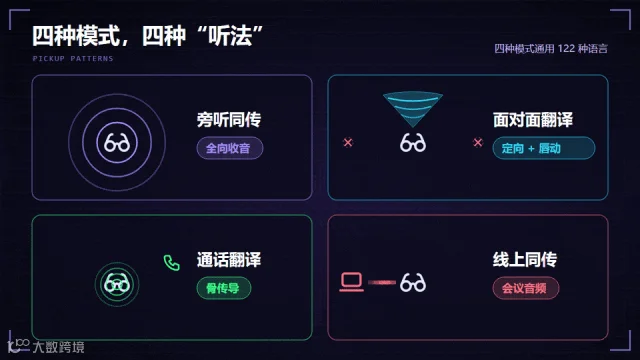

在语言能力方面,支持122种语言及方言互译。值得一提的是,面对面翻译支持离线运行,涵盖中文与英、日、韩、法、西等13种外语的双向互译,解决了海外旅行网络不稳定时的沟通难题。此外,还提供医疗、金融、法律等行业专属翻译模式及自定义词库功能,确保专业术语的准确性。
四、 第三关:工程取舍,双目单色显示实现轻量化
为解决传统翻译设备需频繁低头查看屏幕、打断目光交流的问题,讯飞AI眼镜采用光学显示方案,将字幕直接投射至镜片视野中。
技术方案上,选用Micro LED双光机作为光源,配合全贴合树脂波导技术,实现绿色文字悬浮显示。出于对功耗、发热及重量的严格控制,产品放弃了全彩显示,选择单色方案。这一工程取舍使得整机重量控制在约40克,外观接近普通眼镜,并支持近视度数定制。


五、 战略定位:具身智能的近场交互入口
讯飞AI眼镜并非孤立的硬件产品,而是其“语音交互—多模交互—具身多模交互”技术路线中的重要一环。作为最贴身的多模交互终端,它与智能座舱、机器人共享底层感知能力。
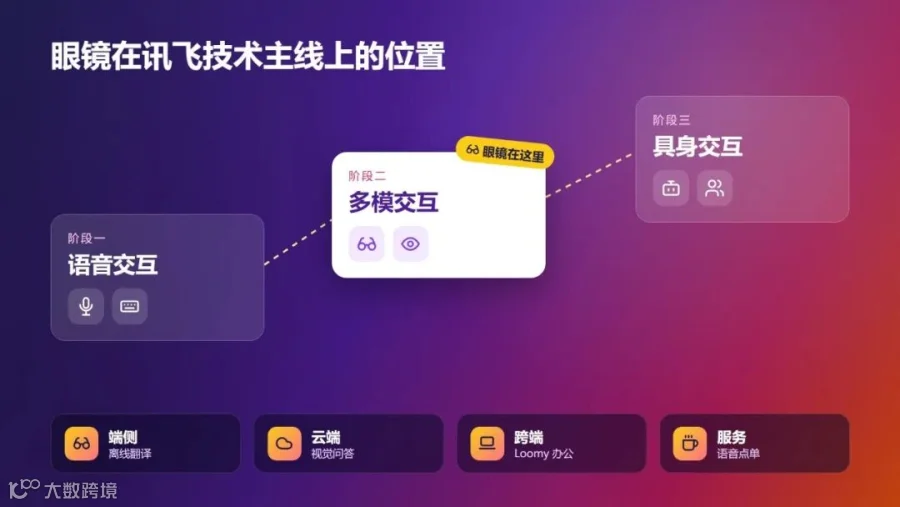
在架构上,采用端云协同模式:离线翻译在端侧完成,保障实时性与隐私;拍照翻译、视觉问答等复杂任务则调用云端多模态大模型处理。同时,眼镜可作为智能体入口,通过GlassClaw调度模式联动Loom跨端办公智能体,实现会议录音整理、图文纪要生成等自动化任务。
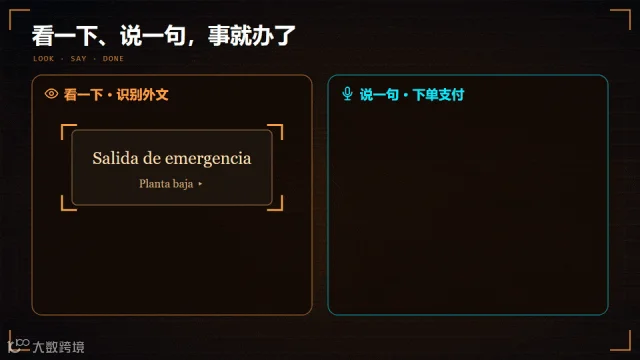
此外,设备还接入了生活服务场景,如外文标识识别解读、语音下单支付等,进一步拓展了使用边界。
结语
讯飞AI眼镜的核心竞争力在于在有限的硬件规格内,跑通了“听清、听懂、看见”的完整技术链路。依托其在语音技术及多模态领域的长期积累,产品选择了跨语言沟通这一高频刚需场景切入,体现了务实的产品逻辑。
对于商务差旅及跨国交流人群而言,该设备通过消除低头查看屏幕的动作,恢复了沟通中的眼神接触,显著提升了交流体验与信息获取效率。