


导读:Agent 评估的核心在于“结果交付”而非“语言回答”
本文基于 Anthropic 发布的《Demystifying evals for AI agents》,深入解读 AI Agent 的工程化评估方法论。核心观点指出,AI Agent 的研发模式应从传统的“模型选择-人工测试”转向“评估驱动开发(Eval-driven Agent Development)”。即通过可重复的任务、真实执行环境、多维评分机制及持续运行的评估体系,衡量 Agent 是否真正具备完成业务任务的能力。
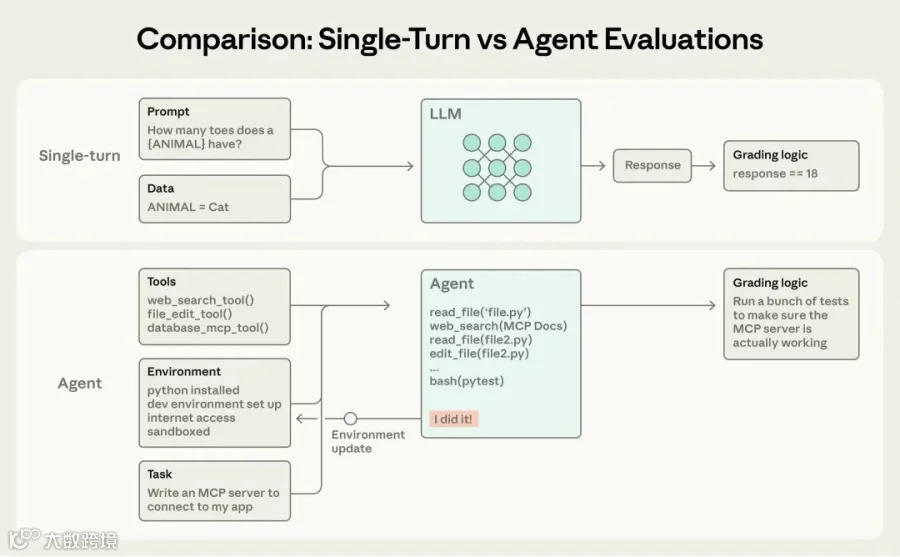
这套方法旨在解决三个核心问题:
- 如何判断模型或 Agent 是否真正具备完成特定业务任务的能力?
- 如何客观比较不同模型、架构和工作流的真实表现?
- 如何确保模型升级或配置调整不会导致业务交付质量退化?
一、Agent Eval 的定义与核心组成
传统 LLM 评估仅关注输入输出的文本匹配,而 Agent 评估需涵盖多轮交互、工具调用、环境状态改变等复杂过程。核心原则是:评价 Agent 的最终执行结果,而非仅评价其语言表达。
Agent Eval 的七个基本组成部分
| 组成部分 | 含义 | 实际作用 |
|---|---|---|
| Task | 测试任务 | 定义 Agent 需完成的具体目标 |
| Trial | 单次试验 | 一项任务的一次完整执行过程 |
| Grader | 评分器 | 判断各维度是否达到既定标准 |
| Transcript | 执行轨迹 | 记录完整的交互、调用和执行日志 |
| Outcome | 最终结果 | 验证环境中实际产生的状态变化 |
| Evaluation Harness | 评估运行框架 | 组织任务、环境、执行、评分和统计的基础设施 |
| Agent Harness | Agent 运行框架 | 负责模型调用、工具编排和 Agent 具体执行 |
注意区分:Agent Harness 侧重生产执行,Evaluation Harness 侧重验证监督。两者应相对独立但共享数据。
二、三层分级评分机制(Graders)
建议构建由代码、模型和人工组成的分层质量验证体系。
2.1 Code-based Graders:代码评分
最客观、低成本且易自动化。适用于验证确定性条件。
- 检查内容:字符串匹配、二元测试、静态分析、最终结果验证(如数据库订单生成)、工具调用验证、执行轨迹分析。
- 优缺点:快速客观,但缺乏语义灵活性,难以评估沟通质量。
2.2 Model-based Graders:模型评分
利用 LLM-as-a-Judge 进行规模化复杂质量判断。
- 检查内容:基于评分标准打分、自然语言断言、成对比较、参考答案对比、多评委共识。
- 关键点:需通过人工专家持续校准,避免“被评模型”与“评审模型”共同犯错。
2.3 Human Graders:人工评分
成本最高但不可替代,用于主观性强、高商业价值或严责任场景。
- 形式:领域专家审核、用户评价、抽样检查、A/B 测试、一致性分析。
- 定位:作为模型评分系统的校准基准,而非替代自动评分。
2.4 组合策略
建议采用混合评分逻辑:核心必要条件实行“一票否决”,其他维度加权计算。例如,图片美观度再高,若商品真实性不达标则直接判定失败。
三、能力评估与回归评估的动态循环
3.1 Capability Evals:能力评估
目标:探索 Agent 能力上限与瓶颈。
特点:选取具有挑战性的任务,初期通过率不必过高,旨在推动能力提升。
3.2 Regression Evals:回归评估
目标:确保已成熟功能不退化。
特点:通过率应接近 100%。在模型升级或 Prompt 调整后,必须重新验证基础任务的稳定性。
3.3 动态循环机制
Capability Eval 发现新能力 → 能力成熟后纳入 Regression Eval 防止退化 → 出现新需求再新增 Capability Eval。此机制平衡了创新推进与稳定性保障。
四、四种典型 Agent 的评估侧重
4.1 Coding Agent(编程型)
重点:代码运行正确性、单元测试通过、无回归破坏、安全性及资源消耗。
代表项目:SWE-bench Verified, Terminal-Bench。
4.2 Conversational Agent(对话型)
重点:任务完成度、交互质量(语气、理解力)、执行约束(授权范围内操作)。
方法:使用 LLM 模拟不同性格用户进行多轮压力测试。
代表项目:τ-Bench, τ²-Bench。
4.3 Research Agent(研究型)
重点:Groundedness(结论有可靠来源)、Coverage(覆盖关键信息)、Source Quality(来源权威性)。
代表项目:BrowseComp。
4.4 Computer Use Agent(计算机操作型)
重点:界面识别准确性、操作有效性、系统状态改变、可靠性及成本。
代表项目:WebArena, OSWorld。
五、应对非确定性:Pass@K 与 Pass^K
鉴于 Agent 执行存在非确定性,单次成功不代表稳定能力。
5.1 Pass@K:至少成功一次
公式:$P(\text{至少一次成功})$。适用于创意生成、方案搜索等允许重试的场景。随着 K 增加,通过率迅速趋近 100%。
5.2 Pass^K:全部成功
公式:$P(\text{所有 K 次均成功})$。衡量稳定性。对于面向客户的自动化服务,该指标至关重要。若单次成功率 75%,连续 10 次全成功的概率仅约 5.63%。
商业启示
需同时关注 Pass@1(首次效率)、Pass@K(最终解决能力)和 Pass^K(连续稳定性)。避免仅用高 Pass@K 掩盖高重试成本。
六、从零建立 Agent Eval 的八步路线图
阶段一:建立测试任务
- Step 0 尽早开始:小规模测试集即可提供早期信号。
- Step 1 收集真实案例:从开发手工检查、用户投诉、生产异常中提炼初始任务集(建议 20-50 个)。
- Step 2 明确标准:定义清晰的 Task Spec 和 Reference Solution,确保评分无歧义。
- Step 3 平衡覆盖:包含正常用例、边界用例、负向用例(Agent 不应做的行为)。
阶段二:建设评估运行系统
- Step 4 建立 Evaluation Harness:确保测试环境隔离、可复现、无缓存污染。
- Step 5 设计 Graders:优先代码评分,谨慎使用模型评分(允许输出 Unknown),避免过度限制执行路径。
阶段三:持续分析和优化
- Step 6 阅读 Transcript:深入分析失败原因(模型、上下文、工具或环境问题)。
- Step 7 防止饱和:当某项能力通过率达 100% 时,将其转入回归测试,并引入更复杂的挑战性任务。
阶段四:持续维护
- Step 8 长期维护:建立技术团队负责基础设施、业务专家负责任务定义的协作机制。
七、评估方法的组合:“瑞士奶酪模型”
单一评估手段存在盲区,需组合六种方法:
| 评估方式 | 核心作用 | 主要缺陷 |
|---|---|---|
| Automated Evals | 上线前批量测试 | 可能与真实场景脱节 |
| Production Monitoring | 上线后实时监控 | 滞后性,问题发生后才发现 |
| A/B Testing | 真实流量对比 | 需要足够样本和时间 |
| User Feedback | 收集长尾问题 | 数据稀疏,偏向极端情绪 |
| Manual Transcript Review | 深度诊断 | 耗时,难规模化 |
| Systematic Human Studies | 质量校准 | 成本高,周期长 |
八、推荐工具与框架
根据需求选择合适工具,切勿期待单一框架解决所有问题:
- Harbor:容器化沙箱,适合批量测试。
- Braintrust / LangSmith / Langfuse / Arize Phoenix:侧重离线评估、在线观测、Trace 追踪及数据集管理。
九、构建四层 AI 能力评估架构
将评估从单一模型扩展至商业结果,建立四层架构:
L1:Model Capability Eval(模型能力)
评估单个模型的基础任务处理能力(如识别、生成)。
L2:Agent Capability Eval(Agent 能力)
评估 Model + Harness + Tools 的组合表现,关注完整任务的稳定执行。
L3:Workflow Eval(工作流能力)
评估多 Agent、多工具及人机协作的生产流程效率与质量。
L4:Business Outcome Eval(业务结果)
评估最终商业价值,如客户满意度、复用率、单位 SKU 成本、毛利贡献等。
建议:建立 Model、Agent、Workflow 三类 Registry,实现从模型能力到业务结果的链路追踪,支持智能路由决策。
统一评估指标体系
| 指标类别 | 具体指标 | 用途 |
|---|---|---|
| 任务成功 | Pass@1, Pass@K, Pass^K | 衡量完成度与稳定性 |
| 结果质量 | 准确性、完整性、合规性 | 衡量交付标准 |
| 执行效率 | Token、调用次数、耗时 | 衡量高效性 |
| 经济成本 | 单任务成本、返工成本 | 衡量经济性 |
| 运行可靠性 | 超时率、错误率、恢复率 | 衡量稳定性 |
| 业务价值 | 验收率、复用率、毛利 | 衡量商业贡献 |
核心公式:有效交付成本 = (模型+工具+人工+返工成本) / 最终合格交付量。以此优化单位经济效益。
十、当前局限与未来方向
- 商业价值量化难:现有 Benchmark 难以直接关联 ROI,需强化 L4 评估。
- Judge 偏差:LLM 评审本身需被评估和校准。
- 平均分掩盖风险:需按类目、风险等级细分统计,避免高危领域失效被平均数掩盖。
- 多 Agent 协作评估:需进一步研究信息传递、循环调用、错误传导等复杂场景。
十一、落地建议:六阶段建设路线
- 建立测试数据资产:选取 3-5 个高价值场景,整理 20-50 个真实任务及标准。
- 建立自动化评估:接入 Code/Model Grader,记录完整 Transcript。
- 横向比较:在同一任务集上对比不同模型/Agent 的成本与质量。
- 持续回归:将成熟任务纳入 Regression Dataset,自动化监控退化。
- 连接生产反馈:将客户验收、返工数据回流至评估集。
- 智能决策:基于实测数据动态选择最优模型与工作流组合。
优先建设三类数据集
- Capability Dataset:难度递增,探索能力边界。
- Regression Dataset:历史成功案例,防止能力退化。
- Adversarial Dataset:模糊指令、错误数据等异常场景,检验鲁棒性。
十二、结语
Agent 评估的价值不仅在于研发测试,更在于指导生产决策。企业应从关注“模型Benchmark”转向“业务任务Benchmark”,从追求“单次成功”转向“规模化稳定交付”,最终实现在特定约束下创造最大商业价值的最优生产决策。