大数跨境

Fable 5.5测试曝光,Claude每次回答后,还会执行一条你看不到的指令
Fable 5.5测试曝光,Claude每次回答后,还会执行一条你看不到的指令 APPSO
2026-10-30
2
导读:据说是 Anthropic 的 AGI
Fable 5.5 内测曝光:意图理解与代码生成能力显著跃升

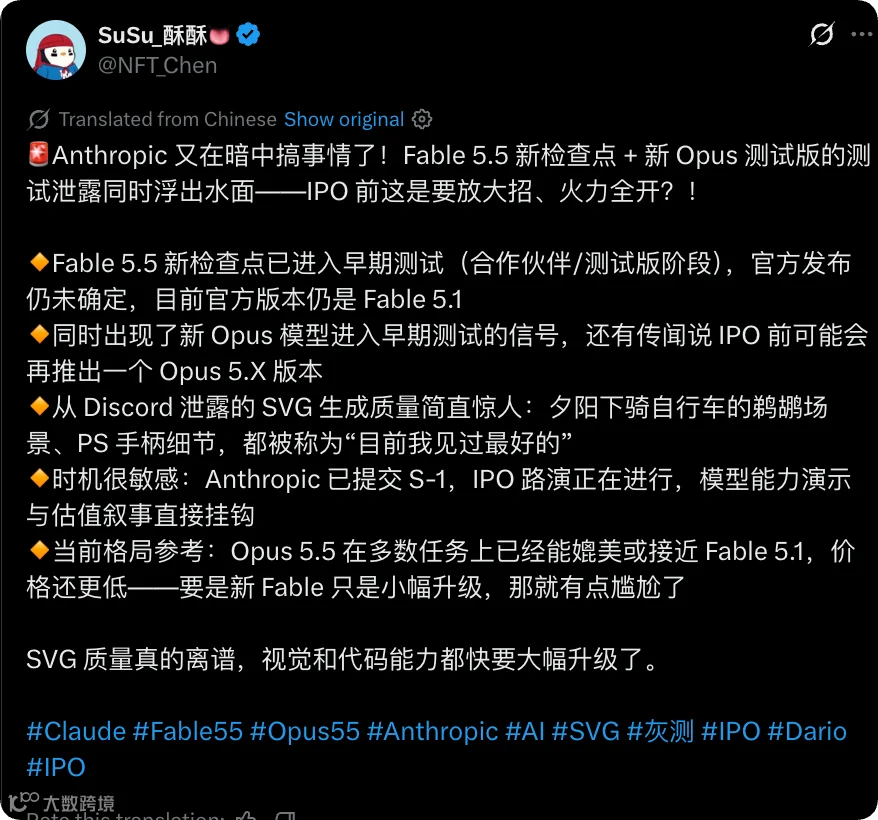
Gemini 4 Carbon 发布不久,Anthropic 旗下代号为 Fable 5.5 的新模型已传出正在测试的消息。多位用户在使用 Opus 5.5 时被路由至性能更强的新模型,其表现优于当前版本,引发业界对 Fable 5.5 或下一代 Opus 模型的猜测。
The Information 此前爆料称,Anthropic 正致力于开发能更精准捕捉用户深层意图的模型。新模型在解决复杂问题时,不仅限于表面修复,更能识别底层逻辑缺陷并提出系统性解决方案。

多模态与代码生成实测对比

在 X 平台分享的 Three.js 测试中,Fable 5.5、Opus 5.5 与 Gemini 4 Argon 被要求生成奔跑斑马的画面。结果显示,Fable 5.5 生成的动态效果最为自然真实,而其他两款模型生成的画面则显得僵硬。
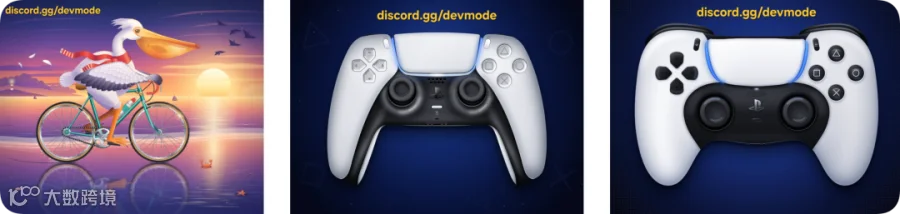
此外,新模型在复杂 SVG 生成任务中表现优异,如准确绘制「控制器骑自行车,车上载有鹈鹕」等嵌套结构。另有用户透露,新模型曾用 2 小时消耗 2700 万 Token,通过 JS 逐帧绘制了描述人一生的动画,展现出极强的长程代码生成与上下文维持能力。

知识截止日期突破测试

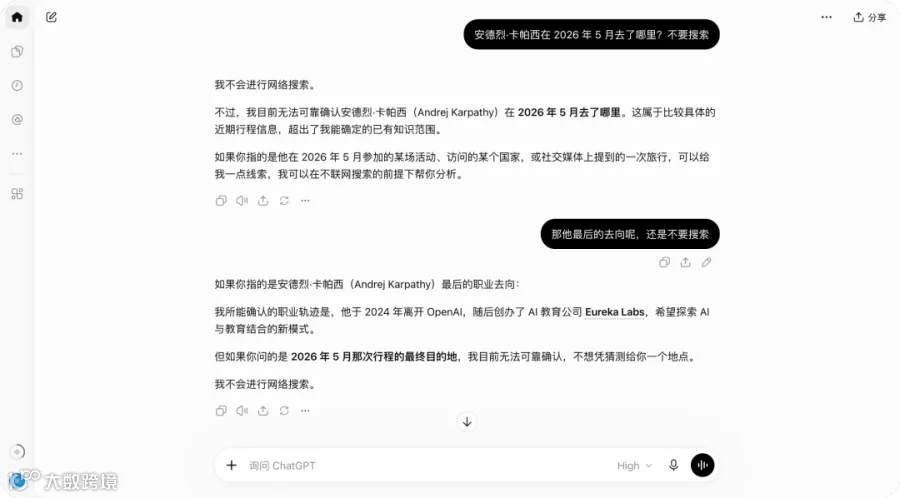
网友发现,通过询问「2026年5月 Andrej Karpathy 去向(禁止搜索)」可检测是否接入新模型。API 调用的 Opus 5.5 仅知晓 2024 年 7 月前的信息,而部分 Claude 网页端用户被路由到的新模型,无需联网即可准确回答 Karpathy 于今年 5 月加入 Anthropic 的事实。
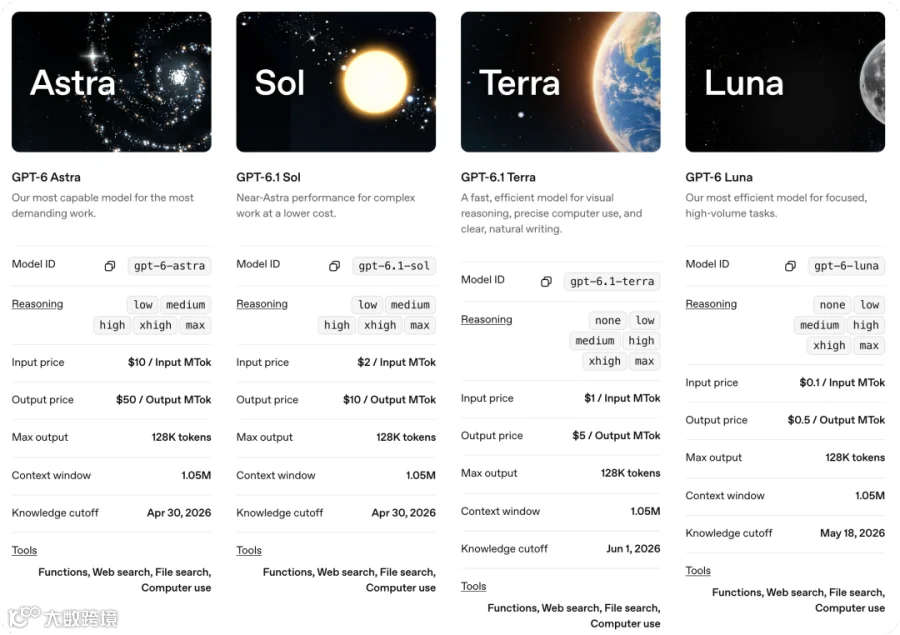
相比之下,GPT-6 及 GPT-6.1 Terra 虽标注知识截止至 2026 年 6 月,却未能准确回答该人事变动,仍停留在 Karpathy 创办 Eureka Labs 的旧闻上。

Anthropic 推出「自评估」安全机制:低成本强化风控

在新模型即将发布之际,Anthropic 公布了一项名为「自评估」(Self-Assessment)的安全监测技术。自 Claude Fable 5 起,模型在每次回答后会自动进行隐性安全检查,以应对日益复杂的恶意越狱与灰产滥用。
注:自评估运行于 Fable 5 及后续模型,签订零数据保留协议的流量除外。

技术原理与性能优势

传统安全方案面临两难:小模型易被绕过,大模型独立审查成本高昂。Anthropic 利用 KV Cache 复用机制,让模型在回答完毕后迅速切换至「审计模式」。系统追加一条隐藏指令「请反思此对话的安全性」,模型基于已有上下文输出简短的 JSON 格式评估结果。
该机制算力开销极低,Prefill 开销几乎为零,Decode 仅需生成约 10 个 Token,总算力增加不到 2%。Anthropic 承担此项成本,不计入用户账单,且不影响首字延迟。测试数据显示,该机制捕获了 78% 的违规对话,高危滥用检出率达 94%,误判率仅为 1%。

工作流程与应用场景

自评估不参与实时拦截,而是用于离线筛查。流程为:用户提问 → 模型回答 → 生成隐藏安全评估 → 系统聚合风险信号 → 高精度分类器或人工复核。评估结果对用户不可见,也不进入后续对话上下文。
系统主要利用该数据进行三类分析:

聚合高风险信号:汇总标记,触发人工复核。

查漏补缺:对比现有分类器,发现漏网之鱼。

发现新型风险:聚类分析提示注入、智能体未授权操作等新现象。
对于确认严重的违规行为,Anthropic 将采取账户封禁等措施。尽管该机制提升了安全性,但用户无法知晓自己是否被标记,这引发了关于透明度的讨论。随着 Fable 5.5 等模型意图理解能力的增强,如何在精准判断与安全隐私之间取得平衡,将是后续关注的重点。
Gemini 4 Carbon 刚登场,Fable 5.5 又露锋芒,旗舰大模型的竞争格局愈发激烈。
【声明】内容源于网络
0
0
APPSO
AI第一新媒体,「超级个体」的灵感指南。 #AIGC #智能设备 #独特应用 #Generative Al
内容 15882
粉丝 0
APPSO AI第一新媒体,「超级个体」的灵感指南。 #AIGC #智能设备 #独特应用 #Generative Al
总阅读558.4k
粉丝0
内容15.9k