

(本文阅读时间:约 30 分钟)
淘宝闪购App店铺装修展示位有限,选品需兼顾单品吸引力与多板块搭配。为解决持续自动化优选及低成本验证难题,团队构建了面向店装选品的RSI(递归自我改进)系统。该系统以Agent Loop为运行机制,通过“生成-执行-评价-更新”闭环,在有限预算内持续发现优于基线的策略,推动整店加购转化率(P2)提升。
实验数据显示,在固定预算对照中,CMA-ES算法获得更高的平均留出模型评分;一期线上AB测试8天有效观测期内,整套方案P2相对提升0.34%。本文围绕“改进对象、依据、反馈机制及验证方法”展开技术解析。
关键词:RSI;递归自我改进;店装选品;多岛进化;门控专家;反馈学习
01 业务背景与挑战
1.1 店装选品场景
淘宝闪购App进店体验由海报挂品、橱窗新品及精选推荐共同构成。店装业务分为两类:
- 氛围装修:生图生成素材,挂品关联商品以促进转化。
- 摆货策略:为橱窗、精选推荐等组件选择商品并组合,辅助用户决策。

图 1-1:消费者端展示位置及商品组合呈现
技术上,店装选品输入包括店铺上下文、候选池及装修素材,输出为带板块归属和顺序的商品组合。本项目聚焦“氛围装修挂品+摆货策略”,需解决跨板块共享供给下的视觉匹配、经营特征综合及去重约束问题。系统需分三步判断:单品适配性、商品搭配合理性及整店组合预期效果。
1.2 店装智能化演进
店装能力经历了从组件化装修、智能推荐、智能托管到AI店铺整装的演进。当前聚焦AI整装阶段的策略优化,即在已有召回与执行能力基础上,建立持续比较和更新选法的反馈机制。
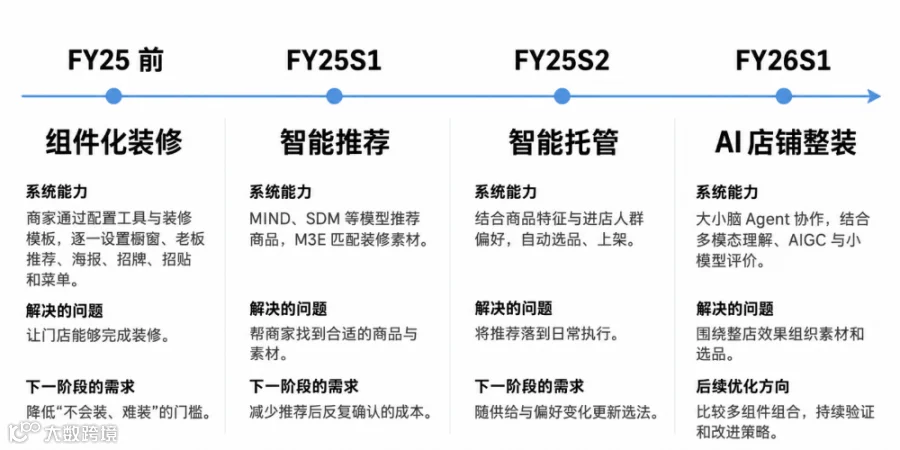
图 1-2:店装能力演进路径
1.3 策略优化难点
进入整店协同阶段后,面临三大挑战:
- 跨板块相互影响:各板块共享供给,局部最优不等于全局最优,需在容量与去重约束下评估完整组合。
- 经营环境动态变化:新品、库存及偏好迁移要求系统持续产生候选并重新评价。
- 验证成本有限:无法逐一验证所有策略,需离线筛选结合线上实验,以有限预算支持优化。
针对上述难点,系统引入进化搜索,将选法表示为可修改、执行和比较的策略。实际运行中发现,权重变化未必导致商品变化,商品更换也可能不改变模型评分。因此,设计需打通“策略调整-组合变化-效果评价”链路,确保反馈有效性。
1.4 系统改进目标
RSI系统的核心是递归关系:本轮评价反馈写入搜索分布、档案和经验,下一轮读取更新状态生成候选。Agent Loop负责执行此循环。系统包含两层调整对象:一是选品策略(权重与规则),二是搜索状态(采样分布、步长等)。反馈按两个时间尺度组织:离线内循环低成本比较选法,业务外循环通过线上实验验证效果并积累经验。
验证需逐层推进:确认反馈进入下一轮、同预算下产生更优候选、真实业务收益及多轮积累效果。
02 系统设计
系统将新品偏好、热销权重等表示为可修改策略。整体架构包含选品接口层、日滚进化层及数据基座。在线选品与日更批量共用策略产物,但日更仅重算橱窗和推荐,保留海报固定挂品。

图 2-1:选品执行、日滚进化与数据模型关系
2.1 RSI反馈循环
2.1.1 策略搜索建模
Agent Loop各环节共享决策对象与评价口径,形成递归关系:
| 循环环节 | 具体内容 | 作用 |
| 观察 | 数据窗口、基线策略、候选档案、历史经验 | 确定搜索起点 |
| 决策 | 选择父代、变异算子、步长及参数 | 提出待比较候选 |
| 执行 | 应用策略至选品器,落实约束 | 生成可执行商品组合 |
| 评价 | 构造品槽特征,计算适应度 | 提供比较反馈 |
| 更新 | 更新精英档案、搜索分布及经验 | 影响下一轮尝试 |
| 业务验证 | 冻结候选、线上AB、核对效果 | 检验真实P2收益 |
策略搜索需显式包含模型评价环节,将权重搜索与业务约束连接。设店铺上下文为$C_t$,候选池为$I_t$,固定挂品为$F_t$,参数化选品器$\pi_\theta$根据策略$\theta$生成四板块组合$L = \pi_\theta(C_t, I_t, F_t)$。策略搜索抽象为在给定评估窗口内寻找最优策略参数$\theta^*$,使适应度$f(L)$最大化。


2.1.2 行动空间
行动空间分为三层:
- 商品组合空间:最终选品及板块分配。受容量、固定挂品及去重约束,可行解数量巨大且离散。
- 策略参数空间:AI调整的变量,包括权重、幂指数、MMR系数等。当前核心变量自由度较高,但实际探索仅开放部分。
- 搜索调度空间:决定下一轮探索方式,如起点选择、变异算子、步长等。CMA-ES根据反馈更新分布,大模型可在规则基线上辅助调整。

图 2-2:策略变量与参数化选品器关系
2.1.3 多候选搜索框架
借鉴Shinka思想,采用分岛搜索与候选管理。以咖啡、西餐、甜品、饮品为业务分岛,以满足约束后的整店组合效果为评价目标,避免生成任意代码,确保业务约束在执行层落地。

图 2-3:三种迭代方式对比
2.1.4 系统运行方式
系统包含三条链路:
| 链路 | 输入 | 核心处理 | 输出 |
| 在线选品 | 店铺、资源、当前策略 | 权重选品、视觉挂品、约束分配 | 四板块商品列表 |
| 日更批量 | 已确认策略、候选池 | 确定性评分、重算、去重替补 | 当日批量结果 |
| 离线进化 | 数据窗口、评估模型、历史策略 | 生成候选、执行、评分、反馈 | 候选策略、经验记录 |
日更批量与日滚进化分别管理“商品更新”与“选法更新”,解耦线上响应与离线探索。
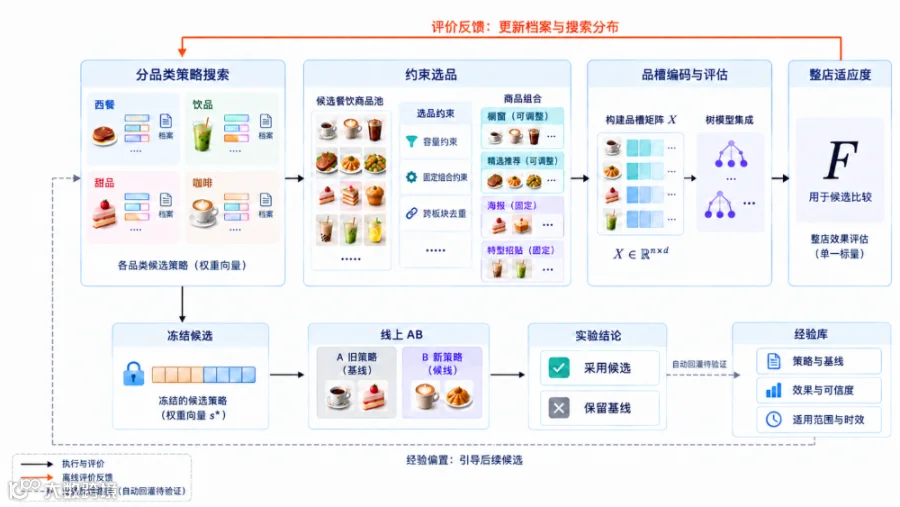
图 2-4:离线评价与线上AB反馈路径
2.2 选品策略表示
2.2.1 商品评分机制
基础商品特征包含静态属性、经营信号、图片质量等28维。离线策略参数包括板块权重、幂指数、多样性系数等。商品基础得分公式如下:

组合构造采用最大边际相关性(MMR)逐品选择,兼顾得分与多样性:
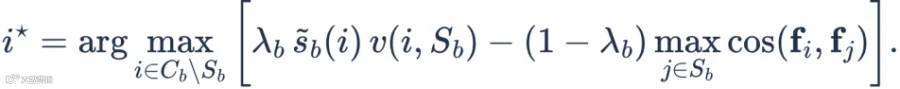
需注意,参数变化不一定引起商品变化,需关注换品比例与评估分差。
2.2.2 ILP约束分配
在线链路使用整数线性规划(ILP)处理跨板块分配,目标为最大化总评分,约束包括重复上限、容量限制及品类集中度。求解受时延限制,仅在筛选后候选集上进行。

2.2.3 离散组合的搜索特性
连续权重与离散组合间存在等价类,不同参数可能产生相同结果。搜索任务包含越过选品边界产生新组合,以及判断新组合优劣。组合变化是打分与约束共同作用的结果,非单权重局部函数。
03 评估模型
评估器负责将选品结果转化为可用反馈,需具备预测合理效果及区分局部换品差异的能力。
3.1 候选区分能力
针对同店相近方案的区分难题,从三个维度检查评估器:
| 维度 | 检查问题 | 典型指标 |
| 数值拟合 | 是否准确预测店铺日表现 | MAE、R²、校准误差 |
| 换品敏感性 | 组合改变后是否有响应 | 有效换品同分率、预测差分布 |
| 候选排序 | 是否正确排列候选优劣 | 两两排序准确率、方向准确率 |
3.2 模型结构
3.2.1 评估架构迭代
历经三代演进:
- 第一代(Baseline + Residual):拆分店铺基础与选品影响,但聚合特征削弱了少量换品差异。
- 第二代(Slot Model):按板块展开单品特征,提高组合差异可见性,但全域回归器在样本密集区区分力不足。
- 第三代(Slot Expert):引入门控与稠密域专家,增强关键区间区分能力。
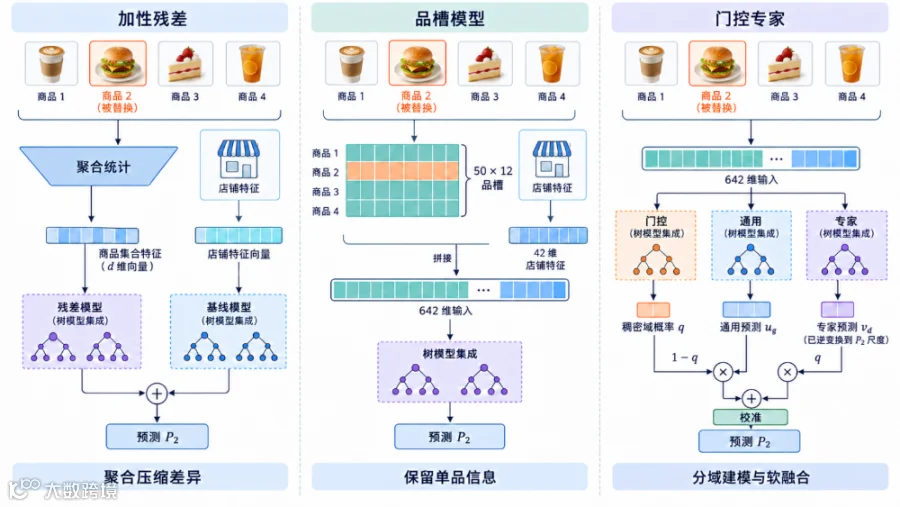
图 3-1:三代评估器架构对比
3.2.2 品槽特征表示
输入包含50个品槽位置(每槽12维商品特征)及42维店铺上下文。品槽按板块销量排名填充,保留板块结构。训练侧支持板块内顺序增强以减弱位置依赖。
3.2.3 门控专家设计
通用回归器负责整体,稠密域专家细看特定区间,门控决定融合比例。推理时门控预测落入稠密域概率$q$,通用与专家输出经逆拉伸和单调校准后融合:
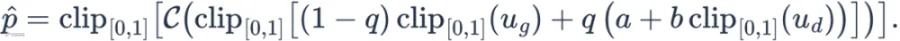
图 3-3:门控专家结构示意

3.3 模型训练验证
3.3.1 训练目标
采用均方误差与RankNet组内排序联合目标,既约束数值尺度,又鼓励正确排序。候选组围绕同一原始样本构造,包含顺序增强与商品扰动。

3.3.2 专家融合敏感性
门控专家组合预测的一阶变化揭示三条响应路径:通用模型响应、专家响应或门控权重调整。评估时需同时观察各路输出及校准结果,定位同分原因。
3.3.3 模型验证指标
Slot Expert架构在留存测试中R²提升至0.2341,MAE降至0.1166。固定边界模型换品专项测试显示,多数有效替换可引起预测变化,校准后同分率为7.12%。
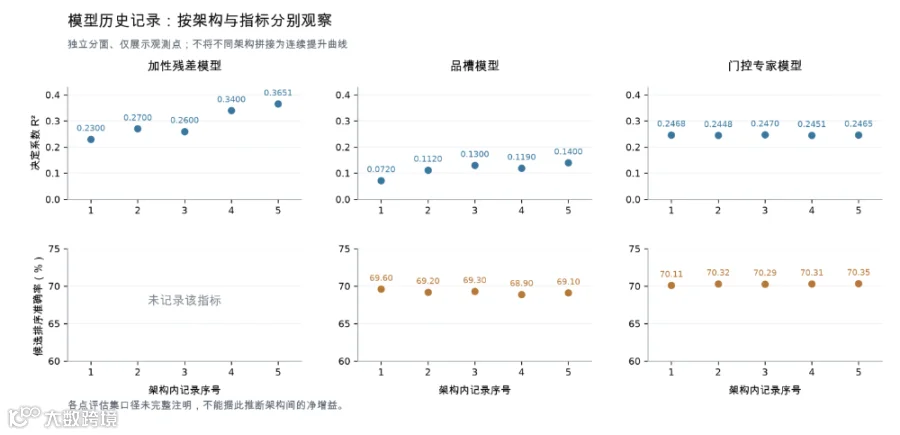
图 3-4:三代架构历史记录
04 多岛进化
4.1 单代进化流程
多岛进化承担离线更新,每代经历观察调度、生成候选、执行评价、筛选学习及记录衔接五个阶段。关键在于评价执行约束后的最终组合,确保反馈与实际执行一致。

图 4-1:候选生成与反馈流向
4.2 候选生成机制
4.2.1 CMA-ES分布更新
CMA-ES在权重对数比值空间采样,经softmax归一化及有界投影得到可用参数。采用对角协方差形式,根据适应度排名更新均值、步长及采样尺度,适合处理“参数连续、组合离散、反馈不可微”的优化结构。
4.2.2 多岛候选管理
- 品类分岛:各品类独立维护搜索状态,避免主导效应掩盖其他品类有效方向。
- 精英档案:保存有限数量高分候选作为复用起点,设置入档门槛减少噪声干扰。
- 跨岛迁移:按相似度分级融合权重,迁入策略需在目标岛重新评价验证,防止低质量传播。
4.3 适应度反馈
4.3.1 适应度计算
提供直接评分与同日基线差分两种模式。启用多目标时,融合组合多样性与约束衰减项。同日静态基线可减弱大盘波动干扰,但非随机对照实验。
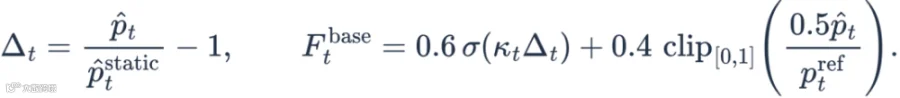
4.3.2 跨板块联合反馈
橱窗与推荐分别维护CMA-ES状态,但生成配对策略,执行跨板块约束后用同一适应度更新两组分布。这保证了反馈目标与业务决策一致,但也带来归因难题。
05 搜索调控
搜索调控决定后续探索方式,包括自适应调度与经验引导。
5.1 自适应调度
5.1.1 搜索生命周期
控制拆分为两层:生命周期控制判断启停与实验准入;逐岛调度决定具体探索方式。停止搜索、建议实验、批准发布为三个独立判断。
5.1.2 大模型调度边界
规则先给出可执行基线,大模型在满足条件时补充受限调整建议(步长倍率、算子模式等)。输出经代码校验后执行,未调用或失败时沿用规则。普通候选评价与大模型调用解耦。
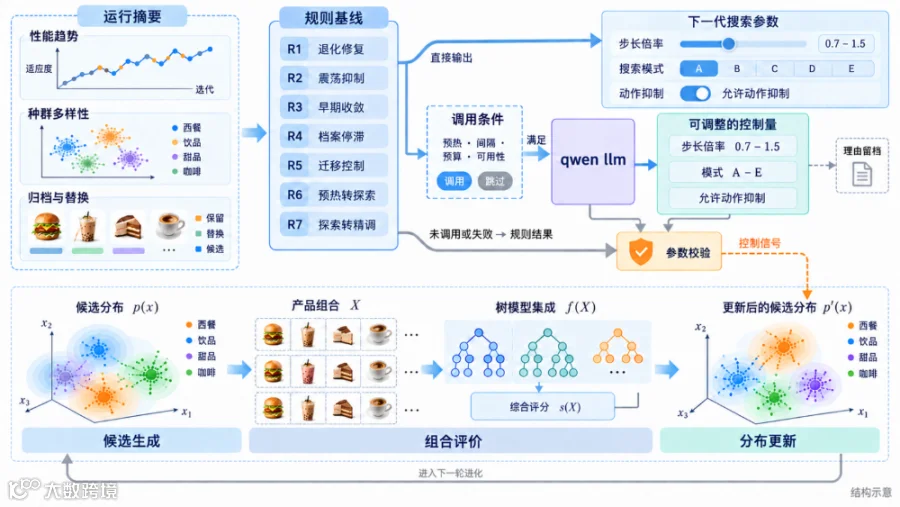
图 5-1:规则与大模型调度边界
| 规则 | 主要观测 | 动作意图 |
| R1:退化修复 | 距峰值差距、下降趋势 | 重启分布,扩大探索 |
| R2:震荡抑制 | 较大波动、趋势平坦 | 收缩步长,定向搜索 |
| R3-R7 | 收敛、停滞、迁移等状态 | 精调、清理、保护等 |
5.2 经验引导
5.2.1 经验时效管理
经验来源包括离线评估(反馈密集但有偏差)与真实AB(证据直接但滞后)。采用代际与幅度双因子衰减管理时效,置信度作为启发式权重而非因果置信度。
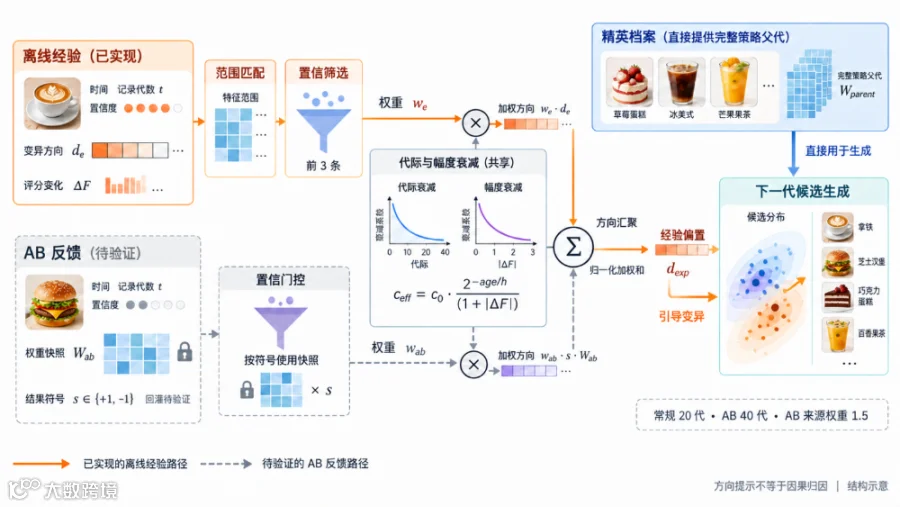
图 5-2:经验汇聚与偏置生成
5.2.2 经验偏置生成
将经验保存为结构化方向,按衰减权重汇聚为偏置。AB经验使用独立半衰期和更高来源权重。经验偏置改变候选生成倾向,与保存完整策略的精英档案互为补充。
5.3 业务反馈回灌
线上实验结果经筛选、衰减后汇入经验库,影响后续候选生成。历史策略需在新数据窗口重评,不能直接继承收益。
06 反馈失效诊断
当参数改变未换品或换品后预测同分时,需逐层排查信号压缩点:
- 参数层:检查采样变换与投影后实际权重是否真变。
- 得分层:检查商品评分间隔是否被压缩。
- 组合层:检查约束是否导致唯一可行解。
- 输入层:检查模型输入特征是否随商品替换而变。
- 预测层:检查树模型分段或校准平台是否抹平差异。

图 6-1:信号压缩机制示意
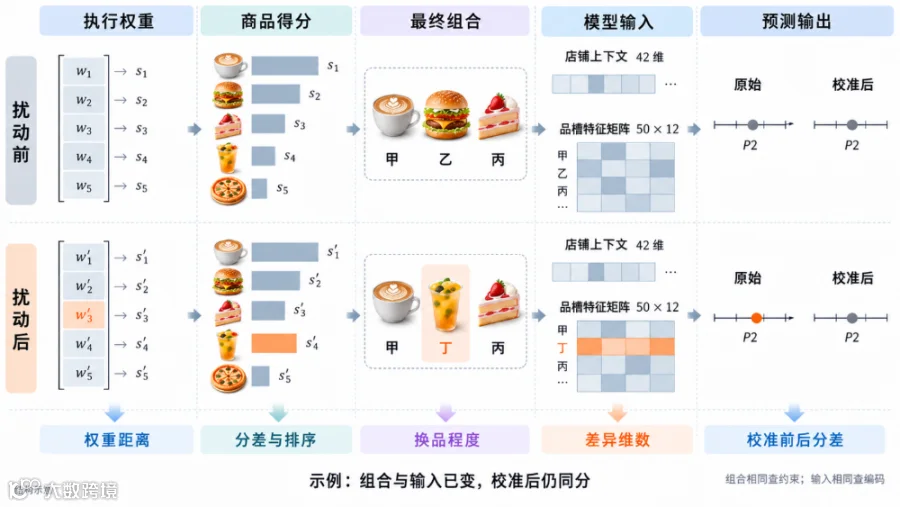
图 6-2:五层结果对齐检查示例
07 实验验证
7.1 离线对照实验
7.1.1 多岛运行观察
四品类60代搜索验证了全链路运行。各品类适应度均有提升,导出权重可形成业务假设,但需进一步检验稳定性。

图 7-1:四品类跨代适应度变化
7.1.2 优化器对照
CMA-ES与固定分布随机搜索对照显示,在相同预算下,CMA-ES留出评分增量显著优于随机组(差值+0.003557,95%区间[+0.002089, +0.005234])。但在达到早期门槛速度上无优势。
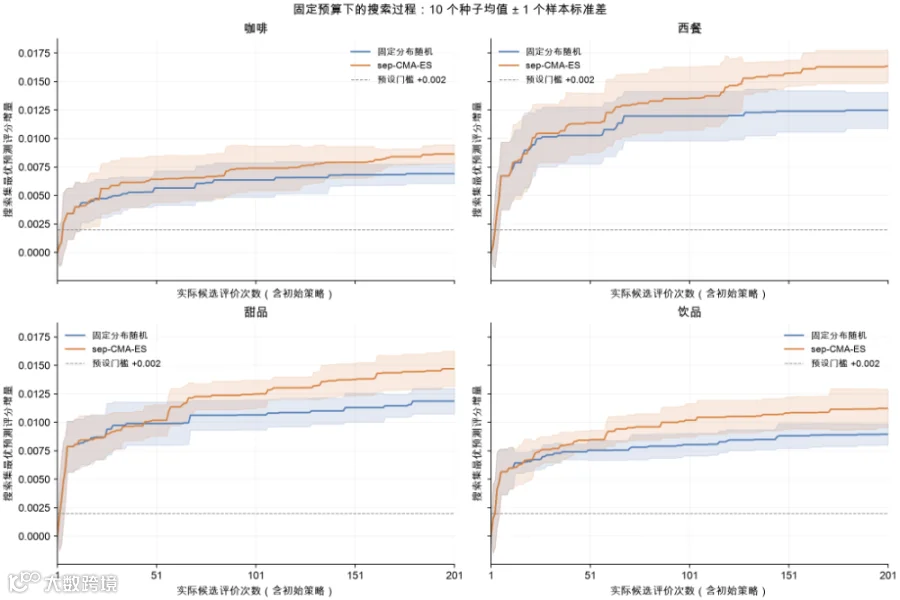
图 7-2:随机搜索与CMA-ES对比曲线
7.1.3 专家边界对照
自动边界实验虽提升了部分指标,但验证集排序提升未达门槛且分区误差恶化,故未采用。表明模型更新需满足联合验收条件。
7.1.4 搜索框架对照
旧版框架对照存在适配器与特征口径限制,正进行统一标准复验。有效对照需记录独特候选数及实际评价次数。
7.2 线上AB实验
首轮线上AB覆盖四类目约四万家店,50:50分流。8天有效观测期内,实验组整店P2相对提升0.34%(p=0.0389),访问下单率提升0.46%,进店下单转化率提升0.44%。该结果为阶段性正向证据,长期收益仍需持续验证。
7.3 机制消融设计
后续需通过状态继承与重置对照、经验打乱等方式,逐项检验品槽专家、反馈更新、联合反馈、经验引导及大模型调度的独立贡献。
| 设计问题 | 保持不变条件 | 主要比较 | 观察结果 |
| 品槽与专家区分力 | 时间切分、标签口径 | 聚合vs品槽vs门控专家 | 排序、同分率、分区误差 |
| 反馈更新价值 | 初始分布、评估器 | 随机采样 vs CMA-ES | 留出评分、有效组合数 |
| 联合反馈效果 | 候选池、约束规则 | 分别优化 vs 整店联合 | 整店评分、覆盖与重复 |
| 经验增量信息 | 起点、数据、种子 | 无经验 vs 离线 vs 双来源 | 搜索质量、稳定性 |
| 大模型调度性价比 | 规则基线、预算 | 纯规则 vs 受限LLM | 留出质量、耗时、回退率 |
08 总结
淘宝闪购店装RSI系统通过Agent Loop实现策略与搜索状态的递归自我改进。核心技术设计包括:将跨板块选品建模为可执行策略搜索、构建具单品分辨率的门控专家评估器、以及通过受限接口让反馈影响下一次搜索。
实践表明,搜索能力受整条反馈路径约束。未来工作将围绕策略推广、候选区分、机制贡献归因及持续闭环验证展开。RSI的价值取决于反馈能否转化为可验证的下一次改进,需确保每次更新有对象、每条反馈有去向、每项收益有独立验证。
感谢李哲、贺永明、崔智恒在项目实践中的指导,杨宇、柴绪顺在工程实现上的支持,张海锋在业务方面的协助,以及俞秀娟、朱翔、杨雨萌在生图素材方面的贡献。
参考文献
