这是2026年的第 73 篇文章
( 本文阅读时间:约 20 分钟 )
导读:大模型时代的翻译技术路线之争
在大模型时代,经过专项训练的翻译领域模型是否会被通用大模型取代?面对复杂翻译需求,应持续优化单体模型的翻译质量与指令遵循能力,还是通过多模型协同的 Agent 系统汇集不同模型的优势?阿里 MaaS 团队在 WMT26 的实践为这些问题提供了参考:Qwen-MT-Lumen 以 14B 翻译主模型在受限赛道取得领先表现,展示了翻译领域模型的价值;Wayfinder 则通过多模型协同取得整体最佳表现,体现了 Agent 在复杂翻译任务中的潜力。两条路线的成绩说明,通用大模型能力的增强并未消除翻译领域模型的价值,模型优化与系统协同均是提升翻译质量的有效路径。
本文将介绍 ATH MaaS 联合 Qwen 团队面向 WMT26 定制的这两套参赛系统:Qwen-MT-Lumen 通过多语言持续预训练、翻译专项指令训练、Online M²PO 和 OPD,提升受限规模下的翻译质量与指令遵循能力,并结合结构感知推理与选择性修复保障输出完整性;Wayfinder 通过文档级候选聚合、匿名化选择或受约束改写,以及异常检测与修复,整合不同模型在语言表达、领域适配和约束遵循方面的优势。相关技术已服务于实际业务,基于同一技术体系的 Qwen-MT 系列已上线阿里云百炼,覆盖文本、图像、文档及实时语音翻译,并通过 Aidge、万镜一刻等云产品应用于电商出海、漫剧出海等场景。
相关链接
-
Qwen-MT-Lumen 论文地址: https://www2.statmt.org/wmt26/pdf/2026.wmt-1.81.pdf -
Wayfinder 论文地址: https://www2.statmt.org/wmt26/pdf/2026.wmt-1.78.pdf -
WMT26 官方报告: https://www2.statmt.org/wmt26/pdf/2026.wmt-1.48.pdf
背景:机器翻译的技术趋势与 WMT26 挑战
机器翻译的技术趋势与应用现状
大模型时代,机器翻译的主流技术路线已经从传统神经机器翻译(NMT)转向基于大语言模型(LLM)的翻译,任务要求也从句子级语义转换扩展到文档级理解与指令遵循。与此同时,智能体(Agent)翻译受到更多关注,通过多模型协同、候选选择与迭代修订,探索提升翻译质量的新路径。模型优化与智能体协同,正在成为应对复杂翻译需求的两个重要方向。
与这一趋势相对应,翻译在阿里集团内外的应用正逐步覆盖多模态场景并深入行业需求。Qwen-MT 系列已覆盖文本、图片、语音、视频及同声传译等场景,提供通用的全模态翻译能力。在电商出海领域,Qwen-MT 支持 Aidge 打造适配行业需求的专用模型;面向短漫剧翻译,则与万镜一刻结合,针对上下文衔接、角色语气和表达风格优化模型能力。随着业务需求日益复杂,PDF 商品说明书等文档翻译任务不仅需要准确传达语义,还需兼顾术语一致性、内容完整性与版式保留,推动翻译模型与处理流程持续优化。
WMT26 通用机器翻译任务与技术挑战
WMT(Conference on Machine Translation)是机器翻译领域具有广泛影响力的国际学术会议,其年度评测为比较翻译系统能力、观察技术进展提供了重要基准。WMT26 的通用机器翻译任务(General MT Task)设置受限与非受限两类赛道:受限赛道要求最终系统的模型总参数量少于 20B,并按规定开放模型权重,训练或蒸馏等中间阶段可使用更大模型;非受限赛道不限制模型规模、训练数据和许可方式,可使用闭源模型与商业 API。两类赛道均允许多模型流程,但受限赛道需满足参数量合计限制。
本届比赛采用完整的文档级输入,并将自然语言指令纳入翻译上下文,既考查译文的忠实度与流畅度,也关注指令遵循、上下文一致性和结构保留。测试数据覆盖新闻、社交与用户生成内容、语音、软件、教育和事实核查六类领域,涉及 23 个翻译方向,包括若干低资源语向。评测以人工评价为核心,将同一原文的三份译文并排呈现,由评审标注错误片段并评分;同时采用动态评测机制,为表现较好的系统分配更多评测样本,提高领先系统之间比较的可靠性。这些设置对系统的多语言覆盖、文档级处理及复杂约束遵循能力提出了更高要求。
从业务锤炼到赛场检验:MaaS 团队的 WMT26 实践
依托阿里集团内外翻译业务的实践积累,MaaS 团队围绕 WMT26 的任务要求,联合 Qwen 团队构建了 Qwen-MT-Lumen 与 Wayfinder 两套参赛系统,分别探索模型优化与智能体协同两条技术路线。Qwen-MT-Lumen 以 Qwen3-14B 为基础,通过多语言持续预训练、翻译专项指令微调、Online M²PO 与 OPD,提升翻译质量与指令遵循能力,并结合结构感知推理与选择性修复保障输出完整性;Wayfinder 则聚合多个模型的文档级候选译文,通过匿名化选择、受约束改写及异常检测与修复,发挥不同候选的互补优势。两套系统共同应对多语言、跨领域和复杂指令约束下的翻译挑战,为不同资源条件下的技术选择提供实践参考。

Qwen-MT-Lumen: 受限规模下的翻译质量与指令遵循优化
任务挑战:兼顾翻译质量与指令遵循
通用大语言模型在机器翻译中仍面临两类挑战:一是多语言能力不均衡,尤其在低资源及区域语言上存在不足;二是难以同时保证翻译质量与复杂指令遵循,译文除了准确、完整、流畅,还需满足术语、语体、风格和格式等约束。

方案解析:翻译质量与指令遵循的多阶段增强
面对上述挑战,我们构建了 Qwen-MT-Lumen,一款基于 Qwen3-14B-Base、针对翻译质量与指令遵循进行专项优化的多语言翻译模型。整体流程分为四个阶段:首先,通过多语言持续预训练(CPT)加强语言与领域覆盖[2],重点补强低资源及区域语言,再通过监督微调(SFT)混合平行翻译、通用指令与翻译专项指令数据,增强翻译基础与约束遵循能力[3,4,5];其次,采用 Online M²PO,从当前模型采样候选译文,利用评审模型的质量评分构建多对偏好监督,优化翻译质量;随后,通过 On-Policy Distillation(OPD),在学生模型生成的轨迹上迁移 Qwen3-32B-Instruct 教师模型的指令遵循能力,保留 14B 翻译主干[6];最后,结合结构感知推理与规则校验,保留 HTML、JSON 等结构及受保护内容,并对明确异常进行规则修复或调用 Qwen3.5-4B-Instruct 定向重生成,提高输出完整性与格式可靠[7,8,9]。
在上述流程中,Online M²PO 与 OPD 分别侧重翻译质量优化和指令遵循能力增强,下面重点介绍这两个模块的设计与实现。

Online M²PO:面向翻译质量提升的在线多对偏好优化:在 CPT 与 SFT 的基础上,我们进一步通过强化学习优化译文的准确性、完整性与流畅度。为此,我们将此前在 ACL 2026 提出的 M²PO(Multi-Perspective Multi-Pair Preference Optimization)扩展至在线训练:持续从当前模型采样候选译文,通过质量评估构造多组偏好对,使偏好监督随模型更新,针对当前输出中的问题进行优化。

对每个输入
其中
随后按
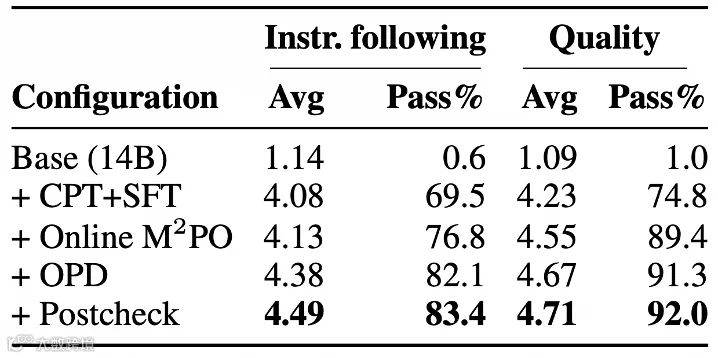
在线候选生成与多对偏好监督共同构成“生成—评估—更新”的训练闭环。累积消融显示,加入 Online M²PO 后,翻译质量平均分从 4.23 提升至 4.55,而指令遵循平均分从 4.08 提升至 4.13,其主要增益体现在翻译质量上。
OPD:面向指令遵循能力增强的在线策略蒸馏
Online M²PO 主要通过翻译质量奖励优化语义忠实度与表达质量,对术语、语体和输出格式等细粒度指令的覆盖仍不充分。为进一步增强指令遵循能力,我们引入 On-Policy Distillation(OPD),将 Qwen3-32B-Instruct 的指令遵循能力蒸馏至经过前述训练的 14B 翻译模型,蒸馏过程中教师参数保持冻结。OPD 的核心是由学生生成译文,教师沿同一条学生轨迹提供逐 token 的概率分布监督。与使用预先生成的教师答案进行训练相比,这种方式使监督与学生当前的生成分布保持一致,更有针对性地指导其后续生成。具体到翻译场景,对输入
教师仅在训练时提供监督,翻译推理仍由 14B 学生承担,将更大模型的指令遵循能力迁移到较小主模型中。累积消融显示,OPD 将指令遵循平均分从 4.13 提升至 4.38,同时将翻译质量平均分从 4.55 提升至 4.67,体现了它与质量偏好优化的互补作用。
结果分析:专项优化模型的收益与能力边界
WMT26 官方评测结果中,Qwen-MT-Lumen 在受限赛道的 23 个翻译方向中,有 20 个进入统计并列领先组(top cluster);在包含非受限系统的整体比较中,有 13 个方向进入该领先组。这表明,以翻译质量优化与指令能力迁移为核心的专项训练,能够使 14B 翻译主模型取得有竞争力的表现。Qwen-MT-Lumen 的实践验证了单模型专项优化的价值,但在不同领域、语体和结构约束下,单一模型仍难以持续兼顾语义忠实、表达质量与指令遵循。下一章将以 Wayfinder 为例,探讨如何通过文档级候选比较与受约束修订,发挥不同模型的互补优势,进一步提升翻译质量与可靠性。
Wayfinder:面向复杂翻译任务的多模型协同 Agent
任务挑战:从单模型生成到多模型智能体协同决策
WMT26 将翻译任务扩展为带有自然语言指令的文档级处理,系统不仅要准确传达原文含义、保持文档上下文的一致性,还需遵守领域语体和输出结构要求。例如,软件本地化既要译对界面文本,也要保留 JSON 键名和占位符;包含 HTML 标记的文本则需要维持结构完整,避免译文内容正确却无法直接使用。因此,生成流畅译文只是任务的一部分,系统还需要判断译文是否忠实于原文、符合指令,并保留必要的结构[10]。
单个模型也难以在所有文档上持续提供最佳结果。Wayfinder 的候选分析发现,四个基础系统均能贡献优质译文,没有一个系统占据绝对优势。因此,对于兼具文档上下文、领域术语、语体和格式约束,且允许投入更多推理资源的任务,Agent 可以通过比较候选、识别缺陷和选择处理方式,发挥不同模型的互补优势[11,12,13]。

基于这一思路,Wayfinder 将原文、指令和多个候选译文组织为文档级决策信息:已有候选满足要求时直接保留;候选各有所长且有明确改进空间时,以一份译文为主稿进行受约束改写;检测到结构损坏、截断或重复等严重问题时,再判断是否需要定向修复,对误报则保持译文不变。其目标是在保留优质候选的基础上,弥补内容和约束遵循方面的缺陷,同时减少不必要的改写带来的退化。
方案解析:多模型协同与译文质量控制

文档级候选聚合,为 Agent 提供统一的决策材料。 Wayfinder 为每份文档获取来自四个基础系统的候选译文,并将其与原文、自然语言指令及目标语言信息汇集为统一的文档级记录。评审模型在同一次比较中对四份候选先排序、再给出与排序一致的分数,为后续决策提供参考。候选分析显示,不同基础系统各有表现较好的文档,没有一个系统全面占优;但评审分数并非最终裁决,译文仍需依据原文和任务指令判断。
匿名化选择与融合改写,将候选优势转化为最终译文。在选择阶段,Wayfinder 将候选来源模型映射为 A/B/C/D,并使匿名标签在译文、排名和分数字段中保持一致,以减少模型来源对决策的干扰。选择或改写 Agent 综合检查语义忠实度、指令遵循和结构约束:如果已有候选满足要求,就原样采用;如果候选各有所长且存在明确改进空间,则以一份候选为主稿,参考其他译文进行受约束的改写。这种“能选则选、必要时才改”的方式,旨在利用多模型的互补性,同时降低改写优质译文的风险。
保守后检查,针对明确缺陷实施最小必要修复。 得到译文后,系统重点识别截断、重复、非目标语言文本残留、空输出、行数不符及 JSON 格式异常等严重问题。对于修复方式明确的机械性缺陷,例如可恢复的分隔符错误,优先采用规则修复;对于大段遗漏、错误语言输出或造成内容损失的结构问题,则由修复 Agent 结合原文、指令和原始候选进行定向处理。修复后系统会再次检查;如果判断为误报,则保留原译文,避免无必要的润色。
评审驱动迭代,在开发阶段持续优化系统配置。Wayfinder 以一个较强的单模型译文作为固定基线,使用评审模型对其与 Wayfinder 的输出进行成对比较。针对失利及部分低置信度平局的文档,系统分析失败原因,据此调整选择与改写提示词、后检查规则或修复约束,再有选择地重跑疑难文档;表现满意的结果则继续保留。这一反馈循环优化的是 Agent 决策与质量控制流程,不涉及底层模型权重更新。
结果分析:多模型协同的收益与局限
WMT26 官方评测结果中,Wayfinder 在 23 个翻译方向中的 17 个进入第一梯队,覆盖方向数高于 Gemini 3.1 Pro 的 15 个,整体表现最佳这一成绩展现了多模型协同在复杂文档翻译中的潜力:通过按文档比较候选、审慎选择或改写,并对严重异常进行后检查,Wayfinder 能够整合不同模型的优势,形成具有跨语言竞争力的最终译文。开发阶段的内部评测进一步展示了这套流程的运行效果:在覆盖 28 个方向、19,880 份文档的自动评测中,Wayfinder 相对 GPT-5.5 单模型基线取得 65.37% 的加权胜率指标。在英语→简体中文方向,后检查改变了 945 份输出中的 31 份(3.3%);早期开发运行中,选择性重跑使进入后续轮次的文档量减少约 60%。上述结果采用内部评测口径,与官方人工评测不同,也不代表各模块的独立贡献。
多模型协同也有相应局限:每份文档需要先生成四份候选,还可能产生评审、选择、修复及重跑调用,因此成本和时延高于单模型翻译。系统也受候选池质量限制——如果多个候选都遗漏同一信息或误解同一语义,选择与融合未必能够可靠纠正。未来的优化重点是以更少的候选和评审调用维持选择质量,并更准确地触发必要修复,在翻译质量、处理时延和调用成本之间取得平衡。
总结与展望
观察1. 翻译领域模型仍具备竞争力与应用价值
WMT26 的结果表明,经过定向优化的翻译领域模型,能够以较小的参数规模取得有竞争力的表现。Qwen-MT-Lumen 以 14B 翻译主模型,在受限赛道的 23 个翻译方向中,有 20 个进入第一梯队,体现了专项训练的价值。通用大模型翻译能力的增强,并不意味着翻译领域模型会被取代。通过将翻译知识与指令遵循能力内化到模型中,翻译领域模型有望在翻译效果、部署成本与服务时延之间取得更好的平衡,满足高频、规模化的业务需求。
与头部通用大模型相比,Qwen-MT-Lumen 在英语至日语、俄语、哈萨克语和亚美尼亚语等方向的官方人工评分均高于图中其他模型。按 23 个语向得分等权计算,Qwen-MT-Lumen 的平均分为 74.82,与 GPT 5.5 的 74.23、Gemini 3.1 Pro 的 76.08 处于相近水平,进一步体现了翻译领域模型的质量竞争力。

观察2. 翻译领域“模型与Agent”的选择取决于任务需求
在全部系统的比较中,Wayfinder 有 17 个翻译方向进入第一梯队,官方报告将其评为整体表现最佳的系统,展示了多模型候选整合、受约束改写与异常校验的价值。结合 Qwen-MT-Lumen 的成绩可以看出,专用模型通过定向训练增强自身能力,Agent 则通过系统编排发挥不同模型的互补优势。两条路线均具备竞争力,具体选择需要综合考虑质量要求、资源预算、时延与部署条件。
观察3. 指令遵循、输出忠实度与低资源语言覆盖仍是翻译迈向成熟应用的持续挑战
WMT26 也反映出翻译技术仍需持续解决的问题:在准确、流畅地传达原文之外,系统还需稳定遵循术语、语体和格式等指令约束。例如,在要求同时输出阳性与阴性形式的专项测试中,部分系统倾向于遵循要求,另一些系统则从不或很少生成指定形式。输出可靠性同样需要关注:在针对幻觉与过度生成的挑战集中,许多基线大模型超过 50% 的片段被标记,多数参赛系统则低于 5%,提示质量检查与过滤机制的重要性;这一比例仅反映特定挑战集上的表现,并非日常翻译错误率。低资源语言仍存在明显差距:英语至拉定语和利古里亚语的最佳机器系统得分分别为 49.4 和 66.0,低于人工从头翻译的 77.2 和 84.7,且存在语言变体混用、表达陈旧等问题。此外,KUEST 游戏翻译专项测试中,排名第一的系统在创意翻译子项中降至第十五。这说明,单一总体得分难以充分反映能力短板,仍需结合细粒度错误分析与专项测试指导优化。
展望:复杂翻译任务将推动模型优化与 Agent 协同结合
机器翻译的应用场景正从通用文本翻译,逐步走向融合文档上下文与多重指令约束的复杂翻译任务。未来,模型优化与 Agent 协同有望形成互补:以高效的翻译专用模型承担基础任务,按需引入 Agent 完成候选选择、译文修订与异常修复,通过模型能力与处理流程的共同优化,兼顾翻译质量、服务效率与可控性。这一方向也契合阿里集团内外的翻译业务需求。电商商品信息本地化需要兼顾术语准确、信息完整与批量处理效率,短漫剧翻译更关注上下文衔接、角色语气和表达风格,PDF 商品说明书等文档翻译还需保留结构与版式。结合阿里云百炼、Aidge 和万镜一刻等产品的应用场景,我们将持续优化 Qwen-MT 系列模型,以专用模型支撑规模化调用,并针对复杂内容与疑难样本按需引入 Agent,提升翻译服务的质量与稳定性。
参考文献