
核心总结
导读:
在人工智能浪潮下,大模型虽强,却饱受“幻觉”和信息过时之苦。如何让AI真正读懂企业海量、复杂的私域数据?RAG(检索增强生成)是破局关键!本文汇聚了明略科技、句子互动、Elastic、蚂蚁TuGraph、枫清科技五位一线大咖的实战经验,从多模态解析、Agentic RAG、混合检索到GraphRAG,为你全景解读企业级知识系统重构之路。
一、多模态数据驱动:让AI长上“眼睛”和“耳朵”
(参考:董振兴《明略科技多模态数据驱动的RAG增强实践》)
企业的真实数据不仅有文本,还有PDF复杂表格、图片、音频甚至视频。在明略科技的董振兴看来,传统RAG面临巨大挑战:复杂布局的PDF提取困难、图表解析结构易丢失、图文混排导致对齐困难。
为了解决这些问题,明略科技打出了一套组合拳:
- Pipeline vs 端到端模型:传统Pipeline依赖各种OCR和版面分析工具拼接,容易误差累积;而端到端大模型可以一次性完成视觉特征提取、文档理解与内容推理,输出Markdown/HTML等结构化格式。
- 混合架构:针对场景识别,对不同模态(文本、表格、图片、语音、视频)分别进行预处理和特征提取,再统一向量化。
- 效果显著:在引入了多模态问答策略(如模块化分离方案)后,结合Agentic RAG进行多轮反思和上下文优化,其指定数据集的平均正确率从 57.61% 飙升至 91.30%。
专业解读:多模态数据对齐是目前的业界痛点。当多张图配多段文字时,大模型极易“张冠李戴”。明略的实践表明,把复杂的视觉任务拆解并交由端到端大模型处理,再结合Agent进行推理,是解决多模态幻觉的良药。
二、Agentic RAG:从“被动检索”到“主动思考”
(参考:高原《Agentic RAG 的现在与未来-从使用工具到重构知识系统》)
如果说大模型是大脑,那传统RAG就是一本“开卷考试”的书。但句子互动的高原指出,AI应用的进步,本质上就是“上下文管理”的进步。我们需要让AI像人类一样,学会“查、算、问、写”。
- 传统RAG vs Agentic RAG:传统RAG是固定的检索-生成流程,只能做简单的相似度匹配;Agentic RAG则具备了动态规划、执行、反思和工具调用的能力。
- 架构拆解:包含Agent控制器、检索模块(多轮动态检索)、工具调用模块(外部API、数据库)、状态管理与日志模块,以及LLM Wrapper。它可以实现单Agent到多Agent的协同。
- 索引期的“目录”革命:聪明的Agent不仅要在检索期发力,还要在索引期动手。让Agent给知识库打标签,生成类似书本“目录”的知识架构,甚至让Agent不断总结“笔记”存入记忆库。
专业解读:Agentic RAG最大的难点在于“死循环”和“高成本”。高原提到的解决方案是提供“原子化”的工具,并在工作流中引入快慢思考机制。未来,Agentic RAG将贯穿索引和检索期,形成知识的自迭代。
三、企业AI搜索底座:Elasticsearch的混合检索之道
(参考:刘晓国《基于 Elasticsearch 创建企业 AI 搜索应用实践》)
在狂飙突进的AI应用背后,离不开强大的搜索引擎底座。Elastic的刘晓国展示了如何用Elasticsearch构建企业级AI搜索。
- 向量+关键词=混合检索:纯粹的向量检索(KNN)虽然语义好,但易丢失精准度;纯粹的关键词(BM25)精准但不懂语义。Elasticsearch推出了RRF(倒数排名融合) 和 凸组合(Convex Combination) 技术,将不同检索方式的得分完美结合。
- 重排(Rerank)三剑客:引入Learning to Rank(学习排序)、Cohere Rerank等模型,对初步检索的Top-50结果进行二次打分,精筛出Top-10。
- 原生集成的便利:只需几行代码,即可调用Hugging Face或内置的模型进行文本向量化,实现开箱即用的语义搜索。
专业解读:企业搜索正在从“找字”向“找意”进化。Elasticsearch通过原生支持RRF和Rerank,大幅降低了企业搭建混合检索系统的门槛,兼顾了“准”与“快”。
四、图数据库的觉醒:GraphRAG打破“信息孤岛”
(参考:戚仕鹏&吕松霖《TuGraph AI:AI时代下图数据库的智能化探索》)
“文本切片”是传统RAG的基础,但切片会切断知识间的关联。蚂蚁TuGraph的戚仕鹏和吕松霖指出,传统RAG基于文本相似性,容易遭遇“Lost in the middle”(长文本中段信息丢失),且无法全局理解复杂信息。
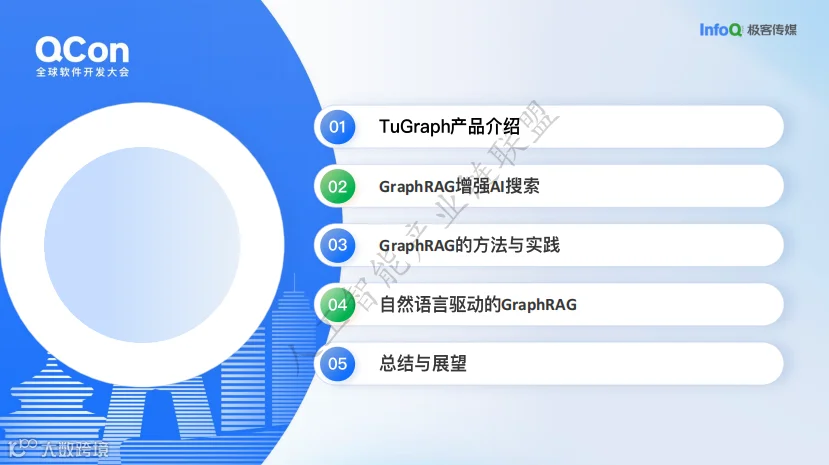
- 图(Graph)的天然优势:顶点表示实体,边表示关系。GraphRAG通过抽取文本中的实体和三元组,构建知识图谱,将离散的文本转化为结构化的网络。
- Text2GQL的魔法:用户用自然语言提问,大模型将其转化为图查询语言(如Cypher),直接在知识图谱中查找最相关的子图和路径。
- Chat2Graph智能体:像人类专家一样,结合向量与图谱知识库,通过快慢思考结合的双LLM推理机,完成复杂的任务规划与图增强检索。
专业解读:GraphRAG特别适合处理“深度关联分析”场景,比如企查查式的股权穿透、医疗疾病并发症溯源。TuGraph推出的Text2GQL及微调模型,将自然语言直接转换为图查询语句,是打通业务人员与图数据库壁垒的关键。
五、终局之战:跨模态知识联邦与统一语义推理
(参考:王传阳《面向复杂场景的RAG架构演进-跨模态知识联邦与统一语义推理实践》)
面对企业知识“结构离散”和“模态多样”的双重挑战,枫清科技的王传阳提出了终极架构:基于融合知识库与统一语义层的RAG架构。
- 融合知识库:物理上数据各存各的,但逻辑上通过视图统一管理,打破文档、图像、关系型数据库的界限。
- 统一语义层:包含统一语义库和统一知识图谱。通过多模态大模型抽取不同数据类型中的元数据(类别、摘要、实体),合并相似实体,形成全局的知识网络。
- 检索流程:用户提问 -> 语义搜索找到相关实体关系 -> 图谱N度扩展查询(子图检索) -> 跨模态获取源数据(音频/视频/表格) -> 结合用户画像与检索结果 -> 大模型润色生成最终答案。
专业解读:这堪称RAG的“六边形战士”。它不仅继承了GraphRAG处理复杂关系的能力,还通过融合知识库和多模态大模型,真正实现了“万物皆可搜”。未来的RAG将不再是单点技术,而是一个能实现自我进化的统一语义推理引擎。
结语:大模型正在重新定义软件,而RAG正在重新定义大模型
从明略的多模态解析,到高原的Agentic大脑;从Elastic的混合底座,到TuGraph的图数据库破局,再到枫清的统一语义层。我们可以清晰地看到RAG的演进脉络:
这不仅仅是从“检索+生成”的技术升级,更是从“被动应答机器”向“主动知识管家”的范式跃迁。
未来已来,谁能最先重构好企业的知识系统,谁就能在AI浪潮中手握真正的护城河。
(本文由人工智能产业链联盟深度编译,欢迎转发朋友圈,探讨AI落地实践)