

扰动之心走出隐匿模式,发布AlphaCell 1.0 Pro驱动药物研发新范式
当大模型在文本、图像领域不断刷新性能上限,直接将Transformer、预训练及Scaling Law等“拿来主义”照搬到生命组学(Omics)领域时,却频繁遭遇现实壁垒。组学数据具有高维、稀疏、动态、异质及标签稀缺等特征,与AI适配的经典数据类型存在巨大鸿沟,导致大量AI for Science(AI4S)项目难以真正走进产业研发场景。
近期,国内AI for Science初创企业扰动之心(PerturbMind AI)正式走出隐匿模式,打造基于几何世界模型的PerturbSeek™数字生命世界模型生态系统,探索适配生命组学并可工程落地的AI技术路线。团队同时发布业内首个虚拟细胞状态推演世界模型AlphaCell 1.0 Pro,其前身AlphaCell 1.0 Preview曾于今年3月发布并获《Nature》报道。
扰动之心孵化于同济大学数字生命智能体实验室(DELTA Lab),由CEO啜国晖博士与首席科学家刘琦教授领衔。DeepTech近日在上海与其对话,深入探讨组学AI的技术路径、Scaling Law的适用边界以及AIDD的未来走向。
照搬通用AI框架面临三道“鸿沟”
DeepTech:将适用于文本、图像的AI框架迁移到组学数据上会遇到哪些问题?
刘琦:组学数据与文本、图像在底层逻辑上存在本质差异。
首先,文本和图像是单一尺度层级(词元或像素),而组学数据涵盖从分子到个体的多尺度层级;其次,组学数据涉及序列、结构、空间等多种表现形式,且具有时序轨迹特性及原位空间描述需求;再次,组学数据信噪比低、批次效应突出、标注成本高且标签稀缺。
若照搬主流AI架构,会遭遇三道“鸿沟”:
- 数据形态鸿沟:主流AI基于海量静态同质数据,而组学数据稀疏、动态、异质;
- 任务目标鸿沟:文本图像聚焦关联与判别,生命组学需解析科学机制;
- 验证闭环鸿沟:组学模型预测需回到生物实验验证,个体差异大、成本高、周期长。
传统AI建模依赖的海量大数据、静态快照、独立同分布及易获取标注等前提,在生命组学场景中几乎均不成立。
啜国晖:产业端体会更深。许多套用通用架构的模型在公开基准上表现亮眼,但在企业真实数据上性能断崖式下跌,根源在于批次效应和样本异质性破坏了独立同分布假设。简单修改输入输出的“套壳”行为无法解决根本问题。
生命组学中的Scaling Law:有条件且有边界
DeepTech:尺度法则(Scaling Law)在生命组学里是否成立?
刘琦:Scaling Law在生命组学中并非简单成立,而是受条件和边界约束。语言大模型的成功依赖于万亿级数据、单一同质任务及静态语料库。相比之下,单细胞数据规模低2-3个数量级,任务高度异质,且受批次效应干扰。因此,不能简单套用NLP和CV中“堆数据、堆参数”的逻辑,需探索属于生命组学的尺度法则。
啜国晖:我们提出“参数量甜点”(Sweet Spot)概念,即性能、算力成本和泛化能力之间存在平衡点。AlphaCell系列模型采用弹性伸缩设计:标准版1B参数,轻量版300M参数适配私有化部署,最大可扩展至50B参数以应对复杂场景。我们根据具体生物任务选择模型规模,而非盲目堆叠参数。
适配生命组学的四大核心方向
DeepTech:真正适配生命组学的AI方法学应抓住哪些核心方向?
刘琦:主要包含四个方向:
- 多尺度跨模态整合:打通分子、细胞、组织等多尺度生物信息;
- 生物语义低秩:将高维噪声数据映射至反映细胞内在结构的低维生物流形隐空间;
- 时空动态变化:利用“世界模型”推演疾病和发育过程中的状态转移;
- 监督信号稀缺:发展弱监督、半监督及无监督学习范式,从“识别关联”走向“因果发现”。
团队前期开发的CausCell原型系统即在反事实生成方面进行了初步探索。“PerturbMind”之名寓意以扰动干预作为理解复杂生命系统的钥匙。
PerturbSeek™生态:以“状态”为中心的AIDD新范式
DeepTech:如何将方法论落地为产业可用平台?
啜国晖:我们以扰动组学、几何深度学习、世界模型理论为基石,构建PerturbSeek™生态系统。传统AIDD多为“靶点中心化”,而我们倡导“以状态为中心”的世界模型范式。疾病本质是生命系统稳态失衡带来的状态偏移,该范式不仅能设计药物分子,更能解析复杂疾病机制、挖掘全新靶点,实现“既配钥匙也找锁”。
AlphaCell 1.0 Pro在上一代基础上升级了扰动轨迹推演能力,通过学习生物隐空间流形上的状态迁移规律,即便在训练样本有限或面对未见过的生物背景时,仍具备有效的泛能力。
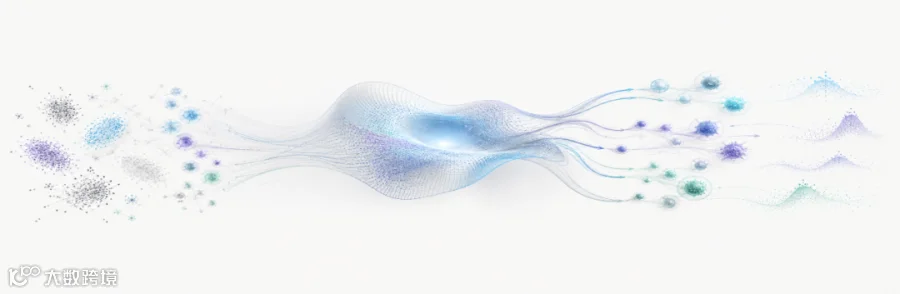
图 | 几何世界模型:连续、可微的生物几何流形(来源:受访者提供)
该技术创新受到DeepMind Alpha系列启发,旨在寻找生命系统中可学习的低维流形。目前,PerturbSeek™已实现对国产GPU芯片的全栈适配,并与国内头部药企及芯片公司签署战略合作协议,推动中国原生(China-Native)信创生态落地。
理性看待干湿闭环与数据价值
DeepTech:如何看数据积累和干湿闭环?
刘琦:“实验在环”(Lab in the Loop)已成为行业标配,而非卖点。自动化实验虽能缩小差距,但无法压缩细胞生长时间,提升模型精度往往比扩建自动化实验室更具边际效益。
数据层面,应避免无目标的“散弹”模式,转向针对特定研发场景的“定向”模式。通过数据治理最大化已有数据价值,结合基础模型的迁移能力解决具体问题。AI原生的核心在于利用主动学习判断优先产生的数据和实验,从而实现资本费效比最大化。
啜国晖:扰动之心的商业逻辑围绕“立项”与“AI-Native”展开。通过PerturbSeek™平台保持高研发“算效”,跳出无目标数据产出和参数内卷的怪圈,真正实现药物研发时代的“降本增效”。
AIDD未来:从分子筛选到系统状态干预
DeepTech:如何看待AIDD的未来走向?
啜国晖:下一代AIDD将从分子层面提升至生命系统“状态”层面。通过在世界模型的状态空间中寻找有效干预手段,攻克传统靶点模式难以解决的复杂疾病、新模态药物研发等难题,回应临床未被满足的需求。
刘琦:学界与产业界需形成合力,不追求空中楼阁式的通用大模型,而是面向具体临床问题做技术突破。正如统计学家约翰·图基所言:“方向找对了,哪怕眼下的答案还模糊!”我们要先找对问题,再迭代答案。
参考资料:
https://www.biorxiv.org/content/10.64898/2026.03.02.709176
https://www.nature.com/articles/d41586-026-01731-1
运营/排版:何晨龙
注:封面/首图由 AI 辅助生成