

重构NPU架构,XHEART发布X7 Ultra智驾芯片
二十多年前,《人工智能的未来》一书中关于“智能关键在于预测”的观点,在Momenta CEO曹旭东心中埋下种子。三年前,XHEART新芯航途CEO李宗霖与曹旭东经过深入探讨达成共识:规模化L4级自动驾驶需要百亿参数AI大模型支持,而通用芯片难以满足其需求。
基于这一前瞻判断,双方携手推出了专为大模型打造的X7 Ultra芯片。该芯片通过重构NPU架构,打破传统软硬分离模式,实现了从模型需求到芯片架构的深度融合,旨在解决大模型在车端受限功耗下的高效运转难题。
超大核+N零拷贝,突破内存墙瓶颈
车企在选用智驾芯片时常面临“实验室高分、实车低效”的困境。核心痛点在于,端到端大模型推理时需频繁将中间数据写入外部DRAM再读取,这种数据搬运不仅消耗时间和带宽,更导致高功耗。若芯片设计不贴合大模型特性,高算力难以转化为流畅体验。
针对此问题,XHEART坚持采用超大核NPU路线。随着端到端大模型计算日益集中,传统小核架构需拆分模型运行,产生海量数据搬移。X7 Ultra的超大核方案将紧密协作的计算单元置于同一空间,使整套大模型可在单颗大核内完整运行。这将传统小核间上百GB/s的数据交互,升级为超大核内部TB/s级别的高速互联,从根源上规避了内存带宽瓶颈。
在指标方面,X7 Ultra提供700 TOPS大模型算力,并通过自研工具链实现整网级融合。借助新型搜索算法,优化范围覆盖整个模型计算流程,实现整网内存零拷贝,大幅减少数据搬运。实测数据显示,X7 Ultra计算利用率达98.7%,在同等大模型性能下,内存带宽消耗较行业旗舰产品下降80%,能效提升100%。量化部署后,模型输出与浮点训练模型相似度保持在99.99%以上,满足高精度要求。

(来源:XHEART)
此外,X7 Ultra加速器原生支持浮点高精度向量计算,确保模型精度不丢失。作为国内首款量产搭载Armv9车规级CPU的SoC芯片,其性能与能效显著提升。在深度异构计算方面,专用计算单元实现本地任务本地处理,激光雷达处理带宽最高达2,000万点/秒,支持千线级激光雷达点云处理,并大幅提升摄像头处理稳定性。安全性上,芯片满足功能安全ASIL-B等级,内置MCU通过ASIL-D认证,信息安全符合国密二级要求。
软硬协同极速落地,21天跑通量产闭环
曹旭东指出,随着自动驾驶向规模化L4演进,面对数百万长尾场景,模型参数将迈向百亿甚至千亿级别。通用芯片在算力、功耗、车规可靠性及成本之间面临“不可能三角”,唯有量身定制的专用芯片才能在满足车端约束的同时支撑大模型参数规模。
为解决通用芯片调试周期长的问题,双方在研发阶段开展极速协同。芯片流片前,团队利用量产大模型算法进行全芯片仿真验证,提前排查风险。首颗芯片回片后24小时内完成点亮,17天内实现芯片、底层软件和智驾模型的整车闭环,并在真实道路复杂环境中通过测试。这种高效的协同精神加速了产品落地。

(来源:XHEART)
基于X7 Ultra,Momenta发布了R7 Ultra世界模型,参数规模扩大5-10倍,安全性能提升5-10倍以上。实测视频显示,系统在狭窄路段对向来车时可果断倒车避让;在复杂掉头场景中,能灵活应对违停车辆和电瓶车,展现出超越人类熟练司机的控制水平。该世界模型具备强通用性,既适用于量产乘用车,也可为Robotaxi提供技术支持,有助于摊薄研发成本。
量产8个月出货超20万颗,布局具身智能未来
商业化方面,XHEART成立两年内完成从研发到量产的全过程。目前,X7系列芯片已量产8个月,累计出货超20万颗,搭载于10款量产车型。同时,手握40款以上车型订单,基于双X7的L3/L4计算平台也获得多个项目定点,正从辅助驾驶向高阶自动驾驶拓展。
双X7计算平台采用统一硬件兼容L3和L4,通过冗余电源域设计、传感器接入和通信互联,满足高阶自动驾驶对硬件和安全的高标准要求。针对外界关于与Momenta深度绑定的猜测,XHEART明确表示合作遵循市场化原则,方案不排他,芯片面向所有算法厂商及主机厂开放。目前已有车企自研算法在X7系列上运行。长鑫科技等产业资本的入局,进一步夯实了从SoC到DRAM的底层生态。
(来源:XHEART)
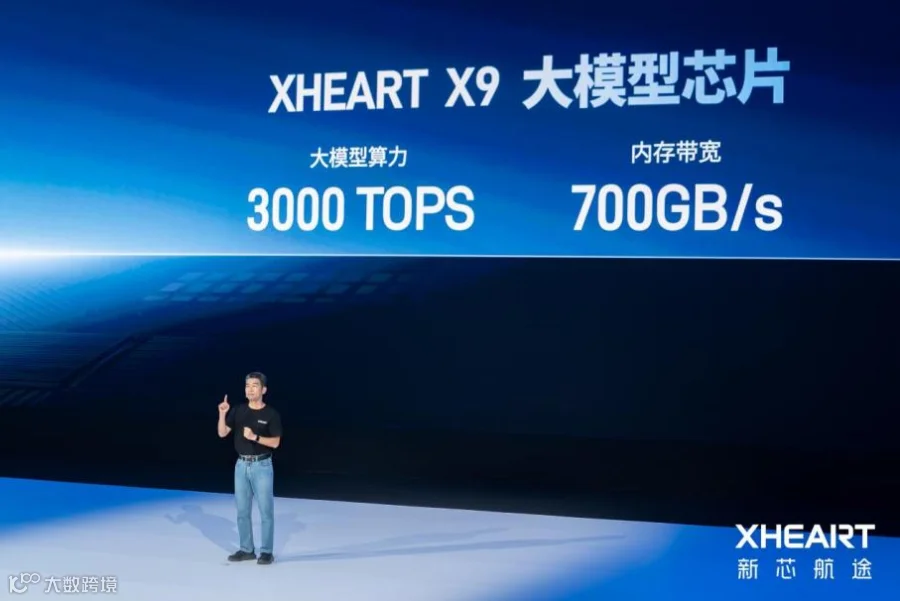
面向未来,XHEART保持“量产一代、开发一代、预演一代”的节奏。下一代大模型芯片X9研发目标已公布:预计2027年推出,提供高达3,000 TOPS的大模型算力,单芯片内存带宽达700 GB/s,以适配更大规模的世界模型需求。鉴于智驾技术与机器人在感知、决策及能效约束上的高度相似性,XHEART已明确布局具身智能市场,并与相关机器人公司展开交流,致力于让物理AI全场景应用加速走进生活。