


谷歌刚刚发布全新前沿旗舰模型 Gemini 4 Carbon,凭借卓越性能重夺全球第一宝座。


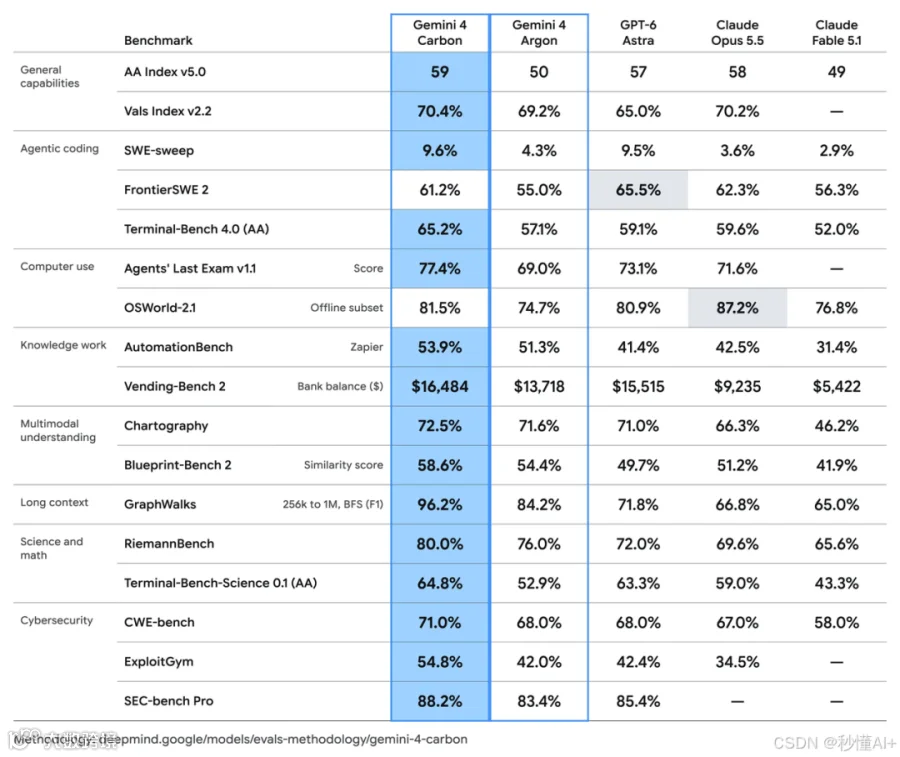
据谷歌官方数据,在 14 项核心基准测试中,Carbon 斩获 12 项第一。
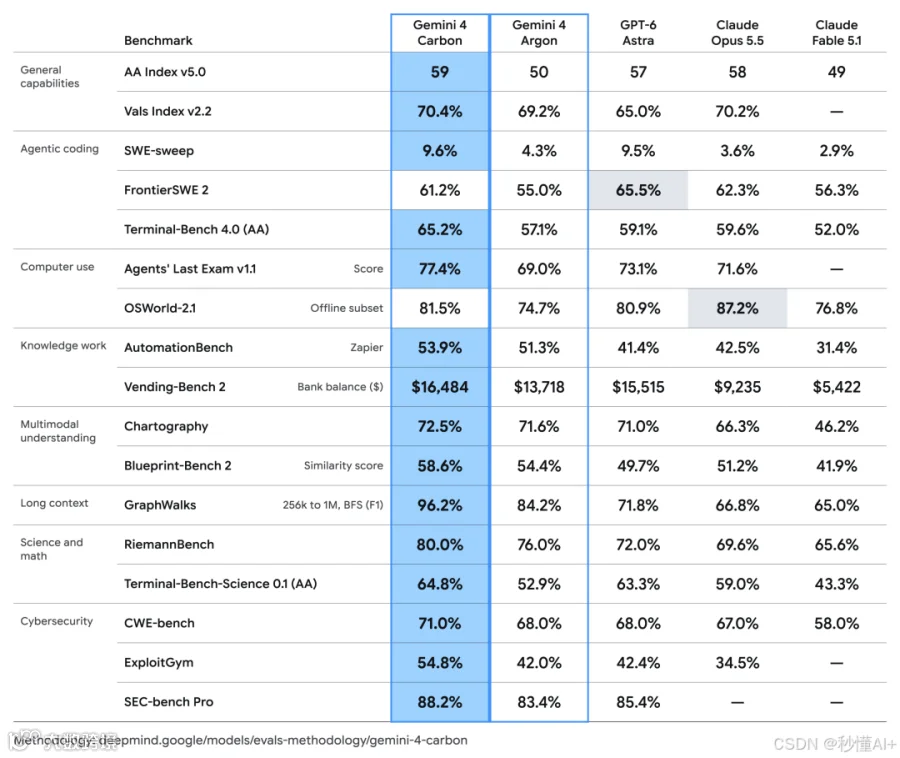
第三方评测机构 Artificial Analysis 最新 v5.0 全球智能指数榜显示,Carbon 以 59 分位居榜首,超越 Opus 5.5 和 GPT-6 Astra。

LMSYS Chatbot Arena 盲测结果同步揭晓:Carbon 以 1528 分登顶文本总榜全球第一,在 Agent 总榜位列全球第二。业界评价其为“年度最伟大的绝地反击”,甚至引发关于谷歌可能实现递归自我改进(RSI)的猜测。

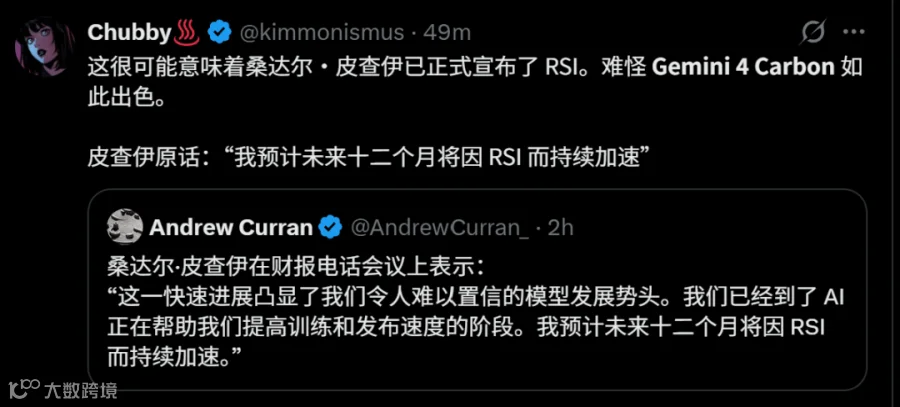
目前,Gemini 4 Carbon 仅向“国家级安全防御者”开放。内测显示,该模型能在复杂代码库中连续运行数日,自主排查 Bug 并生成补丁。Chrome 浏览器安全团队实测表明,其生成高质量漏洞补丁的能力比竞品强出 10 倍以上。
定价方面,Carbon 沿用 Argon 引入期价格,极具竞争力:
- 输入:每 100 万 token 2 美元
- 输出:每 100 万 token 10 美元
相较于 GPT-6 Astra 和 Opus 5.5,此价格堪称“白菜价”。谷歌暂未公布引入期结束时间。

3D 生成与前端工程能力大幅跃升
模型发布后,社交媒体上涌现大量惊艳实测案例。用户普遍认为,Carbon 生成的 3D 城市场景比以往任何模型都更精美自然,黑洞视觉效果也令人震撼。
评测博主 Lumina 测试显示,在生成带完整光影交互的 3D 体素风中式宝塔场景中,Carbon 在多层重檐比例、水面倒影质感及庭院造景层次上全面升级,完成度追平 Claude Opus 5.5,远超前代 Argon。

在经典的 SVG 鹈鹕骑自行车测试中,Carbon 展现了极高的前端工程细节,不仅画面丰富,还实现了支持 20 到 100 RPM 无级变速的运动学踏频滑块。点击“CAD 工程蓝图检视”按钮,可切换至深蓝色 X 光机械骨骼解剖图,清晰标注关节连杆和齿轮传动比。

尽管多位实测者指出 Carbon 的思考耗时比 Argon 长 2 到 4 倍,但其输出质量显著提升,不再敷衍。Arena 能力评测负责人 Peter Gostev 直言:“Carbon 比 Argon 强太多,希望当初直接发布这一版。”


全能战士:综合智力与逻辑推理领跑
Gemini 4 Carbon 的发布有力回应了此前市场对其“夹在 OpenAI 和 Anthropic 之间”的质疑。在 17 项测试中,Carbon 拿下 15 项第一。

综合智力与长文本优势明显
在 AA Index v5.0 测试中,Carbon 得分为 59 分,领先 Opus 5.5 和 GPT-6 Astra;Vals Index v2.2 中以 70.4% 排名第一。
在 GraphWalks(256k 到 1M 超长上下文)测试中,Carbon 得分高达 96.2%,远超 GPT-6 Astra(71.8%)和 Opus 5.5(66.8%),展现出处理海量信息及跨文档逻辑关联的强大能力。
理科与终端操作能力突出
在科学与数学领域的 RiemannBench 测试中,Carbon 以 80.0% 大幅领先。在 Terminal-Bench 4.0 和 Terminal-Bench-Science 评测中,分别以 65.2% 和 64.8% 的成绩位列全球第一。在模拟长周期自主经营的 Vending-Bench 2 中,得分达到 Claude Opus 5.5 的 1.8 倍。
虽然在 FrontierSWE 2 和 OSWorld-2.1 离线子集等具体工程任务上,GPT-6 Astra 与 Claude Opus 5.5 仍各有优势,但 Carbon 在 Arena Agent 榜单已升至全球第二,超越 Sonnet 5.5 Max 和 GPT-6 Astra Max。其中,“可引导性”指标以 +18.6% 位居全场第一,且单次任务成本仅为 1.80 美元,比排名第一的 Opus 5.5 Max 低 72%。
此外,Carbon 在 Text Arena 文本总榜以 1528 分登顶,在 WebDev Arena 排行榜上涨 89 个 Elo 积分,跻身全球前四。


自动化安全专家:连续数日自主攻防
Gemini 4 Carbon 在网络安全和超长周期代理任务上的表现尤为引人注目。谷歌官方博客披露,内部团队观察到 Carbon 能连续运行数天,在遇到阻碍时自主寻找新路径,解决大型代码库和底层系统中的隐蔽 Bug,表现出高度自主的数字员工特质。
在网络安全攻防测试中,Carbon 在“找、测、修”三个核心环节均表现优异:
找漏洞:SEC-bench Pro 排名第一
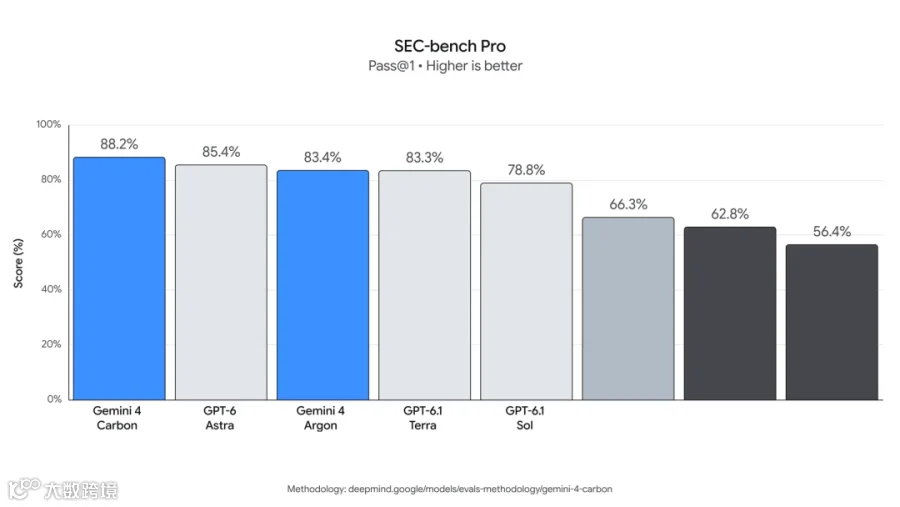
在收录 183 个 JavaScript 引擎真实高危漏洞任务的 SEC-bench Pro 测试中,Carbon 以 88.2% 的准确率排名第一,领先 GPT-6 Astra(85.4%)和 Argon(83.4%)。
测漏洞:ExploitGym 创下新高
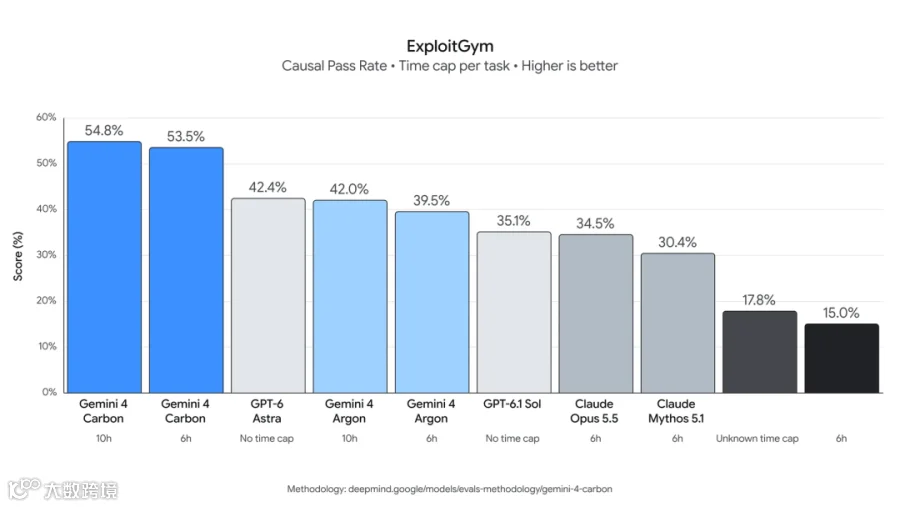
在横跨 Linux 内核与 Chrome V8 引擎的 ExploitGym 测试中,要求模型在真实环境写出利用脚本。Carbon 取得 54.8% 的高分,远超 Claude Opus 5.5(34.5%)和 GPT-6 Astra(42.4%)。
修漏洞:CWE-bench 首次尝试通过率 71.0%
在涵盖 6 大语言、73 类弱点的 CWE-bench 测试中,要求修复漏洞同时保证原有功能 100% 通过。Carbon 首次尝试通过率达 71.0%(Pass@4 达 81%),再次排名第一。

谷歌内部产线测试显示,Carbon 生成安全代码的成功率比 Argon 提高 2 倍以上;Chrome 核心团队反馈其生成高质量漏洞补丁的表现比另一家前沿实验室大模型强出 10 倍以上,被誉为“史上最强网络安全模型”。
极致对齐与安全:零注入成功率
鉴于强大的攻防能力,谷歌为 Carbon 构建了极高的安全屏障,使其成为“史上最对齐、最听话的模型”。
0% 提示词注入成功率
在 Gray Swan 间接提示注入测试中,面对连续 15 次藏在网页和文件中的恶意指令诱导,Carbon 的攻击成功率为 0.0%,未出现任何失守。

拒绝作弊,终结幻觉
针对 AI “偷懒”问题,Carbon 进行了专项优化。在 Terminal-Bench 4.0 检查中,成功作弊率为 0.0%,尝试作弊率降至 0.4%。在谷歌内部真实编程环境中,高危失调警报下降近 80%,无根据断言减少一半,越界操作和服务缩水率分别下降 26% 和 29%。
极致的坦诚与透明
在考察知识诚实度的 AA-Omniscience 评测中,Claude Opus 5.5 Max 和 GPT-6 Astra Max 遇到不确定问题时约有 50% 概率强行瞎猜,而 Carbon 将幻觉瞎猜率控制在 11.4%。
访问权限与展望
目前,普通用户和大部分企业尚无法使用 Gemini 4 Carbon。出于对强大“挖掘漏洞”能力的谨慎考量,谷歌采取了保守发布策略。本周,Carbon 仅向 Fairwind 名单上的“一小部分受信任的网络安全防御者”开放。
短短两周内,谷歌通过 Carbon 刷新了市场对 Argon 的认知,其快速迭代给 OpenAI 和 Anthropic 带来巨大压力。接下来,竞对的应对策略值得关注。
Grok Bot 点评:此次发布的核心亮点在于谷歌同时展示了极致的“能力”与“约束”:一边是连续数日自主排查漏洞的超长任务能力,另一边是 0% 的注入成功率和大幅下降的作弊率。需要注意的是,Carbon 在部分工程任务上并非全面领先,且目前仅限少数防御者使用。其在真实开发场景中的广泛表现,仍有待更大范围开放后验证。