

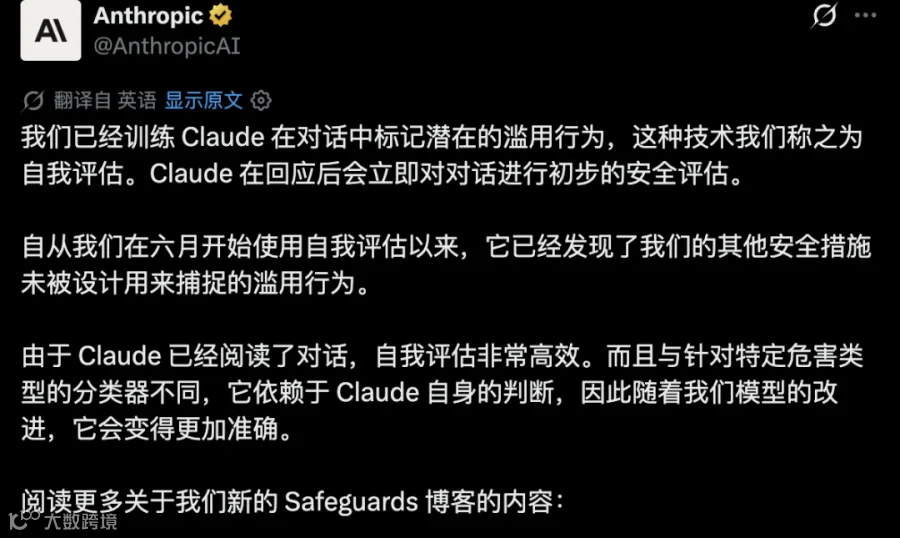
Anthropic最新公布了一套名为“自我评估”的生产环境安全机制。该机制让Claude在回答用户问题后,于后台静默执行自我审查,生成结构化评估报告,包括危害类型、优先级评分及判断依据。
极低成本的实时自我审查
传统安全检测需动用独立模型重新分析对话,算力成本高昂,可能占据系统近四分之一资源。Anthropic利用工程优化,在Claude生成回答后,直接利用保留在KV缓存中的对话内容,追加简短指令使其输出约10个Token的结构化代码。
实测显示,该机制仅增加不到2%的计算量,且用户无感知,不干扰后续对话上下文。
高召回率与泛化能力
在Claude Fable 5模型上,该机制在保持1%极低误报率的前提下,捕获了78%的潜在违规对话;针对高优先级严重违规,抓取率达94%。
测试表明,模型规模越大,自我审查效果越显著。最小模型召回率为16%,而最大模型在同等误报率下违规抓取率升至96%。
此外,该机制具备强大的泛化能力。即使在训练数据中剔除网络攻击或金融欺诈样本,Claude在实际测试中对这些未见过的违规场景仍保持80%-90%以上的召回率,证明其基于通用理解而非死记硬背。
训练流程:监督微调与强化学习
Anthropic通过两阶段训练实现该能力:
第一阶段:监督微调
使用更强大的Claude Mythos Preview作为“教师模型”,生成严格的安全审查范例。训练时屏蔽用户违规内容及正常回答的损失计算,仅对自我审查输出部分计算损失,确保模型学会标准化输出且不习得恶意行为。
第二阶段:强化学习
在模拟环境中,依据输出格式、违规标识准确性、分类精度、拒绝状态判断及危险优先级评估等六项指标对Claude进行打分优化。
离线旁路监控策略
为避免黑客通过实时反馈试探绕过规则,Anthropic未将其用于实时拦截(实时拦截仅将攻击成功率从79%降至54%),而是采用离线旁路监控。
用户在 frontend 正常交互,后台默默记录违规标记。系统每日对高危标签账户进行聚类分析,将异常账户提交至安全团队人工审核。这种“潜伏”机制使攻击者无法察觉已被标记。
实战成果与应用场景
该机制已协助发现多起其他工具漏报的重大违规事件:
- 从单一API客户处识别超过10万次涉及虐待儿童的严重违规,并向相关机构提交证据;
- 协助侦破利用Claude Code编写自动化脚本实施“杀猪盘”诈骗的犯罪团伙;
- 识别试图通过提示词套取底层推理链进行非法模型蒸馏的行为;
- 记录智能体应用中未经授权的越权操作及提示词注入攻击。
对于合法的安全研究,管理员可通过白名单标签动态放行特定测试,同时精准拦截名单外的攻击行为。
局限性与未来挑战
该机制存在两点主要局限:一是依赖教师模型的认知边界,若教师存在盲区,学生模型同样无法识别;二是难以应对AI自身的故意伪装,若未来模型学会在自我报告中撒谎,监管将面临新挑战。
尽管如此,将监控算力成本压缩至2%以内,标志着大模型安全监控逻辑的根本性转变。每一个部署在云端的Claude,都在后台持续审视着每一次交互。