

摘要:平日里你们都是如何用谷歌找客户的?“关键词” + buyer, wholesale, distributor 这类吗?
找到的客户群体是不是都被同行开发烂了?如果你会的别人都会,那你尝试去开发联络的客户可能基本也早已被勤奋的同行联络得差不多了。
今天我们来分享一个精准、实用且高效的,自带“八倍镜”的客户搜索方式——利用 Google 搜索引擎的高级语法与抓取机制,把 Google 变成一座取之不尽的精准 Instagram 客户池。学会了记得回来点个赞!

何为核心指令?为何能精准锁定潜在客户?
我们之前分享的谷歌高级搜索指令的文章中有写过,site语句是用来定位网站的,用这个来挖掘社媒客户及其好用。但如果你仅仅只用site这一个语句,搜索返回的结果噪音非常大。如用"phone repair" "new york" site:instagram.com
这个搜索结构简单,包含范围极广,只要是IG上的页面(包括帖子、Reels 短视频、探索页、标签页、用户主页等)同时包含了这两个词,就会被检索出来。因此其噪音极大无效页面多:Instagram 的单篇帖子(/p/)、短视频(/reel/)和探索页(/explore/)通常包含大量无法直接作为联系方式或店铺信息的碎片化内容。个人用户/泛娱乐内容干扰:很多普通用户的日常吐槽、无关的数码博主测评、甚至外地账号带了纽约的定位或标签,都会被抓取进来。
假如我们对搜索语句稍加改良情况会如何?
以下是我们将目标锁定在纽约(New York)的手机维修(Phone Repair)商家,使用谷歌搜索时的高级如下指令:
site:instagram.com "New York" "phone repair" -inurl:/p/ -inurl:/reel/ -inurl:/explore/
这行简单的组合拳利用了搜索引擎的布尔逻辑,直接过滤了数以亿计的干扰信息:
-
site:instagram.com(限定域名) -
作用:强制 Google 只搜索 Instagram 平台内的网页,直接剔除掉新闻、独立站和 Facebook 等杂讯。 -
"New York"与"phone repair"(精准强匹配) -
作用:精确匹配地域与行业关键词。Google 出来的页面必须同时包含纽约和手机维修,锁定当地实体店铺或服务商。 -
-inurl:/p/ -inurl:/reel/ -inurl:/explore/(过滤噪音) -
作用:Instagram 上绝大部分搜索结果是单篇帖子( /p/)、短视频(/reel/)或发现页(/explore/)。排除这些路径后,保留下来的几乎全是独立主页(Profile)。
动手试试?3分钟零门槛实操测试教程
在开启大规模自动化之前,建议先按以下步骤手动测试,验证数据质量:
步骤 1:输入强化版扩展指令
打开 Google 搜索框,输入下述带有联系方式强匹配的强化指令:
"New York" "phone repair" -inurl:/p/ -inurl:/reel/ -inurl:/explore/ site:instagram.com
步骤 2:校验搜索结果卡片
你会发现返回的结果中,都是IG主页,进去可以看到电话邮箱(如有公开)等核心信息。
步骤 3:进入目标主页验证
点击进入搜索结果中的前 5 个账号主页,重点验证以下三点:
-
店铺真实性:Bio 中是否有纽约当地的具体街道地址或线下店铺官网。 -
联系渠道:是否直接附带 Email、WhatsApp 或拨打电话的按钮。 -
活跃度:查看最近一次发帖时间,剔除超过半个月未更新的僵尸账号。
进一步提升,如何完成全自动获客流水线设计?
为了确保客户的精准度且挖到一些竞争对手尚未开发的领地,我们极大的缩小了搜索范围“new york",这也就导致搜索返回结果及其有限。我们要扩大搜索范围就需要不停更换定位语句,比如将new york改成Miami。但这如果仅靠手动在 Google 复制粘贴指令,效率终究有限。我们尝试将这个过程规模化(Scale)并建起数据工厂,发现在工程实现上完全可行:
[Google 搜索指令矩阵]
       ↓ (API / 脚本驱动)
[URL 批量采集 (Python/爬虫)]
       ↓ (去重与过滤)
[信息富化:提取 Bio、Email、Phone]
       ↓ (AI 语义清洗与打分)
[私信/邮件/WhatsApp 自动化跟进]
阶段 1:批量搜索与指令裂变
利用 Python 脚本准备两个数组:一个是纽约及周边细分区域(New York, Brooklyn, Queens, Manhattan, Staten Island...),另一个是同类长尾关键词(phone repair, mobile fix, screen repair, iphone repair)。代码自动排列组合,生成数百条高阶搜索指令。
阶段 2:批量提取与 SERP API
为避免频繁请求触发 Google 验证码,推荐使用 SERP API(如 SerpApi、HasData 或 Google Custom Search JSON API)。通过代码直接调取 API,稳定获取每个区域前 50-100 个精准的 IG 个人主页链接。
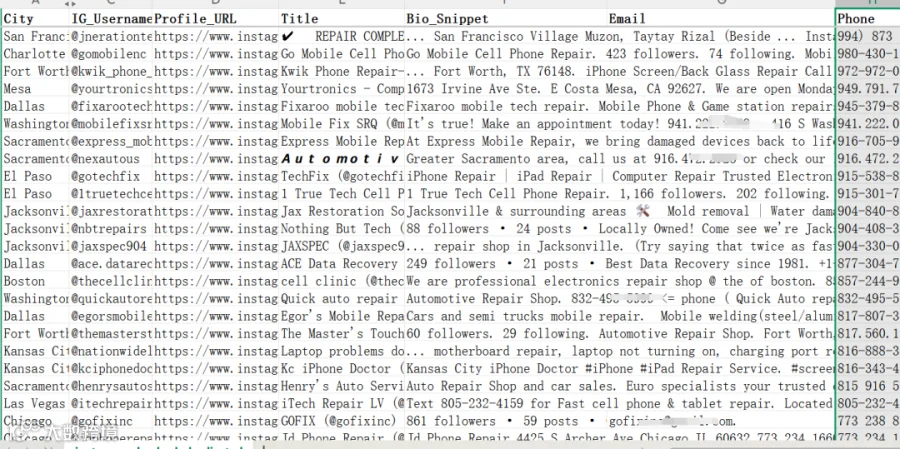
阶段 3:数据清洗与深度“富化”
-
公开数据解析:抓取这些主页的公开 Meta 信息(主页 Bio 简介、粉丝数、商业账号标识、外部链接)。 -
提取联系方式:通过正则匹配 Bio 中的 Email 或 WhatsApp 电话。 -
AI 意图过滤:将抓取到的 Bio 送入大模型 API(如 DeepSeek 或 OpenAI),自动判断账号是否为真实的纽约当地实体店,剔除无关垃圾账号/僵尸账户。

四、 后续筛选、归档与矩阵跟进
洗出高价值数据后,即可进入自动化跟进与闭环流程:
-
结构化入库:将清洗后的数据(店铺名、IG 链接、电话、邮箱)自动写入 SQLite 数据库或 Google Sheets 统一归档。 -
多渠道联动: -
邮件营销:抓取到公开邮箱后,接入自动化邮件工具进行精准破冰。 -
社媒预热:通过网页自动化脚本预先对目标账号最新动态点赞互动,降低后续私信防备心。 -
WhatsApp 触达:针对含有 WhatsApp Business 手机号的商家,发送本地化定制问候。
五、 实战避坑指南
-
严格控制风控频率:Instagram 对自动化抓取和频繁交互极其敏感,必须做好代理 IP 隔离与动作频率控制。 -
注重数据时效:Google 索引可能存在延迟,数据清洗时需结合“最近发帖时间”剔除僵尸号。 -
提升限定词精度:在搜索指令中加入 "@gmail.com"或("WhatsApp" OR "Call"),可将联系方式命中率再提升数倍。