


最近做独立站,有一个问题我觉得挺有意思:
以前做 SEO,我们最关心的是 Google 有没有抓取网站、有没有收录页面、关键词排在第几名。
现在 AI 搜索火了,大家的关注点又多了几个:
“ChatGPT 有没有抓取我的网站?”
“我的网站内容是不是已经进入 GPT 的知识库了?”
“为什么竞争对手的网站会被 AI 推荐,我的网站却像个透明人?”
甚至有人开始研究服务器日志,发现 GPTBot 来过自己的网站,顿时激动得像收到了一笔十万美元的询盘。
先别急着开香槟。
AI 爬虫来过你的网站,和 AI 将来愿意推荐你,中间可能隔着十万八千里。
这里面有一个很容易被忽略的问题:
我们经常把 AI 的“爬取”“学习”“收录”“搜索”“引用”混为一谈。
实际上,它们可能是五件完全不同的事。
如果搞不明白这些区别,做 GEO(生成式引擎优化)很容易出现一种奇怪的现象:
网站优化得热火朝天,AI 却在旁边一脸茫然。
今天就聊聊,AI 究竟是怎么认识互联网的,以及这件事情对外贸独立站意味着什么。
一、同样是爬网站,Google 和 AI 到底在忙什么?

我们先把一个常见误区解决掉:
不是所有来抓取网站的机器人,都打算把网站放进搜索结果里。
传统搜索引擎和 AI 系统,确实有很多相似之处。
比如它们可能都会:
访问网页、读取 HTML、分析文字、跟踪链接、识别重复内容、过滤垃圾信息。
表面上看,好像都是一群机器人在互联网里到处翻箱倒柜。
但问题是,它们把东西搬回去以后,处理方式完全不同。
我喜欢用一个不太严肃的比喻来理解。
Google 搜索更像图书管理员。
它发现一本书,阅读目录,记录内容,把这本书放到合适的书架上。
以后有人来问:“有没有介绍工业研磨设备的资料?”
管理员就从书架上找出相关书籍,按照一定规则排列,并告诉你去哪里看。
这里最重要的是:它需要保留书和来源之间的关系。
大模型预训练更像培养一名厨师。
把大量菜谱、烹饪知识和经验交给一个厨师学习。
厨师经过长期训练,学会了如何处理食材、搭配味道、制作菜肴。
以后你问他怎么做一道菜,他可以直接回答。
但你很难要求他准确指出:
“你刚才说的盐要放三克,是从训练资料中的第 28746 份菜谱学来的?”
大模型训练后的知识,通常体现在模型参数中,并不天然对应一个可以逐条反查的网页数据库。
当然,这不代表模型绝对不会记住某段原文。研究发现,大模型确实存在记忆甚至复现部分训练内容的可能。
还有第三种情况:RAG,也就是检索增强生成。
这个名字听着很高级,说白了就是给厨师配一个可以随时查资料的助手。
遇到问题,先查找相关资料,再结合找到的内容回答。
资料可以来自网站、搜索服务、企业知识库或者其他外部数据源。
这种方式能够保留来源信息,也更容易更新知识。
所以,我们至少要区分三条路线:
-
传统搜索: 找到网页,建立索引,返回相关结果。 -
模型训练: 从大量数据中学习规律,调整模型参数。 -
在线 AI 检索: 回答问题时查找外部资料,再结合模型能力生成答案。
这三条路线之间可以互相配合,但绝对不能直接画等号。
二、网站被 AI 爬虫访问,就等于进入 AI 的知识库了吗?
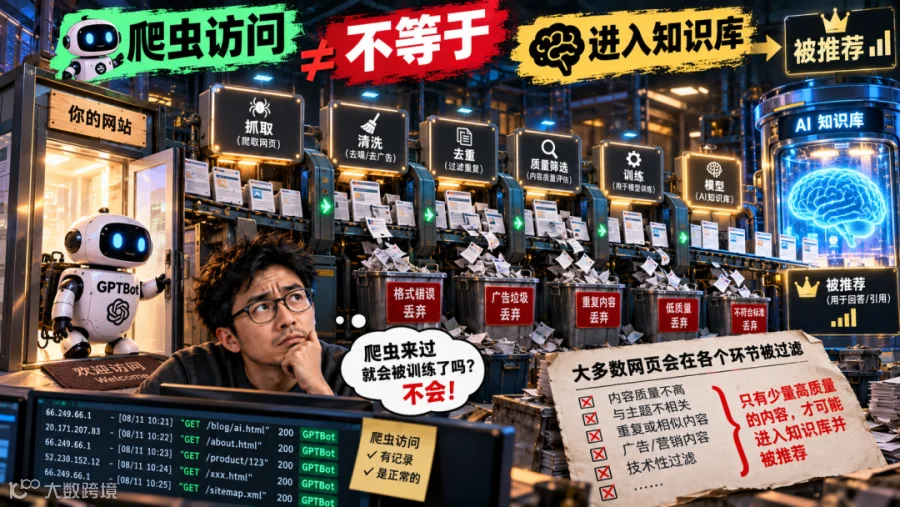
我觉得这是最值得外贸企业主搞清楚的问题之一。
假设你经营一家工业设备外贸独立站。
某一天,服务器日志里出现了 GPTBot。
你非常兴奋:
“太好了!OpenAI 终于发现我了!”
第二天,你迫不及待地打开 ChatGPT,输入:
“Recommend reliable industrial polishing equipment manufacturers in China.”
结果 AI 推荐了五家竞争对手。
没有你。
甚至连你的品牌名字都没出现。
你开始怀疑人生。
但实际上,这个结果并不奇怪。
因为对于模型训练来说,一个网页可能需要经历下面这些环节:
网页被抓取 → 进入原始数据集合 → 内容清洗 → 去重 → 质量筛选 → 被选入训练数据 → 实际参与训练 → 影响模型参数。
注意,这中间每一个箭头都不代表必然成功。
有的网页虽然被抓了,但可能属于重复内容。
有的内容可能质量太低,直接被过滤。
有的虽然进入了候选训练数据,却未必在最终训练过程中被使用。
即使真的参与了训练,也不意味着模型会记住你的品牌,更不意味着它会优先推荐你。
这里还有一个容易忽略的细节:
AI 公司不一定需要亲自爬你的网站,才有机会获得你网站上的公开内容。
例如 Common Crawl,就是一个提供大规模公开网络抓取数据的项目。
它的爬虫 CCBot 会持续抓取大量网页,形成可供研究和其他用途使用的数据集。
模型开发者可以利用这类第三方数据。
所以,有时你可能没有看到某个模型公司的机器人访问记录,但不代表你的公开内容绝不可能通过其他渠道进入其数据来源。
反过来,看到爬虫访问记录,也不能证明内容已经参与了某个具体模型的训练。
我觉得这里最重要的一句话是:
爬虫访问日志只能证明某种访问行为,不能直接证明训练、搜索收录或 AI 推荐。
就像有人进了你的工厂展厅。
你只能证明他来过。
不能证明他记住了你,更不能证明他已经决定采购一整个集装箱。
三、AI 知识更新这么慢,那它为什么又能回答今天发生的事?
这个问题也很有意思。
有时候我们问 AI 某个最新发生的事件,它回答得非常及时。
但如果问它一家刚成立的外贸企业,它可能完全不知道。
这是不是说明 AI 特别喜欢国际新闻,不喜欢小工厂?
倒也不是。
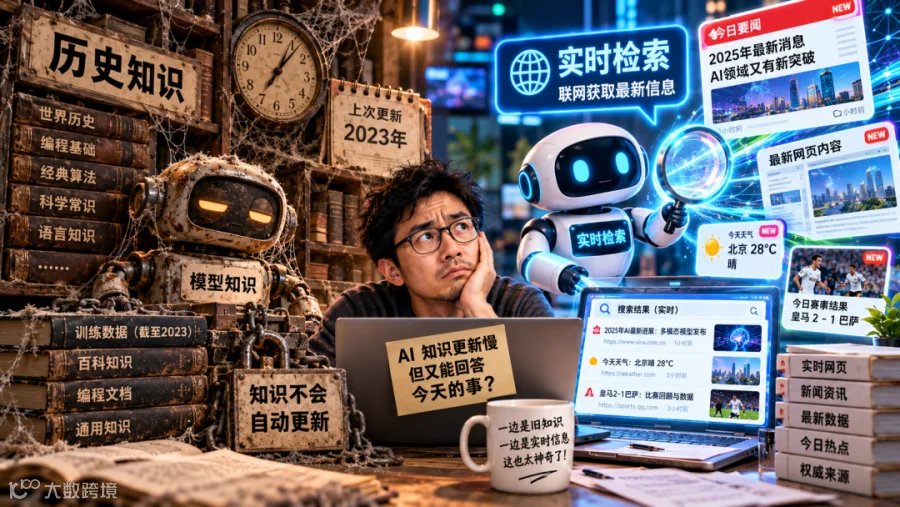
原因是:模型本身的知识更新,和 AI 产品使用的实时搜索,不是一回事。
传统搜索引擎的索引可以持续更新。
Google 会根据网页的重要性、变化情况、服务器承载能力等因素安排抓取。
页面变化后,重新抓取和处理可能需要数天,也可能需要更长时间,并没有统一的固定周期。
但大模型预训练通常不是这样。
模型可能先收集某个阶段的大量数据,然后经过清洗、筛选,集中进行训练。
模型训练完成后,昨天刚发布的一篇文章不会因为网页更新,就自动变成模型已有参数中的知识。
这时候,在线检索就派上用场了。
比如一个支持网络搜索的 AI 产品,可以在回答问题时先查询外部资料,再把相关内容提供给模型。
因此,你看到的可能是:
模型本身不知道这个最新消息,但它刚刚查到了。
好比一个人没背过最新的行业目录,但手边有搜索工具,照样可以找到供应商。
对外贸独立站来说,这意味着什么?
想让 AI 了解你的品牌,不能只寄希望于下一次模型训练。
更值得关注的是,当客户实际提出采购问题时,你的网站是否有机会被相关搜索或检索系统发现、理解和采用。
这也是我认为 GEO 需要关注的现实入口之一。
四、GPTBot、OAI-SearchBot、Googlebot,究竟谁负责什么?

做独立站的人应该都见过 robots.txt。
这个文件有点像网站门口贴着的一张告示:
“欢迎参观,但是仓库不对外开放。”
问题是,现在访客越来越多,岗位分工也越来越复杂。
OpenAI 公开区分了几种不同用途的访问身份。
GPTBot:与模型训练相关。
它用于访问可能被用于 OpenAI 基础模型训练的内容。
但它访问过你的网页,不等于你的网页最终一定被训练使用。
OAI-SearchBot:与 ChatGPT 搜索有关。
它承担 ChatGPT 搜索所需的网页抓取用途。
如果希望网站有机会出现在 ChatGPT 搜索中,就需要关注是否允许它访问相关页面。
不过,允许访问只是获得相应资格的一个条件,并不保证一定被引用或推荐。
ChatGPT-User:与用户触发的网页访问有关。
例如用户主动让 ChatGPT 打开某个网页时,可能涉及这类访问。
它和用于自动训练或搜索抓取的机器人,不是同一回事。
Google 这边又有不同设计。
Googlebot:负责 Google 搜索相关的网页抓取。
包括普通搜索在内的 Google Search 功能,依靠 Google 的搜索基础设施。
Google-Extended:控制部分 Gemini 用途。
这里有一个特别容易搞错的地方。
Google-Extended 本身并不是一个独立的网页爬虫。
它是 robots.txt 中的一个控制令牌,主要管理 Google 已获取内容能否用于未来 Gemini 模型训练以及部分指定的 Gemini grounding 用途。
限制 Google-Extended,并不等于禁止 Google Search 抓取,也不会因此直接影响普通 Google 搜索的收录或排名。
看到这里,我觉得很多人应该能明白:
以前我们只需要考虑要不要让 Googlebot 进来。
现在还需要考虑,进来的机器人究竟准备拿内容干什么。
能不能只允许 AI 搜索,不允许 AI 训练?
以 OpenAI 公开提供的控制方式为例,可以在 robots.txt 中设置:
User-agent: GPTBotDisallow: /User-agent: OAI-SearchBotAllow: /
这表示:
不希望 GPTBot 访问该站点用于相应训练用途,但允许 OAI-SearchBot 抓取网站。
这只是一个简化示例,真实网站还需要结合其他 robots 规则、服务器权限和页面设置检查。
另外,robots.txt 主要管理相关爬虫未来的访问行为,并不能保证历史上已经取得的数据会被删除。
对于希望保护内容版权,同时又想争取 ChatGPT 搜索曝光的企业来说,这种按用途分别管理的思路值得了解。
但我不建议看到这个配置就立刻往自己的网站里复制。
先搞清楚自己的业务目标,再决定放行谁、限制谁。
不然就像开了一家工厂,采购经理被门卫拦在外面,倒是把所有无关访客请进了会议室。
五、为什么 Google 能看到的网页,AI 不一定能看到?

这里要说一个技术问题:JavaScript。
很多独立站为了做出炫酷效果,会采用大量 JavaScript 来加载页面内容。
有些网站的 HTML 初始内容非常少,关键产品介绍、参数甚至正文,需要浏览器执行脚本以后才出现。
Google Search 具备 JavaScript 渲染能力,可以处理许多依赖 JavaScript 的网页。
但是,并不是所有网络爬虫都具有同样的能力。
例如 Common Crawl 公开说明,其 CCBot 不执行 JavaScript。
至于 GPTBot 是否会对所有网页进行完整的浏览器级 JavaScript 渲染,公开信息并不足以给出统一答案。
因此,不能简单认为:
“我用 Chrome 能看到完整页面,所有 AI 爬虫肯定也能看到。”
这也是我为什么一直认为,企业独立站的基础技术架构特别重要。
尤其对于外贸 B2B 网站来说,真正有商业价值的内容通常是产品参数、应用场景、技术说明、公司资质、常见问题和联系方式。
这些信息最好不要全部依赖复杂的前端脚本才能呈现。
如果你使用 WordPress,问题未必严重,因为它通常可以直接输出大量服务端 HTML 内容。
但如果你用的是高度依赖客户端渲染的自定义前端,就值得特别检查一下。
我更倾向于让重要内容能够直接通过可访问的 HTML 获取,或者采用合适的服务端渲染、预渲染方案。
网站当然可以做得漂亮。
但如果访问者是机器人,它连你的产品介绍都读不到,你把动画做到电影级别也没什么意义。
人类看到的是一座漂亮展厅,爬虫看到的可能只是一间毛坯房。
六、AI 会不会更喜欢内容质量高的网站?

说到这里,很多人可能会问:
“既然 AI 会过滤内容,那我是不是多发高质量文章,就能提高 AI 推荐概率?”
我的看法是:提高内容质量很重要,但不能把它理解成一张 AI 推荐保证书。
我们先看预训练。
大型语言模型的数据处理管线可能进行语言识别、垃圾过滤、重复检测、质量评分以及数据采样。
例如 GPT-3 公开的训练研究就使用过质量分类和模糊去重技术,并对部分高质量数据来源提高了采样权重。
这说明什么?
互联网内容并不是谁发得多,谁就一定被学习得更多。
但也不能反过来推导出一条简单公式:
高质量原创文章 × 100 = AI 推荐次数 × 100。
因为预训练的数据质量筛选,与在线搜索中的来源选择,是不同的过程。
再说回 GEO。
假设有两家工业设备供应商。
A 公司的网站写着:
“Professional Manufacturer, High Quality, Best Price, Excellent Service.”
B 公司的网站则清楚解释:
某种研磨设备适合哪些材料、如何选择设备、不同工艺有什么区别、设备维护需要注意什么,以及相应的技术参数。
当客户询问:
“Which polishing machine is suitable for removing burrs from stainless steel parts?”
我认为 B 网站的内容更有机会成为有用的参考资料,因为它提供了与问题直接相关的信息。
但究竟会不会被某个 AI 产品引用,还取决于实际检索结果、来源选择机制、问题语境等因素。
不是把文章写长一点,AI 就会自动给你颁发一张优秀供应商证书。
所以,我对 B2B 独立站内容的判断一直很明确:
与其重复告诉别人自己有多专业,不如让网站真正回答采购商关心的专业问题。
这是改善内容实用性的基础,也有利于传统 SEO。
至于是否能够提升 AI 引用,需要通过实际结果持续验证。
七、SEO 和 GEO 到底是什么关系?以后还需要做 Google SEO 吗?

一定需要。
而且在可预见的情况下,很多 GEO 工作仍然离不开 SEO 的基础能力。
原因很简单。
支持联网的 AI 产品,需要以某种方式找到外部资料。
有的使用搜索基础设施,有的使用专门检索系统,有的结合多个数据来源。
不管具体采用哪种方案,公开网页的可访问性、内容结构、来源可靠性和信息清晰度,通常都有实际意义。
传统 SEO 主要关注网站在搜索引擎中的发现、索引、排名和自然流量表现。
GEO 则更关注品牌和内容能否在生成式 AI 的回答中获得合适的呈现、提及或引用。
两者有交集,但衡量结果不同。
举个例子。
一家外贸工厂的某篇技术文章,在 Google 自然搜索中有很好的排名。
这是一个 SEO 成果。
如果某个 AI 搜索产品在回答相关采购问题时引用了这篇文章,甚至把这家公司列为值得进一步了解的供应商,那才涉及具体的 AI 搜索曝光效果。
这两个结果可能同时出现,也可能只出现其中一个。
尤其要注意,Google AI Overviews、Google AI Mode 和 ChatGPT Search,并不应该被当成完全相同的系统。
它们的检索和内容展示方式可能不同。
所以,我不太认同一种极端说法:
“以后用户都问 AI 了,SEO 没用了。”
这就像有人发明了智能导航,于是宣布公路建设可以取消。
导航再聪明,也需要有路可走。
真正值得研究的是:
现有 SEO 工作中,哪些基础能力仍然有价值?又有哪些指标需要针对 AI 搜索单独观察?
八、如果现在让我优化一个 B2B 独立站,我会先做什么?

如果目标是让一家外贸企业的网站更容易被搜索系统发现,并争取更多 AI 搜索曝光,我不会第一步就研究所谓的“AI 推荐算法秘籍”。
我会先做下面这些比较具体的工作。
第一,检查网站能不能被正确访问。
包括 robots.txt、HTTP 状态码、服务器防火墙、CDN 规则、页面访问权限以及重要内容是否依赖 JavaScript。
至少要保证希望公开的核心内容能够被目标爬虫正常获取。
第二,检查网站信息是否表达清楚。
例如一家工业设备企业,网站不应只有 Home、About、Products、Contact 四个空泛栏目。
应该尽可能清楚地说明产品类别、具体型号、适用材料、应用行业、技术参数,以及真实具备的生产和服务能力。
我希望搜索系统在读取页面后,至少能判断这家公司到底解决什么问题。
第三,围绕采购决策完善内容。
产品介绍是一方面,更重要的是把客户采购过程中可能产生的问题讲清楚。
例如设备选型、不同方案的区别、工艺适用范围、维护方式、常见故障与技术限制。
尽量提供真实、可核验的资料,而不是批量制造换个标题就能重复使用的文章。
第四,让重要信息具备明确的来源和结构。
例如规范页面标题、清晰的内容层级、合理的内部链接、规范 URL,以及适用时准确使用结构化数据。
涉及技术参数、认证、测试结果等内容,我更倾向于明确其来源、适用条件和更新时间。
结构化数据并不能保证 AI 引用,但清晰的内容结构本身是值得做的基础工作。
第五,把 SEO 和 AI 搜索的表现分开观察。
Google Search Console 可以帮助了解 Google 搜索中的抓取、索引和搜索表现。
服务器日志可以帮助分析不同 User-Agent 的访问行为。
如果想评估 AI 搜索表现,还需要观察目标问题下的品牌提及、域名引用、引用页面以及推荐语境。
而且不能只问一个问题、看一次结果,就宣布 GEO 成功了。
至少应该覆盖品牌词、非品牌问题、产品问题以及实际采购场景,并进行持续观察。
最后还得回到业务结果:这些曝光有没有帮助客户了解企业,有没有带来有效访问和询盘?
毕竟,我做独立站的目的不是让机器人觉得网站很优秀。
而是为了让真正有需求的客户找到企业。
九、还有一个容易被忽略的问题:AI 抓了我的内容,我还能控制吗?

这件事其实比想象中复杂。
我们前面讲过 robots.txt。
但需要特别强调:
robots.txt 不是版权许可证,也不是网站的安全防盗门。
IETF 的 RFC 9309 标准明确指出,robots.txt 的规则不是访问授权机制。
换句话说,网站没有禁止爬虫访问,并不意味着网站所有者已经同意任何公司拿内容去做任意用途。
反过来,robots.txt 也无法替代真正的登录认证、访问权限和数据安全措施。
尤其是企业自己的客户资料、未公开产品设计、供应链数据、报价信息等。
这些敏感内容不应该仅仅依靠 robots.txt 保护。
该做权限控制的,还是要老老实实做。
更麻烦的是历史数据。
假设某个网页以前已经被抓取,而且可能进入了某些训练数据来源。
现在你修改 robots.txt,禁止未来访问。
这并不意味着已经进入历史数据集的内容会自动消失。
对于搜索引擎或者外部检索库来说,处理特定 URL 的删除通常有相对清晰的数据边界。
但对于已经经过训练、影响模型参数的数据,目前很难像删除数据库记录一样,精确证明某个训练样本的影响已经被彻底清除。
这也是 AI 训练数据删除和机器遗忘技术仍然需要研究的重要原因。
至于版权是否合法,不同国家和司法辖区也存在不同规则。
例如欧盟 AI Act 对通用 AI 模型提供者提出了版权合规和训练内容摘要等要求;中国的生成式 AI 相关规定也强调训练数据来源合法性、知识产权和个人信息保护。
这不是靠在 robots.txt 里写两行代码,就能把所有问题解决的。
对于外贸企业,我的建议是区分两个目标:
一方面,你希望品牌和公开的产品内容尽可能被潜在客户发现。
另一方面,你也需要保护企业真正有商业价值、不能随意公开的数据。
这两个目标完全可以同时存在。
没有必要为了追求 AI 可见度,把工厂所有商业资料都放到网上。
十、最后
我越来越觉得,很多人对 GEO 的焦虑,其实来自把过去做 SEO 的思路直接搬到了 AI 上。
以前我们希望 Google 收录页面。
所以现在,我们也希望 AI“收录”页面。
以前我们关注关键词排名。
所以现在,我们想知道自己的品牌在 AI 里排第几。
但这两套系统并没有完全相同的工作方式。
AI 可能利用模型训练中获得的知识回答,也可能使用实时检索找到外部信息,还可能在同一次回答中结合多种来源。
对于网站所有者来说,我们能够控制的主要是自己公开了什么内容、内容是否可访问、信息是否准确,以及如何管理爬虫和数据使用权限。
至于某个具体模型训练时到底使用了哪些网页,以及为什么某次 AI 回答引用 A 网站而没有引用 B 网站,很多内部细节并不公开。
这也是为什么我不太相信那些号称只需要安装一个插件、修改一个文件,就能保证被 ChatGPT 推荐的方法。
如果真有这么简单,大家以后就不用研究产品、内容和客户需求了。
全世界的网站管理员每天上班第一件事,就是给 AI 烧香和检查 robots.txt。
我更倾向于把 GEO 看成一项长期工作。
它需要技术基础,也需要内容质量,还需要对搜索产品、用户问题和业务结果进行持续观察。
而不是某一天在服务器日志里发现 GPTBot,便认为自己的品牌已经获得了 AI 时代的入场券。
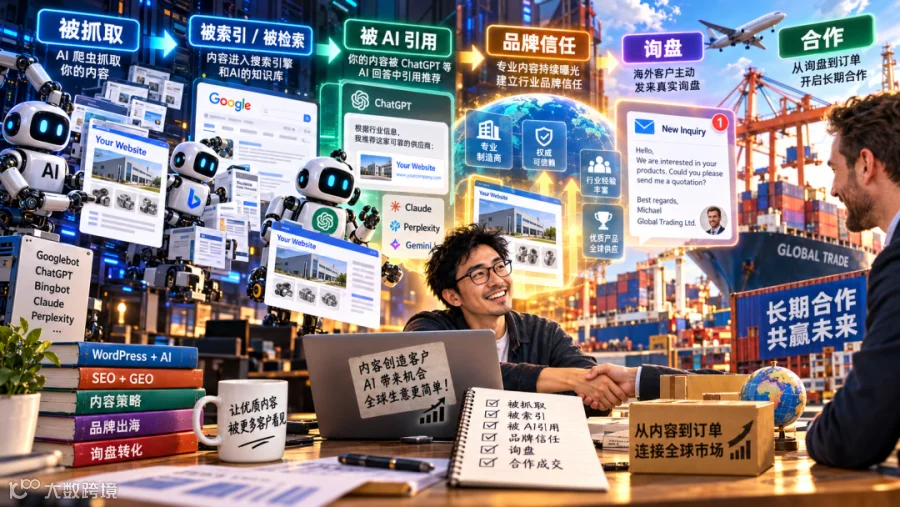
被爬虫发现,只代表它可能看见了你;被 AI 引用,才代表你的内容可能在某次回答中派上了用场;被客户信任并发来询盘,才是真正接近商业价值的那一步。
说到底,外贸独立站最终还是要服务真实的采购需求。
至于 Googlebot、GPTBot、CCBot 这些机器人,可以把它们当成不同岗位的访客。
该给它们开的门打开,该保护的内容保护好。
然后把精力放回产品、网站内容和客户真正关心的问题上。
毕竟,我们是做外贸的。
不是专门给爬虫提供自助餐的。
2026年了,我发现SEO最该优化的,居然不是关键词!
为什么我用的AI总是废话连篇?试试这几种方法让你的AI变强!
做了10年独立站,我受够了那些“反人类”的SEO工具,干脆自己造了一个