搜索
首页
大数快讯
大数活动
服务超市
报告
跨企查
广告开户
APP
产业带
导航
知识体系
工具箱
产业园
更多
百科
找货源
跨境招聘
DeepSeek
首页
>
DeepSeek开放搜索API实测:引用源77% 来自前10条搜索结果
>
DeepSeek开放搜索API实测:引用源77% 来自前10条搜索结果
贞元全网营销
2026-10-29
3
导读:做GEO的人都绕不开一个问题:AI为什么引用这篇,而不是那篇?铺了很多内容,品牌却没被推荐,是内容没有被搜到,还是搜到了却没能成为推荐理由?
做GEO的人都绕不开一个问题:AI为什么引用这篇,而不是那篇?
铺了很多内容,品牌却没被推荐,是内容没有被搜到,还是搜到了却没能成为推荐理由?下一步应该补内容、换渠道,还是调整产品表达?
这些判断,会直接影响后续的执行方向。
我们知道,AI生成答案是「
改写 - 检索 - 重排 - 生成
」的过程,品牌最终有没有被推荐,是这条链路共同作用的结果。
我们能够监测到改写的检索词和最终生成的回答,而中间这两步才决定了谁能被引用。
最近,
DeepSeek
和元宝相继开放了搜索API,这对我们GEO工作来说,多了一层归因的路径,
多了一组可以检查和验证的过程信号。
我们可以沿着检索词查询搜索结果,查看页面的排名、摘要和评分,再与监测到的信源进行对照。
我拿一批数据做了一次测试,具体测试过程我就不说了,直接说几个主要发现:
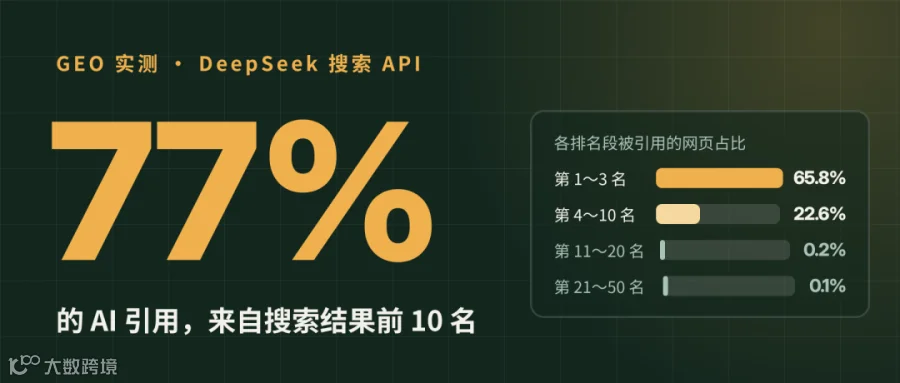
发现一:近八成信源集中在前10名,前3名优势更明显
228条引用中,175条出现在对应检索词的前10名里,占76.8%。排在第1~3名的网页,65.8%被引用;第4~10名降到22.6%;从第11名开始,引用率几乎为零。
这里可以得出一个推测:
DeepSeek每个检索词大约只看前10条结果
。
所以GEO的分析工作要
先看核心检索词的前10名,再重点研究前3名。
前3名被哪些页面占着?它们回答了什么问题、给了什么证据?自己的内容比它们缺了什么?这些都可以成为具体的优化任务。
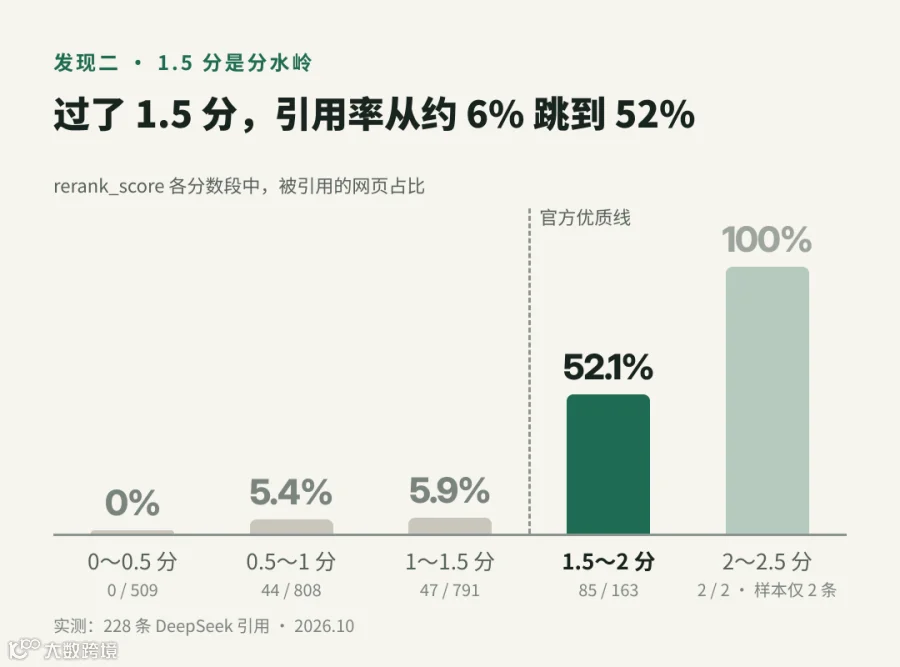
发现二:1.5分是分水岭
DeepSeek的官方文档说,排序分数rerank_score在1.5分以上算“高
质量
结果”。我们实际测试中,也确实是这样,1.5分以下的网页引用率只有5%左右;过了1.5分,直接跳到一半以上。
当然,rerank_score综合了相关性、权威性和时效性,不是把内容写得贴题就能拿高分。
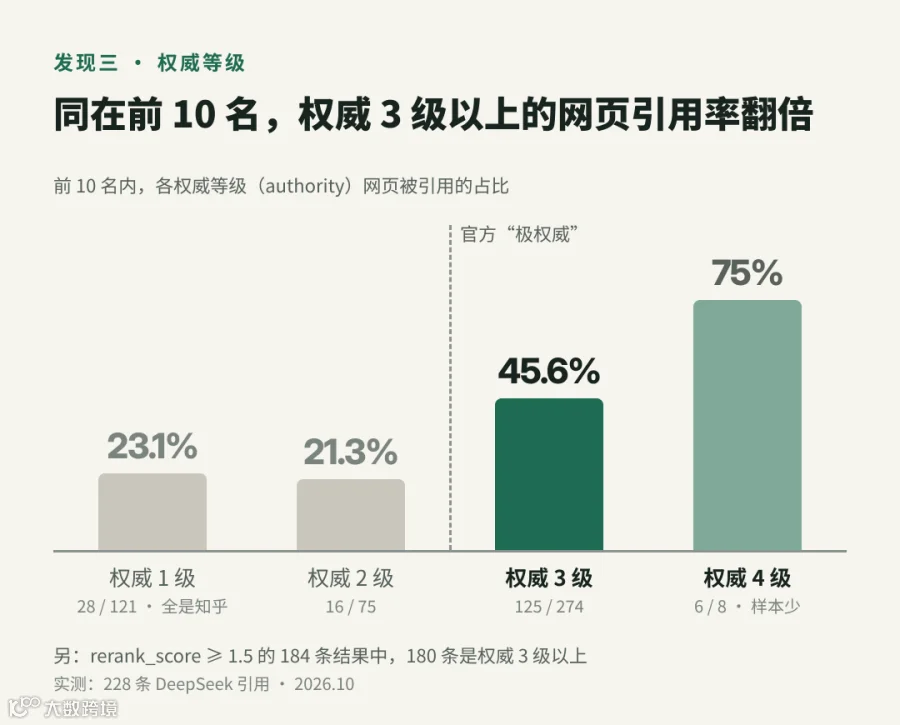
发现三:同在前10,权威3级以上的网页引用率翻倍
DeepSeek搜索API的每条结果还会返回一个authority字段,也就是网页权威等级,取值0~4,官方把3级以上定义为“
极权威
”。
前10名内,3级网页的引用率是45.6%,4级是75%,1~2级只有两成出头。被召回的178条引用中,133条来自3级以上的网页,占75%。
而且
高分结果明显集中在高权威等级网页中
:全部2700条结果中,过了1.5分的184条里有180条是3级以上;1~2级的1708条结果,只有4条过了1.5分。这说明,研究排序分时,权威等级是一个不能忽略的因素。
这些发现对我们GEO工作,带来了哪些变化?
第一,把检索词分析加入问题诊断。
用户问一个问题,AI实际会去搜好几组词。真正决定引用的,是这些检索词下的搜索结果。所以诊断问题时,要把用户问题和它对应的检索词关联起来,看看这些词下现在是哪些页面在出现。
还要注意,同一个问题重复提问,检索词可能会变,来源也会跟着变。不要把一次的检索词当成固定答案,需要持续观察。
第二,在最终效果之外,增加过程指标。
品牌提及率、推荐位次、准确度,仍然用于观察最终呈现。核心检索词的前10名覆盖、前3名位置、评分分布,则可以作为过程指标,帮助GEO团队更早发现问题。
例如,相关内容很少出现在搜索结果中,就优先检查可访问性、内容匹配和渠道表现;搜索表现较好却没有形成品牌推荐,就对照页面内容与回答,看看里面的事实和证据,够不够支撑AI选择你的产品。
这会让“下一步做什么”有更具体的依据。
第三,用配对观察验证调整。
修改内容、更新资料或调整发布渠道之后,再看搜索表现与最终回答是否发生变化。
如果搜索表现改善,而品牌推荐没有变化,就继续研究内容如何支持推荐;如果两者都没有改善,就重新检查当前优化思路本身。
这样,执行、观察、判断和调整才能连成闭环。
当然,这次搜索接口的对照,提供的是更好的观察条件。真正的优化效果,需要通过后续行动和持续监测来验证。
我认为,GEO的确定性,就是在这样的过程中逐步增加的。
随着
工具
开放,GEO
服务
商也需要进一步回答:拿到这些数据之后,怎样提出有依据的解释,怎样决定下一步行动,又怎样判断行动是否有效?
如果你想知道自家品牌在核心检索词的前10名里有没有位置,欢迎找我聊聊,我可以用同样的方法帮你测一次。
【声明】内容源于网络
0
0
贞元全网营销
1234
内容
63
粉丝
0
关注
在线咨询
贞元全网营销
1234
总阅读
755
粉丝
0
内容
63




 贞元全网营销