

在市场波动加剧、消费需求快速迭代、供应链链条日趋复杂的当下,需求预测早已不是简单的销量估算,而是串联采购、生产、仓储、物流、销售全链路的核心起点。精准的需求预测,是平衡缺货损失与库存积压、缓解牛鞭效应、提升供应链韧性的底层抓手;预测失准则会引发连锁浪费:库存高企占用资金、热销品断单丢客、产能错配、供应商排产紊乱,最终侵蚀企业利润与市场竞争力Oxford Aca...。
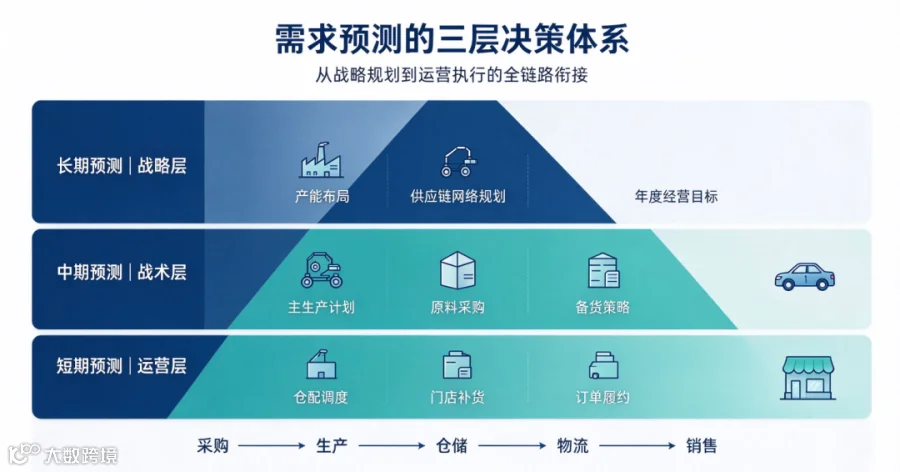
需求预测,是依托历史销售数据、订单信息、市场特征、季节周期、促销计划、竞品动态等内外部信息,借助定性、定量工具,对未来一定周期内客户商品需求量做出预判的管理活动。它覆盖三层决策周期:长期预测支撑产能布局、供应链网络规划;中期预测指导主生产计划、原料采购与备货;短期预测用于仓配调度、门店补货、订单履约,贯穿供应链战略、战术与运营全维度。
传统需求预测分为定性预测与定量预测两大体系。定性预测依靠业务经验,包括销售团队集体研判、专家访谈、市场调研、德尔菲法等,适合新品、新赛道、缺少历史数据的场景,优势是灵活,短板是主观性强、容易受经验偏见影响。定量预测以数据为基础,常见方法有移动平均、指数平滑、ARIMA 时序模型等统计方法,适合需求平稳、周期性清晰的成熟品类,在稳定环境下成本低、落地简单。但传统模型存在明显局限:大多只使用历史销量单维数据,难以捕捉促销、天气、舆情、消费偏好突变等非线性因素;面对碎片化订单、多 SKU、间歇性需求、直播电商脉冲式订单时,误差会显著放大,也很难应对供应链扰动带来的需求偏移。

随着数字化技术落地,机器学习与深度学习正在重构需求预测体系。XGBoost、随机森林等算法可以批量纳入价格、营销、节假日、区域特征等多维变量;LSTM、时序卷积网络等深度学习模型擅长捕捉长周期时序规律与季节性波动;集成学习框架融合多模型输出,进一步提升预测稳定性。新一代预测不再是静态输出一个数字,而是输出需求分布、波动区间与概率,帮助计划人员识别高风险 SKU。与此同时,协同预测(CPFR,协同规划、预测与补货)理念逐步普及:品牌方、经销商、渠道商、上游供应商打通数据,消除各环节单独预测层层放大偏差的问题,从源头削弱牛鞭效应,实现上下游同步计划Semantic S...。
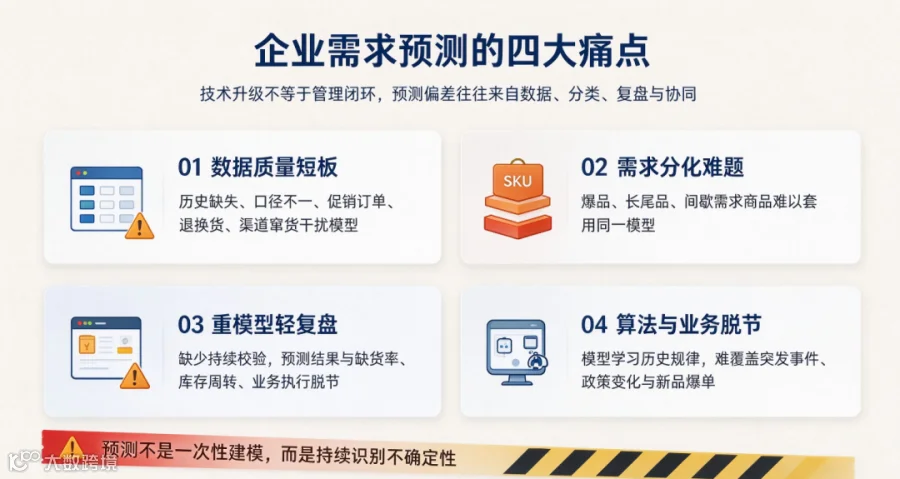
即便工具持续升级,企业做需求预测依然普遍面临痛点。第一,数据质量短板:历史数据缺失、口径不统一、促销订单、退换货、渠道窜货等脏数据干扰模型;第二,需求分化难题:海量 SKU 特征差异巨大,爆品、长尾品、间歇需求产品不能套用同一套模型;第三,“重模型、轻复盘”:很多企业只关注预测模型搭建,缺少持续闭环校验,没有定期跟踪 MAPE(平均绝对百分比误差)、偏差率、缺货率、库存周转等指标,预测结果和业务执行脱节;第四,过度依赖算法,忽略业务判断。模型只能学习历史规律,无法预判突发事件,政策变化、突发事件、新品爆单等场景下,依然需要业务专家对预测结果做人工纠偏。

一套成熟可用的需求预测机制,一定是 “算法 + 业务” 的闭环管理体系。首先做好数据底座建设,统一 SKU、时间、渠道口径,清洗异常订单,搭建包含内部经营数据与外部市场信号的特征库;其次分类施策,对不同需求模式的商品分模型管理,稳定款用统计时序模型、波动款用机器学习模型、新品与小众品类结合专家定性判断;建立分层预测机制,先做总需求预测,再下钻到区域、仓库、门店、SKU;最后形成复盘迭代机制,定期拆解预测偏差,区分偏差来源是市场变化、营销异动还是模型缺陷,持续迭代特征、参数与业务规则。预测不是追求百分百准确,而是持续缩小偏差、识别不确定性,给供应链预留柔性缓冲空间。
面向未来,需求预测正在走向实时化、协同化、智能化。实时数据流、物联网信号、线上舆情、流量数据的接入,让预测从按月、按周更新转向滚动更新;隐私计算、联邦学习等技术,可以在不共享原始敏感数据的前提下实现上下游联合建模,解决产业链协同的数据信任难题;预测也不再单独服务库存,而是和 S&OP 销售与运营计划、产能排程、供应链金融联动,成为企业经营决策的信号中枢。
供应链的本质,是在不确定的市场里做有序的资源匹配。需求预测不是预言未来,而是把不确定性量化、可视化。优秀的需求预测能力,能让企业告别 “凭感觉备货、追单救火、清仓甩卖” 的被动模式,在多变市场里,以更低库存成本保障交付稳定,构建供应链的差异化竞争优势。