





很多大模型在走出实验室的那一刻,它的能力边界就已经被框定。
它能检索、能写反思、能把上一次失败写进上下文,但那些经验并没有真正改变它“理解世界、构建能力”的方式。
AI 会翻旧账,却不一定长本事。
这正是赛砥英科想拆掉的那道墙。
这家由上海启迪之星高质量孵化器从强化学习理论的重要发源地引入上海的团队,做的不是“再训一个大模型”,而是把智能的源头,从“人类写过的东西”挪到“智能体在环境里交互出的体验”。


一、他们从哪来:RL学派的摇篮
赛砥英科核心团队源自加拿大阿尔伯塔大学 RLAI 实验室——强化学习奠基人、图灵奖得主 Richard Sutton 创立的地方。
这里走出了 DeepMind 系研究者,也沉淀了现代 AI 决策范式的底层根系。
团队里既有前 DeepMind PI、AAAI Fellow,也有华为北美 AI Lab 创立者、千万级用户游戏 AI 负责人、国家重点专项主持者。
学术端:清华及清华系生态、国家级高层次人才;
产业端:游戏、自动驾驶、机器人、终端设备一手落地;
资本与算力端:头部 AI 生态基金、完整训练—部署链路。
所以他们讲“RL 不是微调技巧”,是有底气的。
二、静态数据见顶后,智能靠什么续命?
Ilya Sutskever 在 NeurIPS 2024 说得很直白:
我们所熟悉的预训练范式,终将结束。
互联网级高质量数据,像化石燃料——烧得完。
于是卡住 AI 的有三件事:
1. 长程任务的组合爆炸
任务越长,依赖越多,一步错、步步错。不是“知不知道”,而是“能不能把知识串成一致的逻辑链”。
2. 开放世界的无限状态
真实环境永远有训练集没覆盖的情况。模型不能只调用旧知识,还得敢探索、会判断“这次试错值不值”。
3. 经验的停滞
模型可以多轮试、看反馈、改答案——但任务一关,经验就没了。
产生经验 ≠ 持久学习。

三、他们的答案:全栈 RL,让智能“越用越活”
赛砥英科说的 RL,不是只放在训练末尾做对齐的 RLHF。
RLHF 让模型“更乖”,他们要的是让模型“更强”。
Sutton 与 David Silver 在《Welcome to the Era of Experience》里点明:
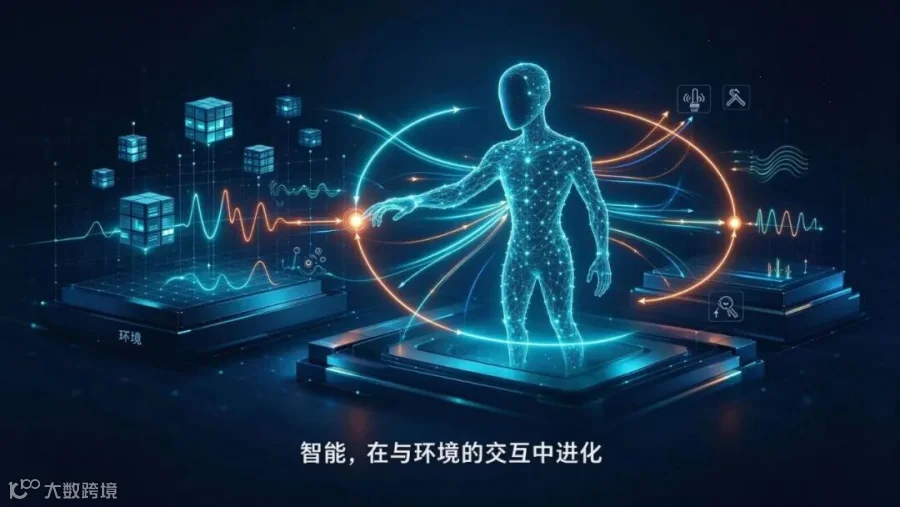
未来 AI 的能力,不再只来自人类语料,而来自智能体与环境交互出来的经验。
不是“先有智能,再去行动”;
而是——
行动 → 预测 → 学习 → 规划 → 再行动。
赛砥英科把这条路拆成三层:
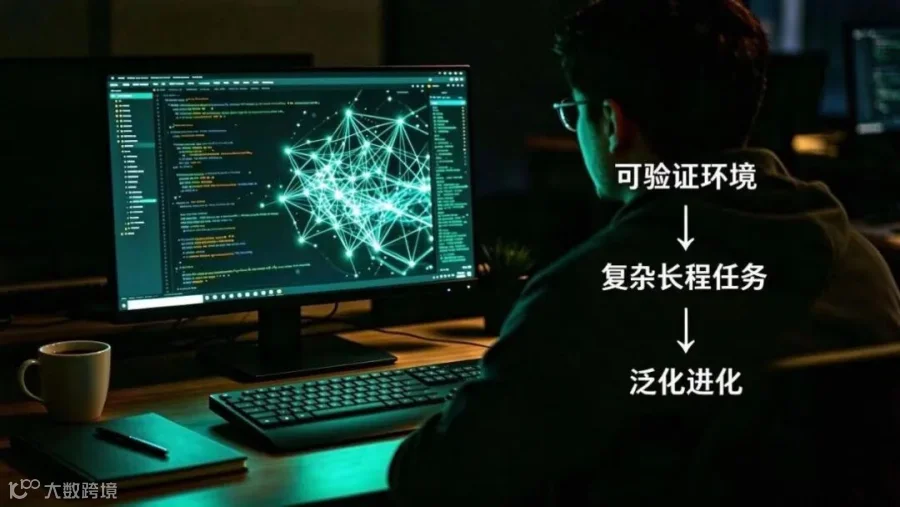
• 可验证环境里先学会学习:规则清、反馈准,不让模型瞎编;
• 啃长程复杂任务:多步推理、失败回滚、路径重规划;
• 泛化进真实世界:游戏、机器人、自动驾驶、科学发现,都是试验场,不是终点。
三层之外,他们还把目光投向两件事:
一是让持续学习形成闭环。不只是让模型学得更多,更要让 "学习怎么学" 本身变得更高效
—— 自己发现短板、生成训练任务,筛选真正有效的改进。
二是专家能力融合(Ensemble RL)。不同领域的专家各有所长,关键是让这些能力互补协
同,而不是堆在一起互相打架。
全栈的含义就一句:
环境、算法、架构、训练系统、推理部署,一起设计,不让经验死在上下文里。
四、模型决定“毕业时多强”,经验决定“后来成了谁”
赛砥英科有句话很锋利:
模型决定一台 AI 从实验室毕业时能做什么,而经验,决定它后来会成为什么。
这也是为什么他们不像普通 AI 公司那样,把“发版”当成终点。
他们要的是部署之后的持续进化:
模型进真实世界,在真实环境的交互中持续学习。
游戏里学策略,机器人里学控制,自动驾驶里学边界,科学发现里学习生成假设——
这些都不是“再喂点数据”能解决的,得让智能体自己撞、自己纠、自己抽象。
为什么是现在,为什么是上海
数据红利在退潮,体验红利刚涨潮。
加拿大阿尔伯塔给了理论根,上海给了场景、算力、产业链和真实甲方。
赛砥英科被上海启迪之星高质量孵化器引入上海后,真正有意思的不是“又一家 RL 公司来了”,而是——
RL 发源地的持续学习范式,开始在上海的产业土壤里找题目。
智能的上界,不该由“人类历史里有多少文本”定死。
它该由一个问题决定:
这个系统,敢不敢在真实世界里继续学下去?
赛砥英科的答案,是敢。
接下来要看的,不是它会不会说话,而是它摔过几次之后,会不会真的变聪明。
点击
阅读原文
了解赛砥英科的更多资讯


来源:赛砥英科


敬请关注

启迪出海
如有对接需求,可咨询:

张玉民 项目经理
邮箱:zhangym@tusstar.com
微信号:myz8991

林诗雨 项目助理
邮箱:linsy@tusstar.com
微信号:sisselxixha-