

导读视频生成关注按条件合成视听内容,世界建模关注表示环境并预测其变化。两者可以由同一模型承担,也可以共享技术;面向智能体和机器人时,关键还在预测能否反映行动后果、支持后续决策。本文以 Seedance 2.5 与 Genie 4 为例,从目标、控制、反馈和验证讲清区别,避免把“能生成视频”与“能可靠模拟环境”混为一谈。
本文 2785 字,阅读约 7 分钟
目标不同,技术可以重叠
都能用自然语言控制,交互又差在哪里?
到了智能体这里,画面变成了反馈
能生成合理画面,为什么还不够?
判断区别,最终要看结果怎样被使用
目标不同,技术可以重叠
2026 年 10 月 27 日,Google DeepMind 发布 Genie 4 研究预览,展示了键盘导航、用自然语言改变场景,以及同步生成声音。它被称为世界模型,但输出也是连续画面。这与 Seedance 这样的视频生成模型,有什么区别?
先看两个任务。制作广告时,你输入“镜头从湖面推向一位演奏者”,希望得到符合创作意图的片段。让智能体在房间里寻找椅子时,你还需要知道:向左转会看到什么,沿这条路走能否接近目标,椅子离开视野后是否仍在原处。
前一个任务把视频作为作品;后一个任务把环境变化作为行动依据。两者关心的结果不同,对预测的要求也就不同。
视频生成模型按文本、图像、视频等条件合成后续内容。生成任务不只要求画面好看,还可能要求准确执行指令、保持人物与运动连贯,以及符合用途所需的物理关系。广告、过程演示和训练素材,对这些要求的权重可以不同。
世界模型则尝试建立环境的内部表示,预测环境怎样演化;面向行动的模型还要预测“采取这个动作之后,会发生什么”。它保留的是任务需要的状态和规律,不需要完整复刻整个世界。
世界模型的定义尚未统一,并不都接受动作输入、实时运行或生成视频。下表比较两种功能目标,列出不同模型可能采用的输入输出形式,具体能力仍要看各自实现。
以输出为例,Genie 4 公开展示的是随操作持续生成的画面与同步声音;机器人世界动作模型 UNITAS 则用三维点轨迹表示机器人运动与场景响应。因此,表中的压缩特征、三维轨迹等形式,不应理解为 Genie 4 都能直接导出。模型内部的表示与对外提供的输出接口,也需要分别确认。
同一模型也可能兼具两种功能。OpenAI 的 Sora 技术报告就讨论过视频模型对人、物体及环境部分行为的模拟,同时指出物理模拟仍有局限。
视频记录了运动、遮挡和交互后果,学习生成连续画面,可能积累一部分环境规律。这使视频生成成为视觉世界建模的一条相关技术路线。功能可以重叠,仍须分别验证生成质量和预测误差。
都能用自然语言控制,交互又差在哪里?
理解了目标差别,再来看最容易混淆的功能:控制。视频生成并非只能输入一句话、等待整段结果;它也可以使用参考素材,编辑或续写已有片段。
Seedance 2.5 支持多轮续写和按时间点指定编辑要求。在官方运镜案例中,用户要求保留人物、动作与风格,只调整镜头运动。
 Seedance 2.5 官方运镜编辑案例,动图由官方视频转换,展示参考片段与编辑结果 | 来源:字节跳动 Seed 团队
这里,“修改视频第 4 秒的镜头”指定的是成片中的位置。它不等于系统运行到第 4 秒时,才接收新的操作。
Genie 4 的官方演示展示了运行中干预:一位萨克斯演奏者身处湖边,用户在场景推进时输入下雪指令,随后出现雪花,人物身上逐渐积雪;演示还显示了键盘导航控件。
 Genie 4 官方交互演示:用户输入下雪指令后的连续片段,动图由官方视频转换 | 来源:Google DeepMind
自然语言控制的关键差别,在于输入时机、场景延续和反馈方式。编辑片段与运行中干预,对系统提出了不同要求。

以上是官方案例,本文未独立测评。它们用于对照两种工作流;是否支持运行中交互,要核对具体版本和接口,不能只凭模型类别判断。
到了智能体这里,画面变成了反馈
为什么输入时机和场景延续会影响用途?继续看寻找椅子的例子。智能体查看当前画面,看不到椅子便发出转向动作;环境返回新的画面,它再决定继续转向还是靠近目标。画面在这里是智能体的“观测”,并不包含环境的全部状态。
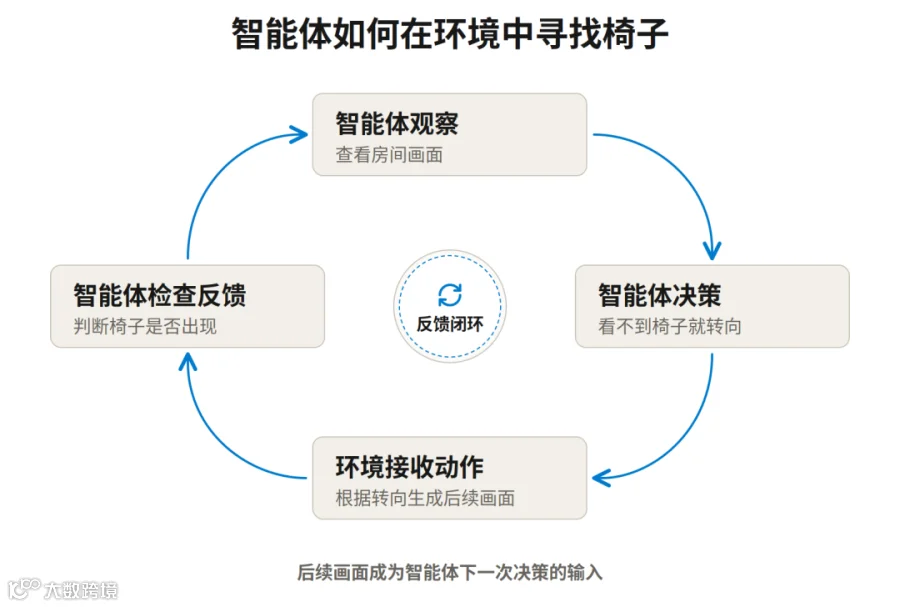
与创作者看完片段再修改相比,这个循环要求动作后的变化持续成为下一次决策的输入。如果响应太慢,或者动作与画面关系不稳定,智能体就难以依赖反馈。
DeepMind 披露,Genie 4 的协作系统中,Gemini 3.8 Flash 会查看生成画面、拆解目标、检查进度,并随场景变化调整计划;Genie 4 负责生成视听内容。这展示了决策与环境生成可以怎样配合,尚不能据此确认任意任务中的可靠性。
世界模型也可以用于执行前的预演:先预测几组候选动作的后果,比较哪组更接近目标,再执行选中的动作,并根据新观测重新规划。这时,预测直接参与行动选择。机器人操作中,模型可能需要判断夹爪怎样移动能抓住杯子,而不只是生成“杯子被拿起来”的画面。
无论提供交互环境,还是参与执行前预演,世界模型的预测都要与决策、执行及实际反馈配合,才能形成完整的行动过程。这些职责可以由不同模块承担,也可以部分集成在同一模型中。
能生成合理画面,为什么还不够?
视频生成和世界建模都可能关心物理合理性。把生成结果用于行动时,还需要确认:观测是否忠实、动作后果是否准确,以及误差是否会改变决策。
寻找椅子时,如果智能体转身后椅子无故消失,它可能走错路。操作杯子时,如果夹爪抓空,模型却仍预测杯子升起,就会把失败当成成功。画面可以流畅,但行动与后果之间的关系已经错了。
这要求模型保持任务相关的状态:物体离开视野后仍保留必要信息;如果它在遮挡期间继续变化,重新出现时也应反映这段变化,而不是简单恢复旧画面。
为了让运动与交互符合物理规律,模型可以从数据中学习,也可以借助显式机制施加约束。例如,系统先用物理模拟器计算运动,再用仿真结果引导视频生成。这两种方式也可以结合使用。“是否加入物理约束”是实现问题,不能直接用来划分视频模型与世界模型。加入约束后,结果是否遵守物理关系,仍须验证。
《World Models’ Last Exam in Physics》评测尝试从生成视频中测量轨迹、周期、角度等量,检验预定义的物理关系。
 物理量测量与理论关系检验流程,裁自论文 Figure 1 第三部分 | 来源:World Models’ Last Exam in Physics 研究团队
图中以两个单摆为例,通过跟踪、分割和信号处理,检验周期与摆长的关系以及周期稳定性。连续性筛查影响物理得分是否计入综合分,测量程序仍会独立尝试提取物理量。能持续追踪小球,只说明具备测量其运动的条件;测出的轨迹是否符合自由落体规律,还要另行检验。
对机器人来说,误差是否可接受,还取决于接触、碰撞等任务要求,并需要真实执行验证。
比较“先走左边还是右边”时,还需要保存、恢复或重建足够一致的实验起点,并记录或控制随机性。记住场景,不自动等于支持可比较的分支推演。相似首帧生成的两个片段,也不保证内部条件一致;Genie 4 的公开演示尚不能证明任意状态都可精确保存和分叉。

截至 2026 年 10 月 29 日,DeepMind 将 Genie 4 作为面向可信测试者的研究预览,并说明连续交互仅支持几分钟,视觉细节与物体持续性仍可能漂移。它展示了交互式生成的进展,适用范围仍须由具体任务验证。
判断区别,最终要看结果怎样被使用
如果目标是广告、短片或概念镜头,重点检查内容、风格、编辑能力和交付质量。如果目标是让智能体练习或让机器人预演动作,就要进一步检查动作后果、状态延续和模拟误差,以及这些预测能否改善训练或执行结果。
视频生成与世界建模的能力可以重叠,交互体验与成片创作也可能结合在同一系统中。评价应跟随用途:既不凭画质认定预测可靠,也不因一个系统被称为世界模型就默认它适合行动。
视频生成关注把条件变成内容,世界建模关注把环境变化变成可检验的预测。当预测用于智能体与机器人时,还要证明它能支持行动。理解这层区别,比只看模型名称、画质或一段交互演示,更能判断系统究竟提供了什么能力。
参考资料
•ByteDance Seed, One-take Creation, Flexible Referencing: Introducing Seedance 2.5: https://seed.bytedance.com/en/blog/one-take-creation-flexible-referencing-introducing-seedance-2-5
•Google DeepMind, Genie 4: A new generation of world simulation: https://deepmind.google/blog/genie-4-a-new-generation-of-world-simulation/
•Google DeepMind, Genie 4: Limitations: https://deepmind.google/models/genie/
•OpenAI, Video generation models as world simulators: https://openai.com/index/video-generation-models-as-world-simulators/
•A Definition and Roadmap for World Models: https://arxiv.org/html/2607.06401
•World Models: https://worldmodels.github.io/
•Motus2: A Self-Evolving General World Model for Dexterous Manipulation: https://arxiv.org/abs/2608.30237
•UNITAS: A 3D-Native World Action Model for Embodied Manipulation: https://arxiv.org/abs/2610.12099
•DreamTrue: Action-Faithful Robot World Model with Counterfactual Post-Training: https://arxiv.org/abs/2610.12468
•Reading, Writing, Sharing, and Interacting with the World through Video: https://arxiv.org/abs/2610.31668
•World Models’ Last Exam in Physics: https://arxiv.org/abs/2610.08791
•Fluid-Gen-Zero: Grounding Pretrained Video Generators in Physics without Training: https://arxiv.org/abs/2610.10984
•World Models for Embodied Intelligence: From Plausible to Controllable to Actionable: https://arxiv.org/abs/2609.16697
蘑菇头表情图片来源:蚊子动漫
文章仅做学术分享,如有侵权请联系删除,非常感谢!