

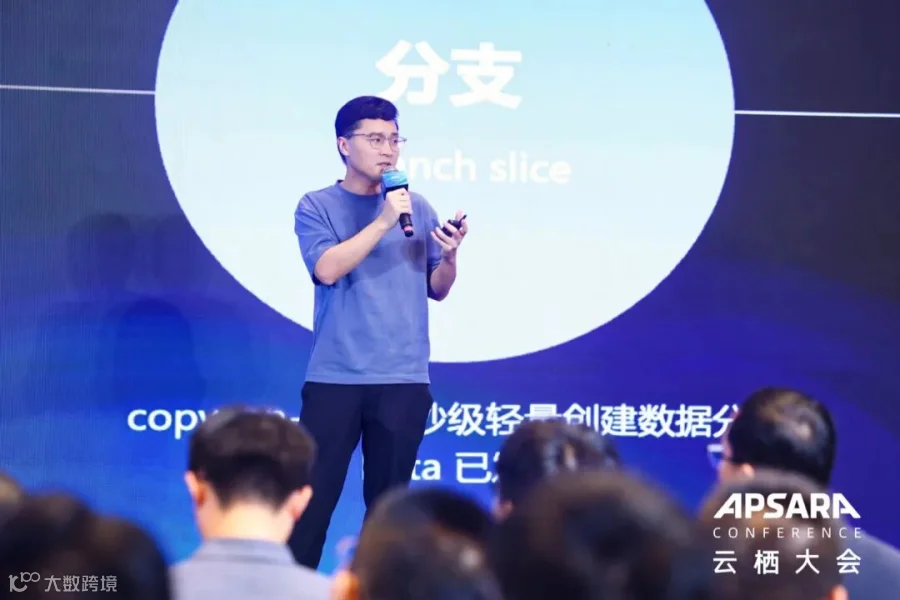
9 月 23 日上午,在 2026 云栖大会 AI 搜索分论坛上,阿里云智能集团高级技术专家杨孔仕发表《面向 Agent 时代的搜索基础设施:亿级租户、千亿向量的阿里云 Elasticsearch Agent 引擎版》主题演讲,系统介绍阿里云如何以对象存储、租户级检索和无状态计算,应对 Agent 应用带来的海量独立检索空间、冷热负载悬殊与持续增长的数据规模。
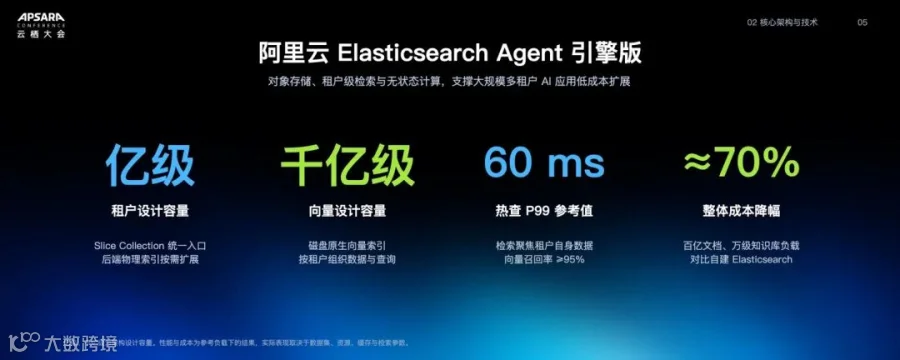
演讲披露,阿里云 Elasticsearch Agent 引擎版按亿级租户、千亿级向量设计架构容量;在百亿文档、万级知识库的参考负载下,热查询 P99 约 60 毫秒,向量召回率 95% 以上,整体成本比自建 Elasticsearch 降低约 70%。
企业知识库、代码工作区、行业资料库和个人记忆,正在成为 Agent 反复调用的外部上下文。它们给基础设施带来一个新矛盾:需要独立检索的数据空间越来越多,数据要长期保存,但同一时刻真正活跃的只是其中一部分。
"数据需要长期保存,资源却不能为每一份数据始终待命。"杨孔仕表示。传统 Elasticsearch 部署中,按租户建索引容易形成海量分片,共享索引又需要额外的租户过滤;向量索引和多副本 SSD 长期占用资源;存算绑定还意味着,扩缩容和故障恢复都要搬迁数据。总数据量不断增长时,如果一次查询仍要触达大量其他租户的数据,无效的读取和计算也会随之增加。
因此,面向 Agent 的搜索基础设施不仅要扩大容量,还要兼顾检索体验、资源弹性和成本。演讲列出的用户目标是:检索 P95 低于 100 毫秒、召回率不低于 95%;而在现有方案的案例中,检索耗时在 1 秒以上(未注明分位)。
Agent 引擎版把索引数据、预写日志(WAL)和元数据统一持久化到 OSS;写入层(索引节点)负责构建索引,查询层(查询节点)负责检索,两层资源可以分别配置。节点本地的内存和 SSD 主要用作缓存和临时空间,扩缩容或替换节点时,无需先搬迁完整数据集。

杨孔仕将这一机制比作"办公桌和资料库":桌面只放当前使用的资料,长期资料保存在库中。活跃租户的数据按需加载进缓存,冷数据留在 OSS;业务也可以提前预热目标工作区,减少首次访问的等待。让资源投入取决于活跃负载、而不是全量数据规模,是降低长尾租户常驻开销的关键。
管控系统会分别观测写入层和查询层的 CPU、内存、磁盘和 I/O 水位。计算资源自动扩容计划于 2026 年 10 月上线,届时可在高水位时补充节点、低水位时回收容量;演讲中的节点数量与增长曲线为机制示意。
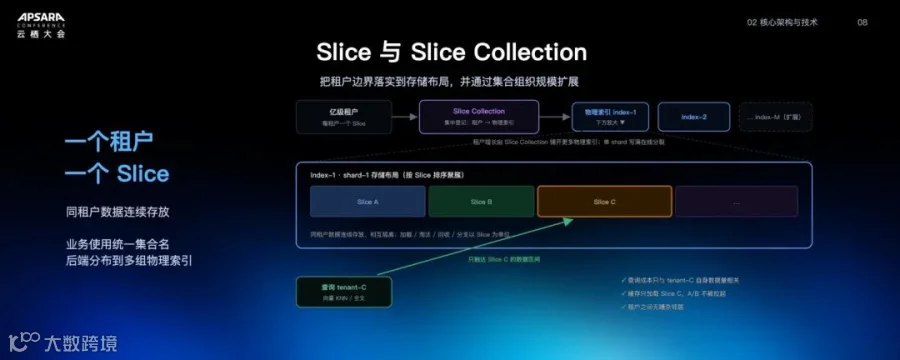
在数据组织层,一个 Slice 对应一个租户的检索空间,Slice Collection 则把大量 Slice 汇聚到一个统一的逻辑入口下,后端物理索引按需扩展。业务无需因为底层索引变化反复修改入口,查询、缓存和预热也能围绕明确的租户边界执行。
向量检索方面,DiskBBQ 先用分层 K-Means 把相近的向量聚成簇,再把向量量化为 1 bit 编码,,按簇顺序写入磁盘,形成可以整块读取的数据。1 bit 编码的位宽是 32 位浮点数的 1/32,但这不等于整体存储压缩了 32 倍。由于不需要建图,DiskBBQ 的构建明显更快:在 100 万向量的基准上,DiskBBQ 用时 94 秒,HNSW 用时 1054 秒,快了约 10 倍。
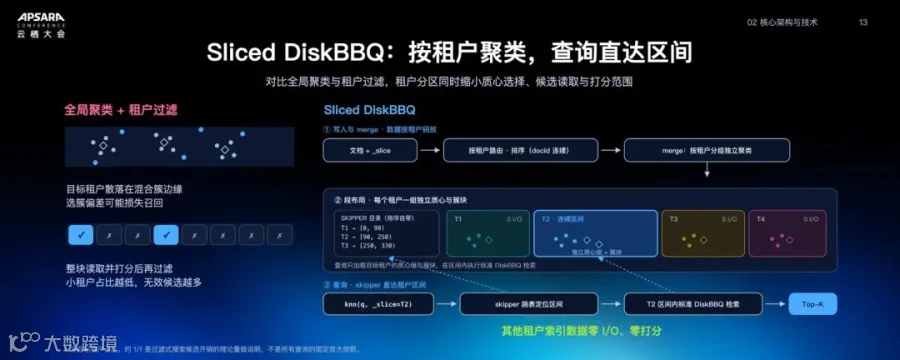
多租户场景下,Sliced DiskBBQ 进一步把租户边界带入向量索引:查询时直接定位到当前租户的数据区间,其他租户的数据零 I/O、零打分。"一个知识库的一次查询,不应该因为其他知识库的增长,而承担越来越多无关的读取和计算。"杨孔仕说。
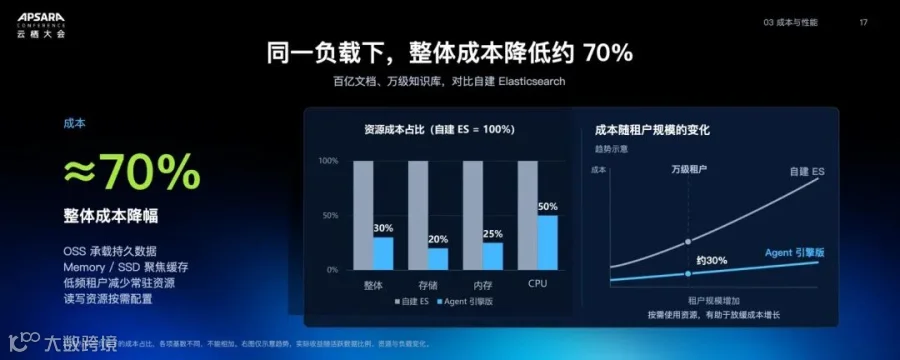
先看成本。以自建 Elasticsearch 的各项成本为 100%,在同一参考负载下,Agent 引擎版整体约为 30%,即降低约 70%;其中存储约 20%,内存约 25%,CPU 约 50%。收益主要来自存算分离和按需缓存,低频租户不再占用常驻资源。
再看查询体验。在同一负载下,Agent 引擎版热查询 P99 约 60 毫秒,向量召回率 95% 以上;自建 Elasticsearch 的延迟和召回率分别约为 2 秒和 70%。冷查询需要从 OSS 读取数据,约 600 毫秒,可以通过预热减少首次查询的等待。

目前,阿里云 Elasticsearch 售卖页已上线 Agent 引擎版的开通入口,用户可以启用 Slice Collection 海量多租户检索,并分别配置索引节点和查询节点。围绕租户的数据空间,产品还提供三项能力:预热(warm slice),在用户打开工作区或进入会话时提前加载数据;复制(copy slice),用于建立独立环境;分支(branch slice),基于写时复制,可以秒级创建轻量分支,目前已发布 Beta 版。

这些能力适用于企业知识库与 RAG、AI Coding、法律和金融等行业 AI,以及 Agent 记忆和手机、车载助手等终端记忆场景。以 AI Coding 为例,每个代码仓库或工作区都是一个独立的检索空间,Agent 执行任务时,可以跨文件检索源码、测试和注释,联合使用向量、关键词与过滤条件。单个数据集的需求是:10 万以上文件,全量索引 P95 不超过 1 分钟,更新间隔不超过 10 秒。
杨孔仕在总结中表示,面向 Agent 的搜索基础设施,核心是让"查询范围由租户自身的数据决定"。当 Agent 数量、知识空间和长期记忆持续增长时,只有让持久数据与活跃计算解耦,并按租户边界组织数据和查询,搜索基础设施才能兼顾规模、体验、成本与运维效率。
注:亿级租户、千亿级向量为架构设计容量。文中性能与成本数据是百亿文档、万级知识库参考负载下的结果,实际表现取决于数据集、资源、缓存与检索参数;成本收益随活跃数据比例、资源配置与访问负载变化。DiskBBQ 的构建加速比随数据集、参数与资源配置变化,分支的实际创建耗时受元数据规模与系统负载影响。
阿里云 Elasticsearch Agent 引擎版:https://help.aliyun.com/zh/es/user-guide/what-is-ai-engine-edition
阿里云 AgenticSearch:https://help.aliyun.com/zh/open-search/search-platform/product-overview/agentic-search-ai-driven-next-generation-enterprise-search
欢迎钉钉扫码入群:

/ END /

点击“阅读原文”体验更多关于大数据&AI产品解决方案