

上百路监控画面同时显示,保安不可能每一路都仔细看;一张大图做压缩,背景和细节都按一个质量压,浪费带宽;目标检测先全图跑一遍,其实大部分区域根本没有目标。这些场景背后都有一个共同需求:先自动找出"画面里哪里最值得关注"。
今天分享的这篇 CVPR2026 论文 SalientLite,提出了一个轻量显著性检测框架:输入一张图,直接输出一张"哪里重要"的概率图——人、车、异常物体这些显著区域高亮,背景弱化。模型只有 3.8M 参数,端侧实时跑,在 DUTS 和 HKU-IS 两个标准数据集上刷新了轻量模型 SOTA。

一、显著性检测到底是什么、难在哪
很多人第一次听到"显著性检测"会觉得抽象。简单说:人眼看图的时候,会自动先注意到突出的物体,而不是平均分配注意力。显著性检测就是让模型模拟这个过程——自动标出画面中最可能吸引人注意的区域。
1.1 显著和不显著的边界模糊
什么叫"显著"没有标准答案。同样一个人,在空旷马路上很显著,在人群里就不显著;一个红色物体在绿叶背景里突出,在红色墙面前就不突出。显著性是相对的、和上下文有关的,不是物体本身的固定属性。
1.2 细边界要求高
显著性检测输出的是像素级掩码——物体边缘要贴得准。大模型(比如基于 Transformer 的方法)效果好但慢,轻量模型往往边界模糊,物体轮廓一圈都是"毛边",不好用。
1.3 多尺度和复杂背景
显著物体可能很大(一辆车占半张图),也可能很小(远处一个行人)。背景纹理复杂的时候,模型容易把杂乱的纹理当成显著区域,或者把小显著目标漏掉。
1.4 落地场景要求快和小
显著性检测经常作为前置模块——在后面再接检测、分割、压缩。如果前置模块本身很重,整个 pipeline 就被拖慢了。所以轻量、快速是落地的硬要求。

二、SalientLite 的三个核心设计
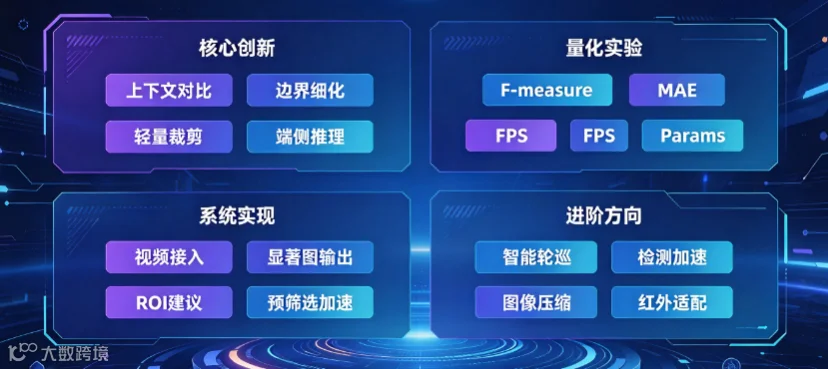
SalientLite 的整体思路:用极轻的 backbone 提取多尺度特征,靠上下文对比和边界细化,在小模型上拿到接近大模型的掩码质量。
2.1 上下文对比特征聚合
判断一个区域显不显著,不能只看它本身,还要看它和周围区域的差异有多大。SalientLite 设计了一个上下文对比模块:
•局部特征:提取当前位置的特征。
•周围背景特征:提取周边大范围背景特征。
•差异对比:当前位置和背景差异越大,显著概率越高;和背景融合在一起,概率就低。
这样模型学到的是"和背景不一样的地方才显著",而不是"某类物体固定显著"——这和人眼的判断逻辑更接近,也能适应不同场景。
2.2 多尺度渐进式边界细化
轻量模型边界模糊的问题,SalientLite 用渐进细化解决:
•先粗后精:深层特征先给出显著区域的大致位置(哪里有人、车)。
•浅层细节上采样:把高分辨率的浅层特征逐层融合进来,修正边缘。
•边界监督损失:训练时单独对物体边缘像素加权,让模型把轮廓学准。
消融实验显示,去掉边界细化和边界损失后,F-measure 掉了 4.6 个点——对于掩码质量来说,边缘就是硬指标。
2.3 轻量化 backbone 专门裁剪
不是拿现成分类模型硬改,而是从零设计轻量结构:
•深度可分离卷积为主:计算量压到最小。
•通道数按需分配:深层语义层通道多一点,浅层细节层少一点,不浪费参数。
•去掉冗余的分类头:显著性任务只需要特征,不需要 ImageNet 分类那套重头。
最终模型 3.8M 参数,掩码质量却接近 20M 级别的传统轻量模型,速度快两倍以上。
三、技术架构拆解
SalientLite 的整体 pipeline 分四个模块:
模块 |
做什么 |
关键设计 |
轻量 Backbone |
提取多尺度特征 |
深度可分离卷积,输出 1/4、1/8、1/16 三层特征 |
上下文对比模块 |
判断区域与背景的差异 |
局部-全局特征对比,输出粗显著图 |
渐进细化解码 |
逐层上采样修边界 |
深浅层特征融合,边缘像素加权监督 |
显著概率输出 |
输出像素级显著概率图 |
0~1 概率值,可按阈值转二值掩码 |
几个工程上的亮点:
•参数量:3.8M,量化后可在摄像头端运行。
•推理速度:512×512 图像在边缘设备上约 18fps。
•输出通用:显著概率图可以直接作为其他视觉任务的权重或 ROI 引导,不需要特定类别标签。

四、和主流方法的横向对比
论文在 DUTS(通用显著目标)和 HKU-IS(多目标场景)两个基准上做了对比:
方法 |
DUTS F-measure↑ |
HKU-IS F-measure↑ |
参数量(M) |
FPS(边缘设备) |
UCF (传统方法) |
0.785 |
0.762 |
0.1 |
60 |
MINet |
0.883 |
0.865 |
16 |
15 |
UCNet |
0.901 |
0.884 |
22 |
10 |
SalientLite |
0.897 |
0.881 |
3.8 |
35 |
可以看到,SalientLite 的 F-measure 和大模型 UCNet 基本持平,但参数量只有它的 1/6,速度快了 3 倍多。作为前置模块使用时,这种"精度接近、速度快得多"的特性非常合适——先快速找出重点区域,再在局部跑重模型精细分析。
五、快速上手:推理核心代码
下面是 SalientLite 的推理框架,帮大家理解整体流程:
python |
实际落地时,最常见的用法是"两级 pipeline":SalientLite 先快速标出疑似重点区域,再把这些 ROI 送到检测、识别等重模型里精细判断。这样整路视频的算力开销能降下来,误报也会减少。
六、毕设/竞赛拓展方向
显著性检测这个方向做毕设,Demo 效果直观(热力图一眼能看懂),而且可以和很多下游任务结合。分享几个有价值的拓展点:
6.1 监控画面智能轮巡筛选
多路监控画面实时计算显著性分数,自动弹出画面中变化大、有目标出现的路数给保安看,安静画面降低显示优先级。做成智能值守辅助系统,实用性很强。
6.2 显著性引导的小目标检测加速
先用 SalientLite 找出候选区域,再在局部跑小目标检测器。既保留小目标召回率,又比全图检测省算力,和 TinyDet 这类方法可以组合成完整方案。
6.3 图像内容自适应压缩
显著区域保持高质量、背景区域降低码率,用于监控录像存储和视频带宽优化。结合视频编码标准做实验,工程价值明确。
6.4 夜景/红外图像显著性
常规显著性数据集都是白天可见光图,夜间监控和红外画面的显著性分布不同。专门收集低照度、红外数据做适配训练,是一个有新意且贴近安防场景的小方向。
七、写在最后
显著性检测本身不直接"完成"某个业务动作,但它是一个很好的效率杠杆:把有限的算力和人力集中到真正值得关注的区域。做系统设计的时候,前置一个轻量注意力筛选层,往往比直接堆重模型更划算。
SalientLite 给我的启发是:轻量不等于将就。专门为任务设计的小结构,配合对比建模和边界细化,完全可以在特定指标上接近大模型。做工程方案选型时,先想清楚这个模块在整个 pipeline 里承担什么角色,再决定需要多大的模型。
做毕设的同学如果选这个方向,建议先拿一个公开显著性模型跑通热力图效果,再结合一个下游应用(检测加速、智能轮巡、压缩优化)做完整方案。单独讲"我训练了一个显著性模型"不如讲清楚"它帮系统提升了多少效率"有说服力。
大家如果有复现上的问题或者想聊具体的落地组合方案,欢迎评论区交流。