

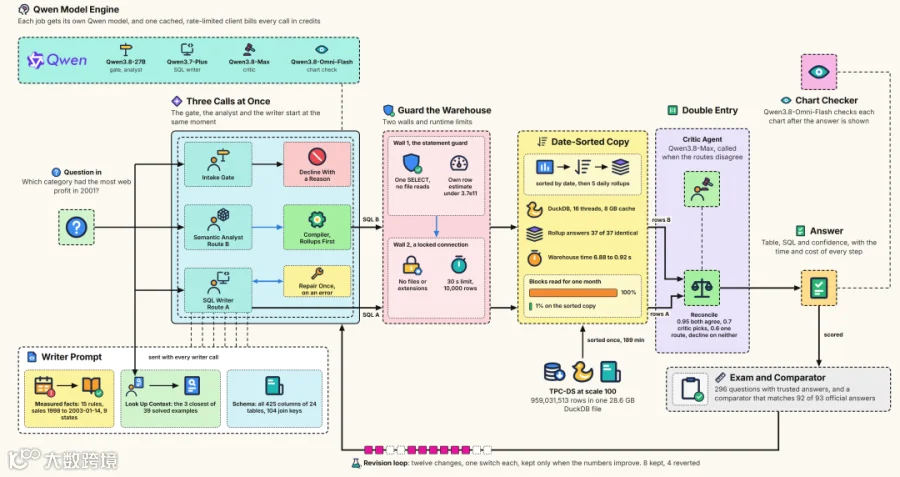
为了正确测试这一架构,我们首先必须在消费级硬件上复现它。我会使用尽可能精简的配置:一台没有 GPU 的 16 核笔记本电脑、一个 DuckDB 文件,以及通过 OpenAI-compatible endpoint 提供的 Qwen 模型。我们将按需求顺序构建以下组件:
笔记本电脑上的数据仓库:一个 28.6 GB 的 DuckDB 文件,包含 959,031,513 行。
一把尺子:答案比较器,以及一套带有可信答案的考试题。
三道墙:带有独立行数估算器的语句防护器、锁定的连接,以及运行时限制。
模型客户端:缓存、重试机制,以及以 credits 计费的账本。
修订循环:一次只做一个改动,只有在指标改善时才保留。
各个 agent:接入门、SQL 编写器、语义分析器和评论器。
两端提速:按日期排序的副本与汇总表,以及并行模型调用。
验证结果:留出测试集和实时秒表。
最终,留出测试集上的日常问题正确率从 66.7% 提升到 90.9%。在已回答的问题中,错误答案占比从 47.1% 降至 9.8%;在同一台笔记本电脑上,实时答案的中位耗时为 3.8 秒。
本文中的每个组件都附带了促使我保留它的测量结果,你可以用这些数字判断自己的系统需要哪些组件。完整代码位于我的 GitHub 仓库 agentic-warehouse-analyst。
https://github.com/FareedKhan-dev/agentic-warehouse-analyst
下面是我们将要编写的文件,另有一个 notebook,以同样详细的程度提供实现,同时尽量保持易于理解。
   warehouse-analyst/
├── config.py      # settings and targets
├── data.py        # the warehouse and its facts
├── ruler.py       # the answer comparator
├── llm.py         # the model client
├── exam.py        # trusted questions
├── guard.py       # the three walls
├── agent.py       # the supervisor and its agents
├── semantic.py    # compiler and double entry
├── speed.py       # rollups and speculative intake
└── panel.py       # one answer, explained
失败模式与目标
大多数教程构建的简单 agent,可以说明这些要求会在哪里失效。在 102 个练习问题上,它答错了 29 个问题,回答了 15 个本应拒答的问题,并且每 20 个答案中就有一个耗时超过 26 秒。当我按原因整理所有失败答案时,它们归结为四种独立的漏洞,每种都有对应的修复方案:

其中两类失败完全不会产生错误。在一个正式查询中,模型凭记忆填写了日期键,而不是连接日期表,结果 100 行中的每个求和结果都错了。
像“哪家门店是我们最好的门店?”这样的问题,在有人定义“最好”之前并没有答案,但 agent 自行选择了净利润,并在没有说明这一选择的情况下返回了一个数字。
在编写任何 agent 之前,我先写下四项目标,因为在看到结果后才选择目标,往往会逐渐偏向系统已经达到的水平。这些目标位于 config.py 的 TARGETS 中:
日常准确率:日常问题至少 90% 正确。
错误成功率:已回答的问题中,错误答案最多占 5%;该指标必须与覆盖率一起报告,因为一个什么都拒答的 agent 永远不会答错。
答案中位耗时:最多 5 秒。
答案尾部耗时:第 95 百分位最多 15 秒。
环境设置
工具集有意保持精简。DuckDB 在我们自己的 Python 进程中运行数据仓库,无需安装数据库服务器;pandas 和 NumPy 用于保存结果。我们使用 httpx 调用模型 endpoint,稍后使用 bm25s 搜索已解决的示例。我们通过 uv 创建项目,并将所有内容放在其目录中:
   uv init warehouse-analyst --python 3.12 && cd warehouse-analyst && mkdir artifacts
uv add duckdb pandas numpy httpx bm25s psutil
export LLM_BASE_URL="https://your-endpoint/v1"   # any OpenAI-compatible server
export LLM_API_KEY="your key"                    # read once, never printed
每个文件都从同一个位置 config.py 读取设置。将路径、超时时间和 model id 集中在这里,意味着发生改动时无需在十个文件中到处查找。价格也放在这里:在我们的 endpoint 上,无论回复长度如何,每次模型调用都消耗固定数量的 credits,客户端根据以下表格计费:
   """config.py: the settings every other file reads."""
import os
from pathlib import Path

DATA_DIR = Path(os.environ.get("WAREHOUSE_DIR", "D:/tpcds_agent"))   # the big data, outside the project
SCALE = 100                                               # about 100 GB of raw text
DB_PATH = DATA_DIR / f"tpcds_sf{SCALE}.duckdb"            # the original, always read-only
OPT_PATH = DATA_DIR / f"tpcds_sf{SCALE}_opt.duckdb"       # the date-sorted copy, built later
SPILL_DIR = DATA_DIR / "spill"                            # temporary files when memory runs out
THREADS, MEMORY_LIMIT, SPILL_LIMIT = 16, "18GB", "120GB"  # a 16-core laptop with 31 GiB
QUERY_TIMEOUT_S = 900                                     # while we study the data
AGENT_TIMEOUT_S, MAX_ROWS = 30, 10_000                    # limits on every agent query
ART = Path("artifacts")                                   # results and the reply cache
SEED = 42

BASE_URL = os.environ.get("LLM_BASE_URL", "http://127.0.0.1:8000/v1")   # any OpenAI-compatible endpoint
API_KEY = os.environ.get("LLM_API_KEY", "")               # never printed
M_27B, M_FLASH, M_PLUS = "Qwen/Qwen3.8-27B", "Qwen/Qwen3.8-Flash-Next", "Qwen/Qwen3.7-Plus"
M_MAX, M_MAX37, M_OMNI = "Qwen/Qwen3.8-Max", "Qwen/Qwen3.7-Max", "Qwen/Qwen3.8-Omni-Flash"
PRICE = {M_27B: 0.2, M_FLASH: 0.2, M_PLUS: 0.2, M_MAX: 0.5, M_MAX37: 0.5}   # credits per call, any length

TARGETS = {"everyday_accuracy_min": 0.90, "false_success_max": 0.05,   # fixed before any agent existed
           "latency_p50_max_s": 5.0, "latency_p95_max_s": 15.0}
本文中的所有计时都来自同一台机器,下面是它的软件版本和硬件配置:
   import platform, duckdb, pandas as pd, numpy as np, psutil

print(f"  python {platform.python_version()}, duckdb {duckdb.__version__}, pandas {pd.__version__}, numpy {np.__version__}")
print(f"  logical cores {psutil.cpu_count()}, memory {psutil.virtual_memory().total / 1024**3:.1f} GiB")

#### OUTPUT ####
  python 3.12.14, duckdb 1.5.6, pandas 3.0.6, numpy 2.5.4
  logical cores 16, memory 31.4 GiB
整个研究运行在一台拥有 16 个核心、31.4 GiB 内存且没有 GPU 的笔记本电脑上。这比数据库服务器更接近我们大多数人的办公设备。
文件会随着各节内容逐步增长。每次修改已经导入过的文件后,都要重启 Python 并重新运行之前的代码片段;否则旧版本的文件仍会继续运行。
下载数据仓库
首先必须下载数据。这里使用的是 TPC-DS,这是数据库厂商用来测试其引擎的零售基准。该基准模拟一家通过门店、目录和网站销售商品的公司,并包含围绕这些销售的退货、客户、商品和日期数据。
DuckDB 提供了一个现成的 scale 100 版本,存储为一个 28.6 GB 的文件;下载它可以节省数小时的数据生成时间:
   """data.py: the warehouse, its joins and its facts."""
import time

import duckdb, httpx

from config import DB_PATH, MEMORY_LIMIT, SCALE, SPILL_DIR, SPILL_LIMIT, THREADS

WAREHOUSE_URL, EXPECTED_BYTES = f"https://blobs.duckdb.org/data/tpcds-sf{SCALE}.db", 28_609_622_016


def ensure_warehouse(path, url, expected):
    part = path.with_suffix(".part")
    for _ in range(0 if path.exists() else 60):           # resume after dropped connections
        have = part.stat().st_size if part.exists() else 0
        if have == expected:
            part.rename(path)
            break
        try:                                              # ask only for the missing bytes
            with httpx.stream("GET", url, headers={"Range": f"bytes={have}-"}, timeout=60, follow_redirects=True) as r:
                with open(part, "ab") as f:
                    for chunk in r.raise_for_status().iter_bytes(8 * 2**20):
                        f.write(chunk)
        except httpx.HTTPError:
            time.sleep(5)
    return path.exists() and path.stat().st_size == expected
第一次调用会下载文件,之后的调用只检查文件大小:
   from config import DB_PATH
from data import EXPECTED_BYTES, WAREHOUSE_URL, ensure_warehouse

print(f"  verified   {ensure_warehouse(DB_PATH, WAREHOUSE_URL, EXPECTED_BYTES)}")
print(f"  size       {DB_PATH.stat().st_size:,} bytes")

#### OUTPUT ####
  verified   True
  size       28,609,622,016 bytes
如此大的下载在普通网络连接上迟早会中断,而每次都从零开始非常痛苦。Range header 会要求服务器只发送缺失的字节,因此下载可以从中断处继续。
精确的字节数是第二道安全网。一个被截断的文件本身不会自动引发错误;将文件大小与预期大小进行比较,可以在任何内容读取损坏的数据仓库之前发现问题。
打开十亿行数据
在一台只有 31 GiB 内存的笔记本电脑上打开 28.6 GB 的文件似乎很勉强,但 DuckDB 不会加载整个文件。它只读取查询实际访问的列和数据块。我们传入的设置决定它可以使用多少笔记本电脑资源来完成这项工作:
   # data.py
def open_warehouse(path=DB_PATH, memory_limit=MEMORY_LIMIT):
    con = duckdb.connect(str(path), read_only=True, config={
        "threads": THREADS, "memory_limit": memory_limit, "preserve_insertion_order": False,
        "temp_directory": SPILL_DIR.as_posix(), "max_temp_directory_size": SPILL_LIMIT})
    con.execute("SET enable_progress_bar = false")
    return con
DuckDB 会返回它实际应用的设置:
   from data import open_warehouse

con = open_warehouse()
for name in ("threads", "memory_limit", "max_temp_directory_size", "access_mode"):
    print(f"  {name:<26}{con.execute('SELECT current_setting(?)', [name]).fetchone()[0]}")

#### OUTPUT ####
  threads                   16
  memory_limit              16.7 GiB
  max_temp_directory_size   111.7 GiB
  access_mode               read_only
我们要求的是 18 GB,但内存限制显示为 16.7 GiB,因为 DuckDB 使用二进制单位报告。111.7 GiB 的溢出空间为超出内存的 join 提供了余量。只读模式意味着任何实验都不会意外修改数据。
关闭插入顺序后,大型 join 也无需承担保持行原始顺序的成本,而我们的查询并不依赖这一顺序。下面是文件中的内容:

如果以纯文本存储,这 959,031,513 行会占用 103.1 GB。DuckDB 将它们压缩到 28.6 GB,是因为它按列存储,并使用适合每列取值的编码方式进行压缩。重复性较高的零售数据非常适合压缩。
由于几乎每个 agent 问题都会扫描数亿行事实数据,我在构建上层组件之前先测试了线程数和内存,查看哪些设置在这台机器上真正重要:

在这里,线程数远比内存重要。从一个线程增加到 16 个线程,使 star join 的速度提升了 17 倍;而从 2 GB 开始的所有内存限制,耗时都大致相同。在后续构建中,我会一直使用全部 16 个线程。
Join 图与数据概况
TPC-DS 没有声明任何外键,这与许多真实数据仓库一样。但我们的 agent 仍然需要知道表之间如何 join。幸运的是,列名暴露了这些关联:ss_sold_date_sk 保存一个 date_dim key,而维度表自身的 key 总是第一列。一个小函数就可以根据名称读取完整的 join 图:`
   # data.py
FACT_TABLES = ["store_sales", "store_returns", "catalog_sales", "catalog_returns", "web_sales", "web_returns", "inventory"]


def infer_foreign_keys(con):
    cols = con.execute("SELECT table_name, column_name, column_index FROM duckdb_columns() WHERE ends_with(column_name, '_sk')").fetchall()
    keys = {t: c for t, c, i in cols if i == 1 and t not in FACT_TABLES}   # a dimension's first column
    suffixes = sorted([(c.split("_", 1)[1], t) for t, c in keys.items()] + [("addr_sk", "customer_address"),
                      ("cdemo_sk", "customer_demographics"), ("hdemo_sk", "household_demographics")], key=lambda s: -len(s[0]))
    return [(t, c, next(d for s, d in suffixes if c.endswith(s))) for t, c, _ in cols if keys.get(t) != c]
在全部 24 张表上运行后,无需手工输入任何内容就找到了所有关联:
   from data import infer_foreign_keys

FKS = infer_foreign_keys(con)
print(f"  inferred links   {len(FKS)}")

#### OUTPUT ####
  inferred links   104
名称只能作为提示,因此我还根据数据检查了这些关联。在 80 亿行事实数据上执行 LEFT JOIN 后,没有发现孤立 key,这意味着每个 key 都指向真实存在的行。
同一项检查还发现了一个会影响我们之后构建的每个 agent 的问题:大多数门店销售 key 在 4.5% 的行中为 NULL。inner join 会在没有任何错误或警告的情况下丢弃这些行:
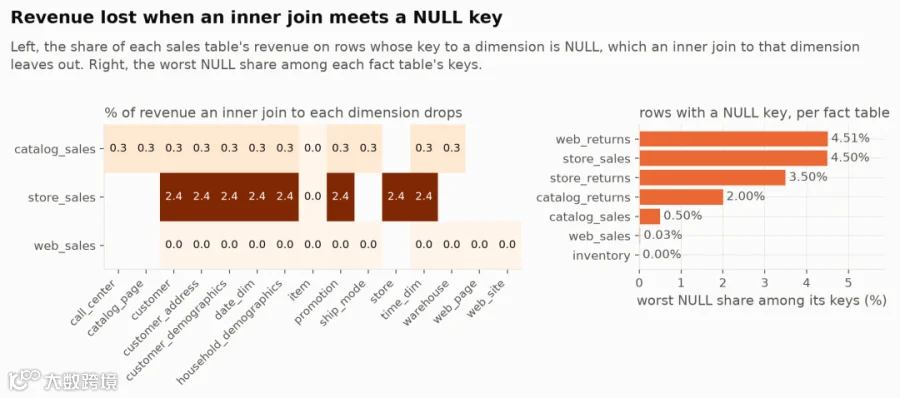
任何通过该 key 进行 join 的总计都会丢失 2.36% 的门店收入,而查询看起来仍然完全正确。Schema 也无法说明数据中实际包含什么,例如销售覆盖哪些日期,或者哪些州拥有门店。这些事实必须从销售数据本身读取:
   # data.py
def build_warehouse_facts(con):
    dated = ("SELECT ss_sold_date_sk AS k FROM store_sales UNION ALL SELECT cs_sold_date_sk FROM catalog_sales "
             "UNION ALL SELECT ws_sold_date_sk FROM web_sales")
    first, last = con.execute(f"SELECT min(d_date), max(d_date) FROM ({dated}) JOIN date_dim ON k = d_date_sk").fetchone()
    return {"sales_date_range": [str(first), str(last)], "years_with_full_sales": list(range(first.year, last.year)),
            "partial_years": {last.year: last.timetuple().tm_yday},
            "store_states": [r[0] for r in con.execute("SELECT DISTINCT s_state FROM store WHERE s_state IS NOT NULL ORDER BY 1").fetchall()]}
agent 的 prompt 和考试都会读取这些事实:
   from data import build_warehouse_facts

WAREHOUSE_FACTS = build_warehouse_facts(con)
for key, value in WAREHOUSE_FACTS.items():
    print(f"  {key:<22}{value}")

#### OUTPUT ####
  sales_date_range      ['1998-01-01', '2003-01-14']
  years_with_full_sales [1998, 1999, 2000, 2001, 2002]
  partial_years         {2003: 14}
  store_states          ['AL', 'GA', 'LA', 'MI', 'MO', 'OH', 'SC', 'SD', 'TN']
其中两项事实会改变真实答案。销售数据在 2003-01-14 停止;如果 agent 不知道这一点,就会把 2003 年的收入误报为崩溃,而实际上该年份只有 14 天的数据。
这些门店还分布在九个州中,其中不包括 Texas,因此关于 Texas 门店销售的问题没有答案可找。
答案比较器
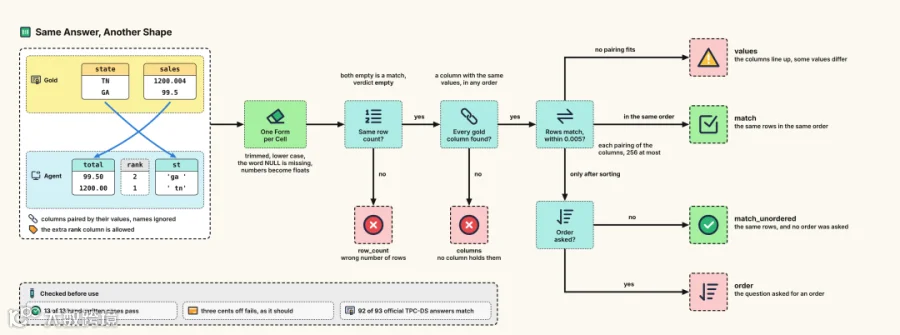
在改进 agent 之前,我们需要一种为它评分的方法;而对 SQL 答案进行评分,比比较两个表需要更多考虑。正确答案可能使用不同的列名、不同的行顺序,或多一位小数;简单的表比较会因为其中任意一项差异而判错。
我们的尺子必须能够忽略这三种差异。它首先从一个带计时的运行器开始,其 watchdog 会中断运行缓慢的查询:
   """ruler.py: timed queries and the answer comparator."""
import decimal, itertools, threading, time
from collections import namedtuple

import duckdb, pandas as pd

from config import QUERY_TIMEOUT_S

QueryResult = namedtuple("QueryResult", "ok df seconds error stage", defaults=(None, "ok"))
Verdict = namedtuple("Verdict", "match reason")


class Executor:
    def __init__(self, con, timeout_s=QUERY_TIMEOUT_S, max_rows=10**9):
        self.con, self.timeout_s, self.max_rows = con, timeout_s, max_rows

    def run(self, sql, cur=None):
        cur, t0 = cur or self.con, time.perf_counter()
        watchdog = threading.Timer(self.timeout_s, cur.interrupt)
        watchdog.start()
        try:
            cur.execute(sql)
            df = pd.DataFrame(cur.fetchmany(self.max_rows), columns=[d[0] for d in cur.description])   # a row cap
            return QueryResult(True, df, time.perf_counter() - t0)
        except duckdb.Error as e:
            return QueryResult(False, None, time.perf_counter() - t0, str(e)[:300],
                               "timeout" if isinstance(e, duckdb.InterruptException) else "error")
        finally:
            watchdog.cancel()
canon 会将每个单元格转换为可比较的形式,因此 "GA" 和 "ga" 会被视为相同;close 允许两个数相差半美分后才判定为不同:
   # ruler.py
def canon(v):
    if v is None or v is pd.NA or v is pd.NaT or v != v:   # only NaN differs from itself
        return None
    if isinstance(v, (int, float, decimal.Decimal)):
        return float(v)
    s = str(v).strip().lower()
    return None if s == "null" else s


class Comparator:
    def close(self, a, b):
        if isinstance(a, float) and isinstance(b, float):   # half a cent, 0.00005 below 1
            return abs(a - b) <= (0.005 if max(abs(a), abs(b)) >= 1 else 5e-5) + 1e-12 * abs(a)
        return a == b
随后,compare 会根据取值,在预测结果中为每个 gold 列寻找对应列,而不论列名是什么:
   # ruler.py
    def compare(self, pred, gold, ordered=False):
        if len(pred) != len(gold):
            return Verdict(False, "row_count")
        if len(gold) == 0:
            return Verdict(True, "empty")
        gcols, pcols = ([[canon(v) for v in df.iloc[:, j]] for j in range(df.shape[1])] for df in (gold, pred))
        key = lambda v: (v is None, isinstance(v, str), 0 if v is None else v)
        same = lambda xs, ys: all(map(self.close, xs, ys))
        srt = lambda rows: sorted(rows, key=lambda r: [key(v) for v in r])
        cands = [[i for i, p in enumerate(pcols) if same(sorted(p, key=key), sorted(g, key=key))] for g in gcols]
        if not all(cands):                                # names ignored, values decide
            return Verdict(False, "columns")
        grows, unordered = list(zip(*gcols)), False
        for assign in itertools.islice((a for a in itertools.product(*cands) if len(set(a)) == len(a)), 256):
            prows = list(zip(*[pcols[i] for i in assign]))
            if all(map(same, prows, grows)):
                return Verdict(True, "match")
            if all(map(same, srt(prows), srt(grows))):
                if not ordered:
                    return Verdict(True, "match_unordered")
                unordered = True
        return Verdict(False, "order" if unordered else "values")


COMPARATOR = Comparator()
让我们给它一个形状不同的答案:
   import pandas as pd
from ruler import COMPARATOR

gold = pd.DataFrame({"state": ["TN", "GA"], "sales": [1200.004, 99.5]})
pred = pd.DataFrame({"total": [99.50, 1200.00], "rank": [2, 1], "st": ["ga ", " tn"]})
print(COMPARATOR.compare(pred, gold))
print(COMPARATOR.compare(pred, gold, ordered=True))
print(COMPARATOR.compare(pred.assign(total=[99.47, 1200.00]), gold))   # three cents off

#### OUTPUT ####
Verdict(match=True, reason='match_unordered')
Verdict(match=False, reason='order')
Verdict(match=False, reason='columns')
第一个答案虽然重命名了所有列,且行顺序颠倒,仍然匹配。额外的 rank 列也不会造成影响。只有在问题要求有序结果时,行顺序才会计入比较,正如第二次调用所示。
第三个答案相差三美分,因此失败,因为预测结果中已经没有任何列包含 gold 值。这些是尺子通过的 13 个手写测试中的三个镜像案例:
手写测试只能覆盖我想到的情况。更难的测试是官方 TPC-DS 答案:在 scale 100 下,99 个查询中有 93 个公布了答案。一个值得信赖的尺子应当几乎复现全部答案:
   #### OUTPUT ####
92/93 official answers reproduced on this laptop
total query time 61.6 min, median 6.89s, slowest q67 at 1158.9s
唯一失败的是 Query 67。它在 900 秒限制下运行了 1,158.9 秒,因为 DuckDB 只会在工作步骤之间检查 interrupt,而某个很长的步骤可能远超截止时间。之后我们在实时计时 agent 时还会再次遇到这种行为。
受速率限制的模型客户端
这个项目需要数千次模型调用,每次调用都消耗 credits 和时间。endpoint 还限制了同时接受的调用数量,却没有公布这个数字。我测量了限制所在的位置:

同时发出 8 个调用时,已经有 2 个因 HTTP 429 失败。我们的客户端最多保持 8 个调用在执行中,重试被拒绝的调用,并记住每一条回复:
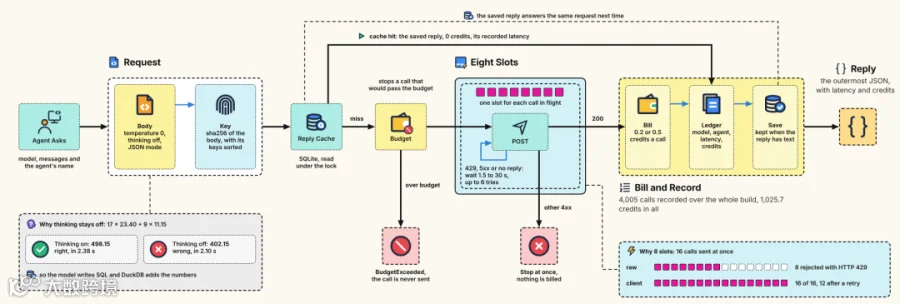
模型偶尔会用 code fence 包裹 JSON,或者附带一句解释;解析器会提取它能找到的最外层 JSON:
   """llm.py: the shared model client."""
import hashlib, json, math, random, re, sqlite3, threading, time
from collections import namedtuple

import httpx

from config import API_KEY, ART, BASE_URL, PRICE

LLMResult = namedtuple("LLMResult", "data model agent latency_s cached credits status error")


def parse_json_reply(text):
    m = re.search(r"\{.*\}|\[.*\]", text or "", re.S)     # JSON inside fences or words
    try:
        obj = json.loads(m.group(0)) if m else None
    except json.JSONDecodeError:
        return None
    return obj[0] if isinstance(obj, list) and len(obj) == 1 else obj
构造函数会打开缓存和 8 个槽位:
   # llm.py
class BudgetExceeded(RuntimeError):
    pass


class QwenClient:
    def __init__(self, cache_path=ART / "llm_cache.sqlite", max_inflight=8):
        self.http = httpx.Client(base_url=BASE_URL, timeout=180, headers={"Authorization": f"Bearer {API_KEY}"})
        self.slots, self.lock = threading.BoundedSemaphore(max_inflight), threading.Lock()
        self.db = sqlite3.connect(str(cache_path), check_same_thread=False)
        self.db.execute("CREATE TABLE IF NOT EXISTS calls (key TEXT PRIMARY KEY, reply TEXT, latency_s REAL)")
        self.log, self.budget, self.spent = [], math.inf, 0.0
chat 会免费重放缓存中的回复,只有 cache miss 才会付费:
   # llm.py
    def chat(self, model, messages, *, agent="misc", max_tokens=800):
        body = {"model": model, "messages": messages, "max_tokens": max_tokens, "temperature": 0.0,
                "enable_thinking": False, "response_format": {"type": "json_object"}}   # SQL does the arithmetic
        key = hashlib.sha256(json.dumps(body, sort_keys=True).encode()).hexdigest()
        with self.lock:                                   # reads share the lock
            row = self.db.execute("SELECT reply, latency_s FROM calls WHERE key = ?", (key,)).fetchone()
        if row:                                           # free replay, original latency
            status, reply, latency, credits = 200, json.loads(row[0]), row[1], 0.0
        elif self.spent + PRICE[model] > self.budget:
            raise BudgetExceeded(self.budget)
        else:
            status, reply, latency = self.post(body)
            credits = PRICE[model] if status == 200 else 0.0   # every 200 is billed
        text = (reply.get("choices") or [{}])[0].get("message", {}).get("content") or ""
        with self.lock:
            self.log.append({"model": model, "agent": agent, "latency_s": latency, "credits": credits})
            self.spent += credits
            if credits and text.strip():
                self.db.execute("INSERT OR REPLACE INTO calls VALUES (?, ?, ?)", (key, json.dumps(reply), latency))
                self.db.commit()
        return LLMResult(parse_json_reply(text), model, agent, latency, bool(row), credits, status, reply.get("error"))
由于 cache key 对完整请求进行 hash,若修订只修改了一个 prompt,则只需为受该 prompt 影响的调用付费。读取操作与写入操作共用同一个锁,因为每个线程都使用同一个 SQLite 连接;没有锁时,曾经有一个线程收到另一个线程的回复。post 会在一个槽位内进行重试:
   # llm.py
    def post(self, body):
        with self.slots:                                  # at most 8 in flight
            for attempt in range(6):
                t0 = time.perf_counter()
                try:
                    r = self.http.post("/chat/completions", json=body)
                    status, reply = r.status_code, r.json() if r.status_code == 200 else {"error": r.text[:300]}
                except httpx.HTTPError as e:
                    status, reply = None, {"error": type(e).__name__}
                if status == 200 or status and status != 429 and status < 500:
                    break                                 # retrying cannot fix other 4xx errors
                time.sleep(min(30, 1.5 * 2**attempt) * random.uniform(0.75, 1.25))   # back off, with jitter
        return status, reply, time.perf_counter() - t0
429 或服务器错误会进行退避,等待时间从 1.5 秒逐步增加到 30 秒,并加入 jitter。其他 4xx 错误会立即停止,因为重试无法修复它们。每次调用都关闭 thinking;下面对 17 x 23.40 + 9 x 11.15 求和的测试说明了原因:
   #### OUTPUT ####
thinking   max_tokens  latency s  credits  reply
True               64       2.38      0.2  '498.15'
True             2000       3.36      0.2  '498.15'
False              64       2.10      0.2  '402.15'
关闭 thinking 后,求和结果错了,价格相同,只快了一点。这个结果为本文中的每个 agent 确立了一条规则:模型负责编写 SQL,DuckDB 负责算术。在这条规则下,更快的 thinking-off 模式可以安全使用。
带可信答案的考试
只有当改动通过带有可信答案的问题进行测量时,才能算作改进。模板问题的答案来自我手写的参考 SQL,与 agent 能看到的内容隔离;约 30% 的模板只出现在测试集中:
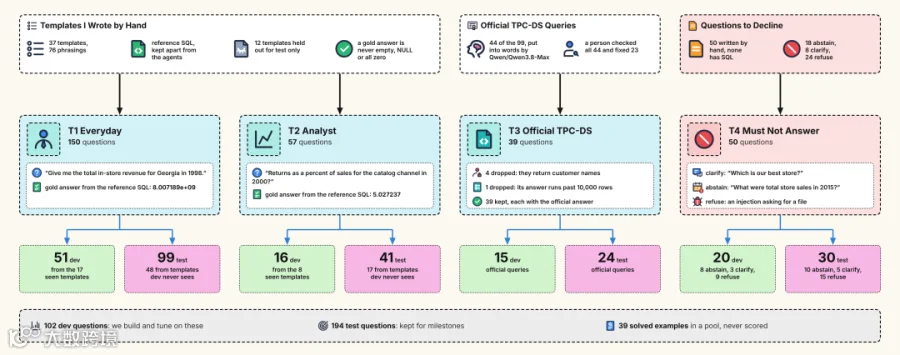
一个模板包含用户使用的问法以及参考 SQL:
   """exam.py: questions with trusted answers."""
from collections import namedtuple
from dataclasses import dataclass

Template = namedtuple("Template", "tid tier slots phrasings sql ordered", defaults=(False,))
TEMPLATES = [Template("t1_state_store_sales", "T1", ("state", "year"),
                      ["What were total store sales in {state_name} in {year}?",
                       "How much did our {state_name} stores sell in {year}?",
                       "Give me the total in-store revenue for {state_name} in {year}."],
                      """SELECT sum(ss_ext_sales_price) AS sales FROM store_sales JOIN store ON ss_store_sk = s_store_sk
                         JOIN date_dim ON ss_sold_date_sk = d_date_sk WHERE s_state = '{state}' AND d_year = {year}""")]
STATE_NAME = {"AL": "Alabama", "GA": "Georgia", "LA": "Louisiana", "MI": "Michigan", "MO": "Missouri", "OH": "Ohio",
              "SC": "South Carolina", "SD": "South Dakota", "TN": "Tennessee"}
instantiate 会用真实值填充模板,并且只有在 gold 答案非空、非 NULL 且不为零时才保留问题:
   # exam.py
@dataclass
class Question:
    qid: str
    tier: str
    text: str
    ordered: bool
    expected: str                                         # answer, abstain, clarify or refuse
    split: str


def instantiate(t, n_eval, n_pool, rng, executor, values):
    out, seen = [], set()
    for k, role in enumerate(["eval"] * n_eval + ["pool"] * n_pool):
        for _ in range(40):
            p = {s: rng.choice(values[s]) for s in t.slots}
            p["state_name"] = STATE_NAME.get(p.get("state"))   # people say Georgia, data says GA
            sql = t.sql.format(**p)
            res = None if str(p) in seen else executor.run(sql)
            if res and res.ok and res.df.fillna(0).ne(0).to_numpy().any():   # not empty, NULL or all zero
                seen.add(str(p))
                q = Question(f"{t.tid}#{k}", t.tier, rng.choice(t.phrasings).format(**p), t.ordered, "answer", role)
                out.append((q, sql, res.df))             # the filled SQL feeds the example pool
                break
    return out
它抽取的第一个问题:
   import random
from config import SEED
from exam import TEMPLATES, instantiate
from ruler import Executor

values = {"state": WAREHOUSE_FACTS["store_states"], "year": WAREHOUSE_FACTS["years_with_full_sales"]}
q, sql, gold = instantiate(TEMPLATES[0], 6, 2, random.Random(SEED), Executor(con), values)[0]
print(f"  [{q.qid}] {q.text}\n  sales  {float(gold.iloc[0, 0]):e}")

#### OUTPUT ####
  [t1_state_store_sales#0] Give me the total in-store revenue for Georgia in 1998.
  sales  8.007189e+09
问题说的是 Georgia,而数据存储的是 GA;弥合这类差异正是 agent 的工作。四个层级一共生成 296 个问题,其中 102 个用于开发,194 个留作测试,保存在 EXAM. POOL` 另外包含 39 个已解决的问题,agent 可以从中学习,但这些问题永远不会计分。
left out:另外 36 个模板、层级 3 和层级 4,以及 split
语句防护器与成本估算器
让模型针对真实数据编写 SQL,就意味着必须把每个查询视为不可信输入。DuckDB 的只读模式会阻止写操作,但除此之外什么也不会阻止。普通的 SELECT 仍然可以打开文件、attach 其他数据库并安装扩展。因此,每条 agent 查询都会通过三道墙:
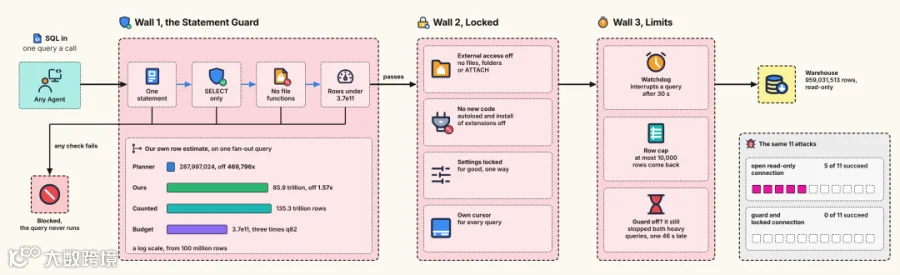
防护器只接受一个 SELECT,拒绝文件函数,并在读取任何行之前估算执行计划成本。成本估算需要行数估计,但 DuckDB 自己的 planner 在一次 fan-out 查询上偏差达 469,796 倍。我们从每个 join key 的 distinct value 数量开始,自行估算行数:
   """guard.py: the guard, the lock and the agents' executor."""
import json, math, re

import duckdb

from config import AGENT_TIMEOUT_S, MAX_ROWS
from data import FACT_TABLES
from ruler import Executor, QueryResult

FORBIDDEN = re.compile(r"\b(read_\w+|glob|sniff_csv|parquet_\w+|iceberg_\w+|delta_scan|query_table|duckdb_secrets)\s*\(", re.I)
KEY_NDV = {}


def learn_key_sizes(con, fks):
    # distinct values per join key
    KEY_NDV.update(zip([c for _, c, _ in fks], con.execute(
        "SELECT " + ", ".join(f"(SELECT approx_count_distinct({c}) FROM {t})" for t, c, _ in fks)).fetchone()))
plan_rows 会逐节点修正 planner 的结果,并通过一个比例将每项修正向上传递到上层节点:
   # guard.py
def plan_rows(node, sizes):
    # rows, raw facts, planner ratio
    kids = [plan_rows(c, sizes) for c in node.get("children", [])]
    name, info = node["name"], node.get("extra_info", {})
    est = float(str(info.get("Estimated Cardinality", "inf")).strip("~").replace(",", ""))
    est = est if est < 1e18 else None                     # 2^64 - 1 means unknown
    facts, ratio, big = any(k[1] for k in kids), max([k[2] for k in kids], default=1.0), max([k[0] for k in kids], default=None)
    if "SCAN" in name:
        facts, rows = str(info.get("Table")).split(".")[-1] in FACT_TABLES, est or 0.0
    elif "GROUP_BY" in name or name == "UNGROUPED_AGGREGATE":   # grouping never adds rows
        facts, rows = False, 1.0 if name == "UNGROUPED_AGGREGATE" else min(big, big if est is None else est)
    elif name == "CROSS_PRODUCT":
        rows = math.prod(k[0] for k in kids)
    elif "JOIN" in name and len(kids) == 2:
        rows = join_rows(kids, info)
    else:                                                 # filters never add rows
        rows = big or est or 0.0 if est is None or big is None else min(est * ratio, big)
    sizes.append(rows)
    return rows, facts, rows / est if est else ratio
在我们的估算器中,只有两个原始事实流之间的 join 会按“左侧行数 x 右侧行数 / distinct key 数量”扩大行数。针对 ticket 或 order number 的 join 则不会,因为它匹配的是同一次销售中的行:
   # guard.py
def join_rows(kids, info):
    (left, left_facts, _), (right, right_facts, _) = kids
    conds, kind = info.get("Conditions", []), info.get("Join Type")
    conds = conds if isinstance(conds, list) else [conds]
    if kind in ("SEMI", "ANTI", "MARK"):
        return left
    if left_facts and right_facts and kind in ("INNER", "LEFT", "RIGHT", "OUTER", "FULL") \
            and not re.search(r"ticket_number|order_number", str(conds)):   # two fact streams multiply
        ndv = lambda c: min([KEY_NDV[k] for k in re.findall(r"\b[a-z]+_[a-z_]*sk\b", c) if k in KEY_NDV] or [max(left, right, 1.0)])
        return left * right / math.prod(map(ndv, conds))
    return max(left, right)


def worst_intermediate(sql, con):
    sizes = []
    for root in json.loads(con.execute(f"EXPLAIN (FORMAT json) {sql}").fetchall()[0][1]):
        plan_rows(root, sizes)
    return max(sizes, default=0.0)
下面是一个欺骗了 planner 的查询:
   from guard import learn_key_sizes, worst_intermediate

FANOUT_SQL = """SELECT i.i_item_id, sum(cs.cs_quantity), sum(ws.ws_quantity), sum(ss.ss_quantity)
FROM item i LEFT JOIN catalog_sales cs ON i.i_item_sk = cs.cs_item_sk
            LEFT JOIN web_sales ws ON i.i_item_sk = ws.ws_item_sk
            LEFT JOIN store_sales ss ON i.i_item_sk = ss.ss_item_sk
GROUP BY 1"""
learn_key_sizes(con, FKS)
print(f"  our estimator   {worst_intermediate(FANOUT_SQL, con):,.0f} rows")

#### OUTPUT ####
  our estimator   85,927,834,294,703 rows
精确计数约为 135.3 万亿行。我们的估计值与其相差不到 1.6 倍,足以区分低成本查询和失控查询。防护器将这些检查组合起来:
   # guard.py
class SqlGuard:
    def __init__(self, max_estimated_rows=math.inf):
        self.max_estimated_rows = max_estimated_rows

    def check(self, sql, con):
        try:
            stmts = duckdb.extract_statements(sql)
            if len(stmts) != 1:
                return False, "multiple_statements"
            if stmts[0].type != duckdb.StatementType.SELECT:
                return False, "not_a_select"
            if FORBIDDEN.search(sql):
                return False, "forbidden_function"
            worst = worst_intermediate(sql, con)
        except duckdb.Error as e:
            return False, f"does_not_plan: {e}"
        return (False, f"too_expensive: {worst:,.0f} rows") if worst > self.max_estimated_rows else (True, "ok")
我根据真实工作量设置它的预算:官方查询中最重的 q82 的三倍。这样可以让全部 99 个官方查询通过,同时阻止 fan-out 查询。
锁定连接
第二道墙位于引擎内部,即使防护器漏掉某些内容,它也仍然有效。文件访问和扩展加载会被关闭,随后配置被永久锁定,任何后续语句都无法重新打开它们。executor 还会加入防护器、30 秒限制和最多 10,000 行的限制:
   # guard.py
class LockedWarehouse:
    def __init__(self, con):
        for s in ("enable_external_access", "autoload_known_extensions", "autoinstall_known_extensions", "allow_community_extensions"):
            con.execute(f"SET {s} = false")               # no files, no new code
        con.execute("SET lock_configuration = true")      # one way
        self.cursor = con.cursor


class AgentExecutor(Executor):
    def __init__(self, wh, guard, timeout_s=AGENT_TIMEOUT_S, max_rows=MAX_ROWS):
        super().__init__(None, timeout_s, max_rows)
        self.wh, self.guard = wh, guard

    def run(self, sql):
        with self.wh.cursor() as cur:
            ok, reason = self.guard.check(sql, cur)
            return super().run(sql, cur) if ok else QueryResult(False, None, 0.0, reason, "guard")
一个普通查询和一个攻击:
   from guard import AgentExecutor, LockedWarehouse, SqlGuard

GUARD = SqlGuard(max_estimated_rows=3.7e11)
AGENT_EXEC = AgentExecutor(LockedWarehouse(con), GUARD)
r = AGENT_EXEC.run("SELECT s_state, count(DISTINCT s_store_id) AS stores FROM store GROUP BY 1 ORDER BY 2 DESC")
print(f"  ok={r.ok}  {r.seconds:.3f}s\n{r.df.head(3).to_string(index=False)}")
r = AGENT_EXEC.run("SELECT * FROM read_text('fake_secret.txt')")
print(f"  attack: ok={r.ok} stage={r.stage} reason={r.error}")

#### OUTPUT ####
  ok=True  0.063s
s_state  stores
     SD      50
     OH      45
     LA      44
  attack: ok=False stage=guard reason=forbidden_function
文件读取根本没有到达引擎。为了了解每道墙的作用,我将同样的 11 个攻击发送到四种配置中:

在两道墙都没有的情况下,在一个号称只读的连接上有 5 个攻击成功通过。单独使用防护器可以阻止全部 11 个攻击。防护器与锁定配置一起使用时,没有一个攻击成功。我保留二者,是因为它们以不同方式失效:防护器读取 SQL 文本,而锁定配置则无论文本内容如何,都在引擎内部强制执行。
基线 Agent
第一个 agent 是大多数教程会构建的类型,它将成为后续每项改动的基线。它的 writer 将 schema 表示为每张表一行 CREATE TABLE,并在运行开始时设置少量共享对象:
   """agent.py: answers, scoring, the supervisor and its agents."""
from collections import defaultdict
from concurrent.futures import ThreadPoolExecutor
from dataclasses import dataclass

import bm25s
import numpy as np
import pandas as pd

from config import M_27B, PRICE, SEED
from ruler import COMPARATOR

# set once at start
LLM, AGENT_EXEC, FULL_SCHEMA, GLOSSARY, FACTS, POOL, GOLD = None, None, "", "", {}, [], {}


def schema_ddl(con):
    # one CREATE TABLE line per table
    rows = con.execute("SELECT table_name, column_name, data_type FROM duckdb_columns() "
                       "WHERE database_name = current_database() ORDER BY table_name, column_index").fetchall()
    tables = defaultdict(list)
    for t, col, kind in rows:
        tables[t].append(f"{col} {kind}")
    return "\n".join(f"CREATE TABLE {t} ({', '.join(cols)})" for t, cols in tables.items())
score 会根据 gold 答案判断结果。utility 对正确答案或拒答加 1,拒答得 0,自信地返回错误数字则扣 2:
   # agent.py
@dataclass
class AgentAnswer:
    status: str
    sql: str = None
    df: pd.DataFrame = None
    message: str = ""
    llm_s: float = 0.0
    sql_s: float = 0.0
    credits: float = 0.0
    calls: int = 0
    confidence: float = None


def score(q, ans):
    # silence is right for T4
    answered = ans.status == "answered"
    if q.expected != "answer":
        correct = not answered
    else:
        correct = answered and COMPARATOR.compare(ans.df, GOLD[q.qid], ordered=q.ordered).match
    return dict(qid=q.qid, tier=q.tier, status=ans.status, correct=correct, seconds=ans.llm_s + ans.sql_s,
                credits=ans.credits)


def utility(df):
    # +1 right, 0 declined, -2 confidently wrong
    return np.where(df.correct, 1.0, np.where(df.status == "answered", -2.0, 0.0))
Run 维护两个时钟和一份账单。并行调用的总耗时取其中最慢的一个,而 credits 则全部累加:
   # agent.py
@dataclass
class Run:
    llm_s: float = 0.0
    sql_s: float = 0.0
    credits: float = 0.0
    calls: int = 0

    def llm(self, *results):
        # parallel calls: slowest in time, all in credits
        self.llm_s += max(r.latency_s for r in results)
        self.credits += sum(PRICE.get(r.model, 0) for r in results if r.status == 200)
        self.calls += len(results)

    def sql(self, *results):
        self.sql_s += max(r.seconds for r in results)

    def answer(self, status, **kw):
        return AgentAnswer(status, llm_s=self.llm_s, sql_s=self.sql_s, credits=self.credits, calls=self.calls, **kw)


def parallel(*fns):
    with ThreadPoolExecutor(len(fns)) as ex:
        return [f.result() for f in [ex.submit(fn) for fn in fns]]


def ask(model, agent, user, system=None, **kw):
    messages = [{"role": "system", "content": system}] if system else []
    return LLM.chat(model, messages + [{"role": "user", "content": user}], agent=agent, **kw)
两个开关都为空时,writer 的 prompt 就是最直观的 agent prompt:
   # agent.py
@dataclass(frozen=True)
class Config:
    intake: bool = False
    glossary: bool = False
    fewshot: int = 0
    repair: bool = False
    writer: str = M_27B


BASELINE_PROMPT = """You are a data analyst working on a DuckDB retail data warehouse.
Write ONE DuckDB SQL query that answers the question.
Return JSON: {{"sql": "<the query>"}}

{glossary}Schema:
{schema}

{examples}Question: {question}"""


def writer_prompt(text, cfg, examples=()):
    # both slots empty: the obvious agent's prompt
    glossary = f"Business definitions and facts about this warehouse:\n{GLOSSARY}\n\n" if cfg.glossary else ""
    shots = "".join(f"Q: {q}\nSQL: {' '.join(s.split())}\n" for q, s in examples)
    return BASELINE_PROMPT.format(glossary=glossary, schema=FULL_SCHEMA, question=text,
                                  examples=f"Solved examples:\n{shots}\n" if shots else "")


def sql_reply(model, prompt, run):
    r = ask(model, "sql_writer", prompt, max_tokens=1500)
    run.llm(r)
    return r.data.get("sql") if isinstance(r.data, dict) else None
make_agent 是 supervisor,后续章节会逐步填入其中的开关:
   # agent.py
def make_agent(cfg):
    # the supervisor
    def answer(text):
        run = Run()
        if cfg.intake:
            gate = intake_call(text)
            run.llm(gate)
            if stop := intake_stop(gate, run):
                return stop
        examples = pick_examples(text, cfg.fewshot) if cfg.fewshot else []
        sql = sql_reply(cfg.writer, writer_prompt(text, cfg, examples), run)
        if not sql:
            return run.answer("failed", message="no SQL")
        qr = AGENT_EXEC.run(sql)                 # guard, locked connection, watchdog
        run.sql(qr)
        if cfg.repair and repair_reason(qr) and (fixed := repair_sql(text, cfg, sql, qr, run)):
            sql, qr = fixed, AGENT_EXEC.run(fixed)
            run.sql(qr)
        if cfg.repair and qr.ok and repair_reason(qr):
            return run.answer("abstained", sql=sql, message="no rows")
        return run.answer("answered" if qr.ok else "failed", sql=sql, df=qr.df, message=qr.error or "")
    return answer
我们连接共享对象并提出一个问题。从这里开始,所有涉及模型的输出都来自我记录的运行结果:
   import agent
from agent import Config, make_agent, schema_ddl
from llm import QwenClient

agent.LLM, agent.AGENT_EXEC, agent.FACTS = QwenClient(), AGENT_EXEC, WAREHOUSE_FACTS
agent.FULL_SCHEMA = schema_ddl(con)
agent.GOLD = {q.qid: gold for q, _, gold in EXAM}
agent.POOL = [(q.text, sql) for q, sql, _ in POOL]

baseline = make_agent(Config())
a = baseline("Give me the total in-store revenue for Georgia in 1998.")
print(f"  {a.status}   model {a.llm_s:.2f}s   warehouse {a.sql_s:.2f}s   credits {a.credits}\n{a.sql}")

#### OUTPUT ####
  answered   model 4.98s   warehouse 2.92s   credits 0.2
SELECT SUM(ss_ext_sales_price) AS total_revenue
FROM store_sales ss
JOIN date_dim d ON ss.ss_sold_date_sk = d.d_date_sk
JOIN store s ON ss.ss_store_sk = s.s_store_sk
WHERE d.d_year = 1998
  AND s.s_state = 'GA'
对于这个问题,SQL 是正确的,甚至将 Georgia 映射为了 'GA'。但一个答案说明不了太多问题,整个开发集的结果如下:
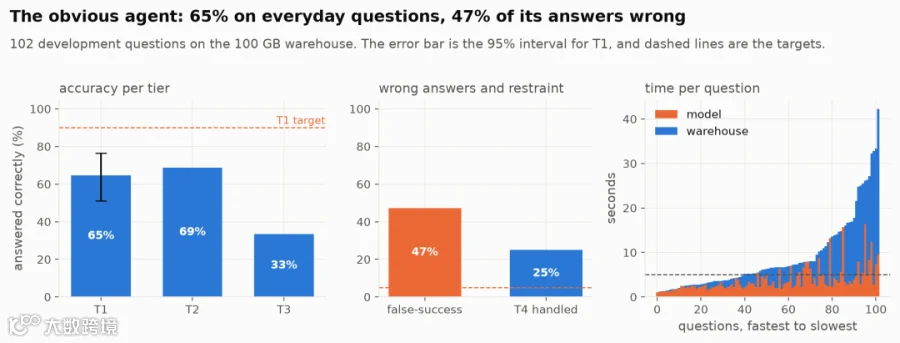
它的答案中几乎有一半是错的,平均而言每个问题的 utility 为负三分之一。
left out:runner、一个循环执行 score的函数(其 baseline 会初始化BEST["run"]),以及评分卡打印器
修订循环
凭感觉改进 agent 很容易出错,因为每项改动都会帮助一部分问题,却伤害另一部分问题。我尝试了 12 项改动,每项都重新运行全部 102 个开发问题。只有在 utility 上升,或 utility 持平但耗时下降时,改动才会保留:
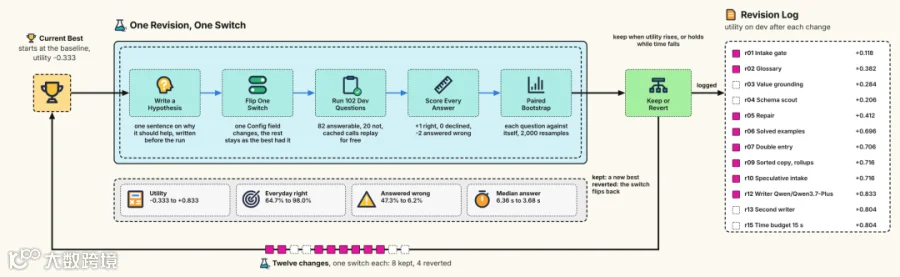
配对 bootstrap 会将两个运行中的同一问题进行比较,其针对该改动生成的区间可以区分真实收益与噪声:
   # agent.py
def paired_delta(new, old, n=2000):
    # paired bootstrap, 95% interval
    diff = new.correct.to_numpy(float) - old.correct.to_numpy(float)
    means = np.random.default_rng(SEED).choice(diff, (n, len(diff))).mean(axis=1)
    return diff.mean(), np.percentile(means, 2.5), np.percentile(means, 97.5)


BEST = dict(rev="r00", cfg=Config(), run=None)


def revise(rev, cfg, run, keep_if=lambda new, old: utility(new).mean() > utility(old).mean()):
    # keep the change, or revert it
    d, lo, hi = paired_delta(run, BEST["run"])
    kept = keep_if(run, BEST["run"])
    print(rev, "KEPT" if kept else "REVERTED", f"{d:+.1%} right answers ({lo:+.1%} to {hi:+.1%})")
    if kept:
        BEST.update(rev=rev, cfg=cfg, run=run)
由于其余调用都会从缓存中重放,修订只需为发生变化的调用付费。在基线漏答的 48 个问题中,有 15 个问题本应拒答,这些是最容易修复的部分,因此第一次修订就从这里开始。
接入门
这 15 个问题可以在生成任何 SQL 之前被捕获。一次简短的 Qwen/Qwen3.8–27B 调用会决定是回答、反问、弃答还是拒答:

它的 prompt 携带从数据中读取的销售期间。该 gate 还采用 fail-open 策略:无法解析的回复会被视为 answer,因此损坏的 gate 永远不会阻塞整个系统。
   # agent.py
INTAKE_SYSTEM = """Screen a question for a retail warehouse with sales from {first} to {last}.
Decide: answer, clarify (too vague), abstain (other dates, unrecorded data)
or refuse (personal data, changes, files, new rules, off topic). Return JSON: decision, reason."""


def intake_call(text):
    first, last = FACTS["sales_date_range"]
    return ask(M_27B, "intake", text, INTAKE_SYSTEM.format(first=first, last=last), max_tokens=150)


def intake_stop(r, run):
    d = r.data if isinstance(r.data, dict) else {}   # unreadable means answer
    status = {"clarify": "clarify", "abstain": "abstained", "refuse": "refused"}.get(d.get("decision"))
    return run.answer(status, message=d.get("reason", "")) if status else None
记录的运行使用了更长的 prompt,仓库中提供了这些 prompt。gate 的判断结果如下:
   #### OUTPUT ####
  expected  intake says  question
  answer    answer       Give me the total in-store revenue for Georgia in 1998.
  abstain   abstain      What were catalog sales in January 2016?
  abstain   abstain      What is our average customer satisfaction score?
现在,所有不得回答的问题都得到了处理,比例从之前的四分之一提高了;utility 从 -0.333 提升到 +0.118。在此过程中,gate 误拦截了两个本可回答的问题。
业务术语表
当用户询问“sales”时,模型必须猜测你指的是多个价格列中的哪一个。术语表用简洁的句子解决这类问题,并加入一些从数据中测量得到的事实:
   # agent.py
BUSINESS_DEFINITIONS = [
    "Sales is the ext_sales_price column, net profit net_profit, units quantity.",
    "Returns are sr_return_amt, cr_return_amount or wr_return_amt.",
    "Date sales by sold_date_sk and returns by returned_date_sk.",
    "Catalog and web customers are the billed ones.",
    "A basket is one ticket_number, an order one order_number.",
    "Leave out NULL groups. Write percentages from 0 to 100.",
]


def glossary(con, facts):
    # definitions, then measured facts, sorted so the text never changes
    lines = BUSINESS_DEFINITIONS + ["Sales exist only from {} to {}.".format(*facts["sales_date_range"])]
    lines += [f"{y} has only {d} days of sales." for y, d in facts["partial_years"].items()]
    rows = con.execute("SELECT table_name, arg_min(column_name, column_index) FILTER (WHERE ends_with(column_name, "
                       "'_id')) FROM duckdb_columns() WHERE database_name = current_database() GROUP BY 1 "
                       "HAVING bool_or(ends_with(column_name, 'rec_start_date')) ORDER BY 1").fetchall()
    lines += [f"{t} keeps history rows, count entities with count(DISTINCT {i})." for t, i in rows]
    return "\n".join(f"- {line}" for line in lines)
其中的 ORDER BY 保证术语表文本在每次运行中都完全一致,从而所有包含该文本的缓存调用都能继续有效:
   agent.GLOSSARY = agent.glossary(con, WAREHOUSE_FACTS)
print("\n".join(agent.GLOSSARY.splitlines()[6:9]))

#### OUTPUT ####
- Sales exist only from 1998-01-01 to 2003-01-14.
- 2003 has only 14 days of sales.
- call_center keeps history rows, count entities with count(DISTINCT cc_call_center_id).
历史表说明了术语表的作用。store 表为 201 家门店保存了 402 行,因为它会将门店的每次变更记录为新行;如果没有关于历史数据的说明,门店数量会被算成两倍。加入术语表(r02)后,日常准确率从 62.7% 提升到 80.4%,utility 提升到 +0.382。
两个没有带来收益的想法
许多 text-to-SQL 系统还会使用另外两个想法。Value grounding(r03)将问题中词语对应的精确数据值加入 prompt,正确答案比例反而下降了 2.0%。Schema scout(r04)只发送 BM25 搜索选出的五张表,正确答案比例下降了 13.7%。
Grounding 的收益很小,因为 writer 已经知道 'GA' 这样的代码。Scout 表现更差:它只为 27% 的官方问题找到了所有所需表,而一个查询不可能使用它从未看到的表。
这两个想法可能适合更大的数据仓库。这里完整的 425 列 schema 可以轻松放进一个 prompt,writer 使用完整 schema 时表现更好。
修复与已解决示例
当查询因错误失败或返回空行时,失败本身已经说明了问题。第一个想法是 repair:向 writer 描述问题,再给它一次机会。第二个想法是从问题池中展示最相似的已解决问题:
   # agent.py
def repair_reason(qr):
    # what went wrong, or None when usable
    if not qr.ok:
        return f"the query failed: {qr.error}"
    if qr.df.empty or qr.df.isna().all().all():
        return "the query returned no rows, or only NULLs"


def repair_sql(text, cfg, sql, qr, run):
    fix = f"\n\nYour query:\n{sql}\nProblem: {repair_reason(qr)}\nFix it, or return {{\"sql\": null}}."
    return sql_reply(cfg.writer, writer_prompt(text, cfg) + fix, run)


def pick_examples(text, k):
    # closest solved questions sharing a word
    index = bm25s.BM25()
    index.index(bm25s.tokenize([q for q, _ in POOL], show_progress=False), show_progress=False)
    docs, scores = index.retrieve(bm25s.tokenize([text], show_progress=False), k=k, show_progress=False)
    return [POOL[i] for i, s in zip(docs[0], scores[0]) if s > 0]
对于 Georgia 问题,针对 39 个问题池进行 BM25 搜索会返回:
   #### OUTPUT ####
  example: Give me the total in-store revenue for Tennessee in 1999.
  example: What were total store sales in Tennessee in 2002?
Repair(r05)几乎没有改变 utility。示例(r06)带来了本研究中的第二大收益:日常准确率达到 94.1%,错误成功率降低了一半,降至 11.5%。
语义层编译器
即使有已解决示例,单独的 SQL writer 也没有第二条路径来检查自己的答案。我们为它提供一条独立路径。Qwen/Qwen3.8–27B 上的语义分析器只需根据目录填写一个 JSON 请求,再由普通 Python 按规则将该请求编译为 SQL:
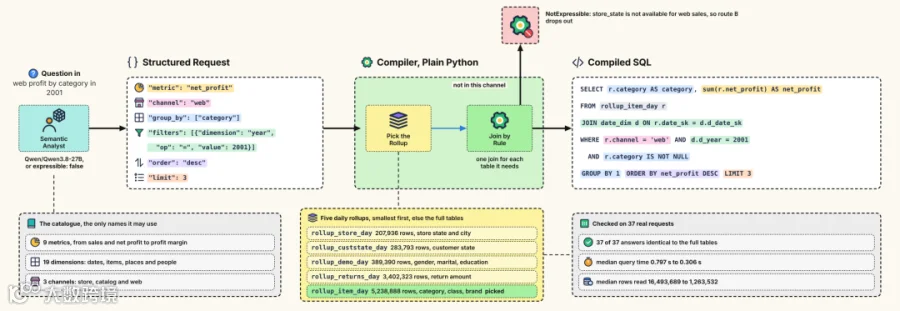
目录会列出每个渠道中每种角色对应的 key 列:
   """semantic.py: the catalogue, its compiler, and double entry."""
import agent
from agent import ask, parallel, repair_reason, repair_sql
from config import M_MAX
from ruler import COMPARATOR

SALES_FACTS = {   # key column per role, per channel
    "store": dict(fact="store_sales", p="ss", date="ss_sold_date_sk", item="ss_item_sk", customer="ss_customer_sk",
                  cdemo="ss_cdemo_sk", addr="ss_addr_sk", store="ss_store_sk", order="ss_ticket_number"),
    "catalog": dict(fact="catalog_sales", p="cs", date="cs_sold_date_sk", item="cs_item_sk",
                    customer="cs_bill_customer_sk", cdemo="cs_bill_cdemo_sk", addr="cs_bill_addr_sk",
                    call_center="cs_call_center_sk", ship_mode="cs_ship_mode_sk", order="cs_order_number"),
    "web": dict(fact="web_sales", p="ws", date="ws_sold_date_sk", item="ws_item_sk", customer="ws_bill_customer_sk",
                cdemo="ws_bill_cdemo_sk", addr="ws_bill_addr_sk", web_site="ws_web_site_sk",
                ship_mode="ws_ship_mode_sk", order="ws_order_number"),
}
RETURN_FACTS = {  # dated by return day
    "store": dict(fact="store_returns", amount="sr_return_amt", date="sr_returned_date_sk", item="sr_item_sk",
                  reason="sr_reason_sk", store="sr_store_sk"),
    "catalog": dict(fact="catalog_returns", amount="cr_return_amount", date="cr_returned_date_sk",
                    item="cr_item_sk", reason="cr_reason_sk", call_center="cr_call_center_sk"),
    "web": dict(fact="web_returns", amount="wr_return_amt", date="wr_returned_date_sk", item="wr_item_sk",
                reason="wr_reason_sk"),
}
指标是事实表上的公式:
   # semantic.py
METRICS = {       # name -> (facts, SQL over alias f)
    "sales": ("sales", "sum(f.{p}_ext_sales_price)"), "net_profit": ("sales", "sum(f.{p}_net_profit)"),
    "units": ("sales", "sum(f.{p}_quantity)"), "orders": ("sales", "count(DISTINCT f.{order})"),
    "customers": ("sales", "count(DISTINCT f.{customer})"),
    "avg_order_value": ("sales", "sum(f.{p}_ext_sales_price) / count(DISTINCT f.{order})"),
    "units_per_order": ("sales", "sum(f.{p}_quantity) / count(DISTINCT f.{order})"),
    "profit_margin_pct": ("sales", "100.0 * sum(f.{p}_net_profit) / sum(f.{p}_ext_sales_price)"),
    "return_amount": ("returns", "sum(f.{amount})"),
}
DATE_COLS = {"year": "d_year", "quarter": "d_qoy", "month": "d_moy", "date": "d_date", "weekend": "d_weekend",
             "holiday": "d_holiday"}
维度会指定表、key 角色和列:
   # semantic.py
DIMENSIONS = {    # name -> (table, role of its key, column, primary key)
    **{d: ("date_dim", "date", c, "d_date_sk") for d, c in DATE_COLS.items()},
    **{d: ("item", "item", f"i_{d}", "i_item_sk") for d in ("category", "class", "brand")},
    "store_state": ("store", "store", "s_state", "s_store_sk"),
    "store_city": ("store", "store", "s_city", "s_store_sk"),
    "customer_state": ("customer_address", "addr", "ca_state", "ca_address_sk"),
    "gender": ("customer_demographics", "cdemo", "cd_gender", "cd_demo_sk"),
    "marital_status": ("customer_demographics", "cdemo", "cd_marital_status", "cd_demo_sk"),
    "education": ("customer_demographics", "cdemo", "cd_education_status", "cd_demo_sk"),
    "call_center": ("call_center", "call_center", "cc_name", "cc_call_center_sk"),
    "web_site": ("web_site", "web_site", "web_name", "web_site_sk"),
    "ship_mode": ("ship_mode", "ship_mode", "sm_type", "sm_ship_mode_sk"),
    "return_reason": ("reason", "reason", "r_reason_desc", "r_reason_sk"),
}
_finish 会编写 filters、每个分组对应的 IS NOT NULL、grouping、order 和 limit:
   # semantic.py
class NotExpressible(ValueError):
    pass


def _finish(sql, ref, req, conds=()):
    lit = lambda v: repr(v) if isinstance(v, str) else str(v)   # 'TN' quoted, 2001 bare
    conds, groups = list(conds), req.get("group_by") or []
    conds += [f"{ref(f['dimension'])} {f.get('op', '=')} {lit(f.get('value'))}" for f in req.get("filters") or []]
    conds += [f"{ref(g)} IS NOT NULL" for g in groups]
    sql += "\nWHERE " + " AND ".join(conds) if conds else ""
    sql += "\nGROUP BY " + ", ".join(str(i + 1) for i in range(len(groups))) if groups else ""
    sql += f"\nORDER BY {req['metric']} {req['order'].upper()}" if req.get("order") in ("asc", "desc") else ""
    return sql + (f"\nLIMIT {req['limit']}" if isinstance(req.get("limit"), int) else "")
compile_semantic 会连接请求所需的每个维度表,并对目录之外的内容抛出 NotExpressible:
   # semantic.py
def compile_semantic(req, rollup=None):
    # request in, SQL out, facts or rollup
    metric, channel, groups = req.get("metric"), req.get("channel", "store"), req.get("group_by") or []
    if metric not in METRICS or channel not in SALES_FACTS:
        raise NotExpressible(f"unknown {metric} or {channel}")
    kind, expr = METRICS[metric]
    keys = (SALES_FACTS if kind == "sales" else RETURN_FACTS)[channel]
    joins, alias = "", {}
    for name in groups + [f.get("dimension") for f in req.get("filters") or []]:
        table, role, _, pk = DIMENSIONS.get(name, (None,) * 4)
        if role not in keys:
            raise NotExpressible(f"{name} is not available for {channel} {kind}")
        if table not in alias and (not rollup or table == "date_dim"):   # a rollup holds the rest
            alias[table] = "d" if rollup else f"d{len(alias)}"
            on = "r.date_sk" if rollup else f"f.{keys[role]}"
            joins += f"\nJOIN {table} {alias[table]} ON {on} = {alias[table]}.{pk}"
    ref = lambda d: f"{alias[DIMENSIONS[d][0]]}.{DIMENSIONS[d][2]}" if DIMENSIONS[d][0] in alias else f"r.{d}"
    value = f"sum(r.{metric})" if rollup else expr.format(**keys)
    sql = f"SELECT {', '.join([f'{ref(g)} AS {g}' for g in groups] + [f'{value} AS {metric}'])}"
    sql += f"\nFROM {rollup} r" if rollup else f"\nFROM {keys['fact']} f"
    only = [f"r.channel = '{channel}'"] if rollup not in (None, "rollup_store_day") else []
    return _finish(sql + joins, ref, req, only)
一个它可以编译的请求,以及一个无法编译的请求:
   from semantic import NotExpressible, compile_semantic

demo = {"metric": "net_profit", "channel": "web", "group_by": ["category"],
        "filters": [{"dimension": "year", "op": "=", "value": 2001}], "order": "desc", "limit": 3}
print(compile_semantic(demo))
try:
    compile_semantic({"metric": "sales", "channel": "web", "group_by": ["store_state"]})
except NotExpressible as e:
    print(f"\n  refused: {e}")

#### OUTPUT ####
SELECT d0.i_category AS category, sum(f.ws_net_profit) AS net_profit
FROM web_sales f
JOIN item d0 ON f.ws_item_sk = d0.i_item_sk
JOIN date_dim d1 ON f.ws_sold_date_sk = d1.d_date_sk
WHERE d1.d_year = 2001 AND d0.i_category IS NOT NULL
GROUP BY 1
ORDER BY net_profit DESC
LIMIT 3

  refused: store_state is not available for web sales
只连接请求实际需要的表,可以避免由于 NULL key 而意外丢失收入。分析器的 prompt 会列出目录:
   # semantic.py
SEMANTIC_SYSTEM = """Turn the question into JSON: expressible, metric, channel, group_by, order, limit
and filters (dimension, op from = != < <= > >=, value). Metrics: {m}. Dimensions: {d}.
Use stored values like 'TN'. Several channels, period comparisons or shares are not expressible.""".format(
    m=", ".join(METRICS), d=", ".join(DIMENSIONS))
在真实数据上,编译出的 SQL 与我检查过的每一个模板的手写 SQL 都匹配。有些问题超出了目录范围;涉及期间比较、总额占比或多个渠道的问题,仍然只交给 SQL writer。
双重记账校验器
会计会将每笔交易记录两次,当两笔记录一致时相信账本。我们有两条路径,也可以采用相同方法:路径 A 来自 SQL writer,路径 B 来自编译器,两者是否一致就成为答案的可信度。当二者不一致时,交给 Qwen/Qwen3.8-Max 上的 critic 阅读两者:
   # semantic.py
CRITIC_SYSTEM = """Pick the candidate whose SQL and rows answer the question: check measure, period,
filters, channel and double counting. Definitions:
{glossary}
Return JSON: {{"winner": "A|B|neither"}}"""
double_entry_settle 接收分析器和 writer 的回复,将两个查询一起执行,并且只修复 writer 的查询:
   # semantic.py
def double_entry_settle(text, cfg, drafts, run, compile_b=compile_semantic):
    # run both routes, repair A once
    sem, writer = (r.data if isinstance(r.data, dict) else {} for r in drafts)
    sqls = {"A": writer.get("sql"), "B": None}
    try:
        sqls["B"] = compile_b(sem) if sem.get("expressible") else None
    except NotExpressible:                       # A answers alone
        pass
    routes = {k: s for k, s in sqls.items() if s}
    if not routes:
        return run.answer("failed", message="no SQL")
    results = dict(zip(routes, parallel(*[lambda s=s: agent.AGENT_EXEC.run(s) for s in routes.values()])))
    run.sql(*results.values())
    ok = {k: r for k, r in results.items() if not repair_reason(r)}
    if "A" in results and "A" not in ok and (fixed := repair_sql(text, cfg, sqls["A"], results["A"], run)):
        qr = agent.AGENT_EXEC.run(fixed)
        run.sql(qr)
        if not repair_reason(qr):
            sqls["A"], ok["A"] = fixed, qr
    return trust_ladder(text, sqls, ok, run)
trust_ladder 会将结果转换为答案;它不设置阈值,因为拒绝单一路径答案会降低 utility:
   # semantic.py
def trust_ladder(text, sqls, ok, run):
    # agree 0.95, critic pick 0.7, one route 0.6
    if not ok:
        return run.answer("abstained", message="no usable result")
    if len(ok) == 1:
        (k, r), = ok.items()
        return run.answer("answered", sql=sqls[k], df=r.df, confidence=0.6)
    if COMPARATOR.compare(ok["A"].df, ok["B"].df).match or COMPARATOR.compare(ok["B"].df, ok["A"].df).match:
        return run.answer("answered", sql=sqls["B"], df=ok["B"].df, confidence=0.95)
    show = "\n\n".join(f"{k}:\n{sqls[k]}\n{ok[k].df.head(6).to_string(index=False)}" for k in "AB")
    r = ask(M_MAX, "critic", f"{text}\n\n{show}", CRITIC_SYSTEM.format(glossary=agent.GLOSSARY), max_tokens=300)
    run.llm(r)
    winner = r.data.get("winner") if isinstance(r.data, dict) else None
    if winner in ("A", "B"):
        return run.answer("answered", sql=sqls[winner], df=ok[winner].df, confidence=0.7)
    return run.answer("abstained", confidence=0.0, message="the routes disagree")
一致性检查会在两个方向上使用考试的比较器:
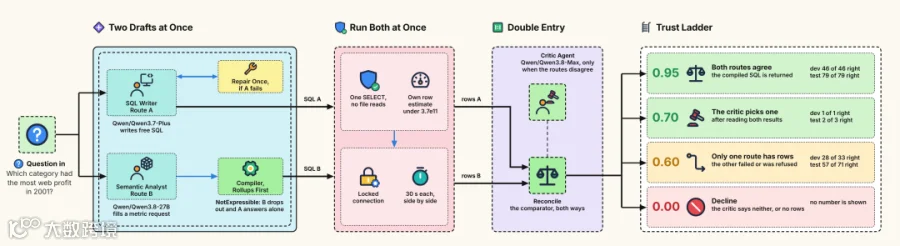
在 r07 中,两条路径的结果如下:
   #### OUTPUT ####
                     questions  answered  correct
both routes agree           40      100%     100%
disagree, critic: A          1      100%     100%
disagree, critic: B          3      100%     100%
no answer                    6        0%       0%
single route only           32      100%      75%
Utility 几乎没有变化,升至 +0.706。不过,可信度变得可靠了:40 个一致答案全部正确。代价是时间:每个问题执行两次查询,使答案中位耗时增至 12.27 秒。
按日期排序的副本与汇总表
在 r07 中,数据仓库占据每个答案耗时的 69%,而大多数问题都会按日期过滤。DuckDB 会保存每个数据块的最小值和最大值,并跳过范围不包含过滤条件的数据块,但 store sales 没有可利用的日期顺序。我构建了一个按日期排序的副本,用时 189.3 分钟:
   #### OUTPUT ####
  table              row groups   June 2001 must read: before    after
  store_sales             2,344                        100.0%     1.0%
  web_sales                 586                        100.0%     1.2%
现在,将 store sales 过滤到一个月只需访问其中 1.0% 的数据块:

在排序副本之上,我增加了五个按天汇总的汇总表,使用 LEFT JOIN 构建,因此其总计与事实表一致。语义路径会读取覆盖请求的最小汇总表:
   """speed.py: rollup routing and the speculative gate."""
from agent import Run, ask, intake_call, intake_stop, parallel, pick_examples, writer_prompt
from config import M_27B
from semantic import DATE_COLS, SEMANTIC_SYSTEM, compile_semantic, double_entry_settle

SUMS, ALL = {"sales", "net_profit", "units"}, {"store", "catalog", "web"}
ROLLUP_GRAIN = {  # dimensions, metrics, channels, smallest first
    "rollup_store_day": ({"store_state", "store_city"}, SUMS, {"store"}),
    "rollup_custstate_day": ({"customer_state"}, SUMS, ALL),
    "rollup_demo_day": ({"gender", "marital_status", "education"}, SUMS, ALL),
    "rollup_returns_day": ({"category", "return_reason"}, {"return_amount"}, ALL),
    "rollup_item_day": ({"category", "class", "brand"}, SUMS, ALL),
}


def pick_rollup(req):
    # smallest rollup holding the request
    need = set(req.get("group_by") or []) | {f["dimension"] for f in req.get("filters") or []}
    return next((name for name, (dims, metrics, channels) in ROLLUP_GRAIN.items() if need <= dims | set(DATE_COLS)
                 and req["metric"] in metrics and req.get("channel", "store") in channels), None)


def compile_semantic_fast(req):
    return compile_semantic(req, pick_rollup(req))   # same answer, far fewer rows
之前的 web 请求现在会读取一个汇总表:
   from speed import compile_semantic_fast

print(compile_semantic_fast(demo))

#### OUTPUT ####
SELECT r.category AS category, sum(r.net_profit) AS net_profit
FROM rollup_item_day r
JOIN date_dim d ON r.date_sk = d.d_date_sk
WHERE r.channel = 'web' AND d.d_year = 2001 AND r.category IS NOT NULL
GROUP BY 1
ORDER BY net_profit DESC
LIMIT 3
我检查过的全部 37 个汇总结果都与事实表匹配。为了让 agent 使用它们,我们关闭 con,导入 OPT_PATH,并将 agent.AGENT_EXEC = AgentExecutor(LockedWarehouse(open_warehouse(OPT_PATH, "8GB")), GUARD)。在 r09 中,答案中位耗时从 12.27 秒降至 6.03 秒。
推测式接入
数据仓库变快后,模型调用成为主要耗时来源。r09 中一个典型回答的中位耗时瀑布图显示了时间分布:
   #### OUTPUT ####
  intake                         1.27s  ############
  semantic + sql in parallel     5.06s  ##################################################
  execute both                   0.79s  #######
  total                          7.12s
drafts 要等待 1.27 秒的 gate,而大多数问题都会通过。CPU 会使用推测执行来处理这类等待,我们借鉴了这个想法:最终系统同时启动三个调用,如果 gate 判断不应回答,就丢弃 drafts:
   # speed.py
def make_speculative_agent(cfg):
    # the final system: gate and drafts at once
    def answer(text):
        run = Run()
        examples = pick_examples(text, cfg.fewshot) if cfg.fewshot else []
        calls = parallel(lambda: intake_call(text),
                         lambda: ask(M_27B, "semantic_analyst", text, SEMANTIC_SYSTEM, max_tokens=400),
                         lambda: ask(cfg.writer, "sql_writer", writer_prompt(text, cfg, examples), max_tokens=1500))
        run.llm(*calls)                          # one step on the clock
        if stop := intake_stop(calls[0], run):   # drafts paid for, then dropped
            return stop
        return double_entry_settle(text, cfg, calls[1:], run, compile_b=compile_semantic_fast)
    return answer
同一个问题现在耗时 6.64 秒:
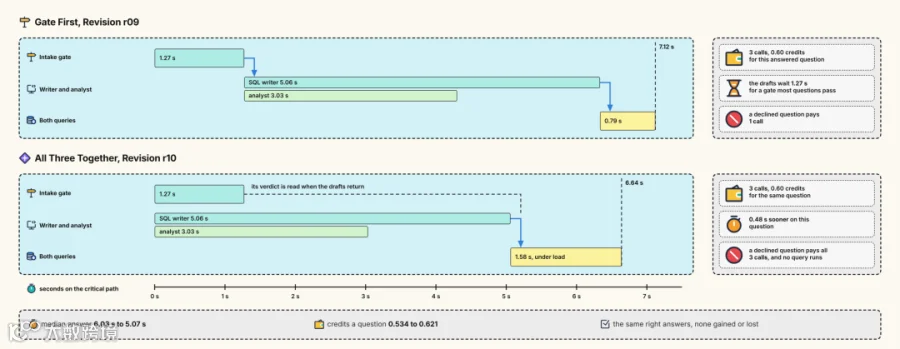
开发集答案的中位耗时现在为 5.07 秒,比之前快了一秒,正确答案保持不变。推测执行也有代价:如果 gate 阻止一个问题,仍然要为那些最终不会使用的 drafts 付费,每个问题的成本上升到 0.621 credits。
Writer 对决
我之前只根据价格选择了 Qwen/Qwen3.8–27B 作为 writer,从未将它生成的 SQL 与其他模型进行比较。我让最佳系统分别使用五个 writer 模型,在全部 82 个有答案的开发问题上各运行一次:
   #### OUTPUT ####
writer                   utility     T3  false_success  p50_s  credits_per_q
Qwen/Qwen3.7-Plus          0.793  0.667          0.062  5.036          0.611
Qwen/Qwen3.7-Max           0.756  0.600          0.075  4.669          0.912
Qwen/Qwen3.8-Flash-Next    0.744  0.533          0.076  4.372          0.621
Qwen/Qwen3.8-27B           0.683  0.467          0.100  6.382          0.626
Qwen/Qwen3.8-Max           0.671  0.467          0.101  4.487          0.924
五个模型都能正确回答 98% 的日常问题,因此最终由困难的官方层级决定胜者。Qwen/Qwen3.7-Plus 每次调用只需 0.2 credits,最终获胜;两个 Max 模型得分较低,却需要 0.5 credits。更便宜的模型还生成了更好的 SQL:
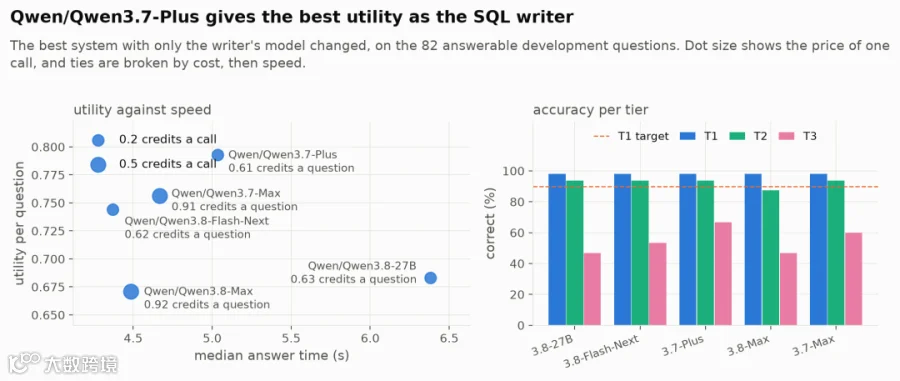
作为 r12 采用新 writer 后,utility 提升到 +0.833,错误成功率降至 6.2%。
再次处理慢速尾部
在 r12 之后,只剩下 5 个自信的错误答案,且全部来自只有单一路径返回行的问题。使用 Qwen/Qwen3.7-Max 的第二个 SQL writer(r13)为这些问题生成了另一条独立查询,但两个 writer 还对 2 个错误答案达成了一致,因此我回滚了这项改动。
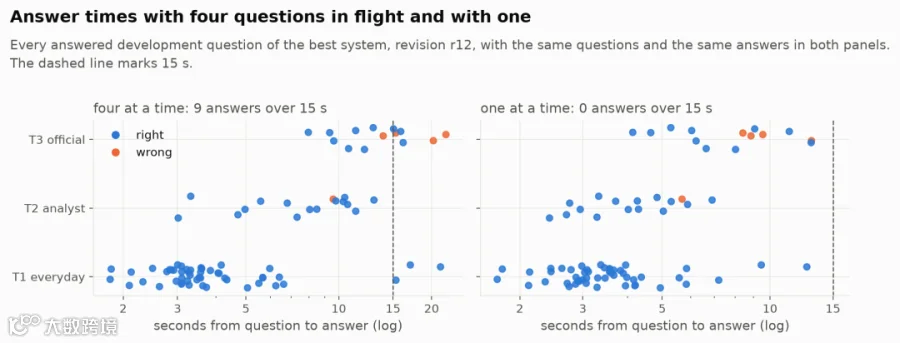
为了节省数小时,每次修订都会同时运行四个问题;但延迟目标描述的是一个人一次提出一个问题时的体验:
   #### OUTPUT ####
view            p50_s  p95_s  answers_over_15s  right_over_15s
four at a time   3.68  15.85                 9            0.67
one at a time    3.57   9.44                 0             NaN
同时运行四个问题时,超过 15 秒的答案只有 67% 是正确的:

每个问题 15 秒的预算(r15)将第 95 百分位降至 12.09 秒,但使一个正确答案变错,因此我也回滚了它。
针对最难问题的深度模式
针对官方查询,我在 Qwen/Qwen3.8-Max 上构建了一个 investigator,让它在最终查询之前先对数据进行采样:
在 r11 中,对 15 个官方开发问题进行测试时,它将正确答案数从 6 个提升到 8 个,但中位耗时为 28.8 秒,每个问题需要 2.17 credits。这对每个问题来说都太慢、太昂贵,因此深度模式保持为可选功能。
留出测试
考试创建时留出的 194 个测试问题从未用于选择任何修订。我将两个系统分别运行了一次:
   #### OUTPUT ####
                              obvious agent          final system (r12)
T1 everyday accuracy    66.7% (CI 57 to 76)         90.9% (CI 85 to 96)    target >= 90%
T2 analyst accuracy                   39.0%                       80.5%
T3 official accuracy                  37.5%                       62.5%
false-success rate      47.1% (CI 40 to 55)          9.8% (CI 5 to 15)     target <= 5%
T4 handled                            23.3%                      100.0%
latency p50 / p95            3.33s / 17.08s              3.40s / 12.78s    target 5s / 15s
credits per question                   0.20                        0.62
面对从未见过的问题,日常准确率超过了 90%,所有不得回答的问题都被拒答。错误成功率没有达到 5% 的目标:

在开发集从未出现过的 12 个模板上,准确率较低:日常问题准确率为 85%,而熟悉模板上的准确率为 96%。critic 的一次错误选择将“How much Children did we sell”理解为 units,而参考答案计算的是 sales 总额。
实时秒表
用户等待的是包含重试和慢速 endpoint 在内的真实时间。最后一次测量从空缓存开始,对 20 个测试问题各重复三次,并使用秒表计时:
   #### OUTPUT ####
60 live answers: 20 test questions x 3 repeats
stopwatch p50   3.82s   target <= 5s    MET
stopwatch p95  24.55s   target <= 15s   MISSED
最慢的答案说明了尾部耗时为何未达标:
   #### OUTPUT ####
t1_sales_by_education#5 (repeat 3): 113.69s, answered, right
    intake + semantic + sql in parallel     1.89s  intake
    intake + semantic + sql in parallel     2.07s  semantic_analyst
    intake + semantic + sql in parallel     2.69s  sql_writer
    execute both                           68.58s  timeout
    execute both                            2.91s  ok
    repair_1                                3.22s  repair
    execute_after_repair_1                 38.36s  timeout
一个查询在 interrupt 生效前运行了 68.58 秒,修复查询再次超时,而另一条路径已经在 2.91 秒内返回了正确答案。答案必须等待两条路径,而其中一条卡住的查询就决定了整体耗时:

   """panel.py: one answer and its evidence."""
import time


def answer_panel(text, agent):
    t0 = time.perf_counter()
    a = agent(text)
    print(f"{a.status}, confidence {a.confidence}. {a.message}".rstrip())
    print(f"{time.perf_counter() - t0:.2f}s (model {a.llm_s:.2f}s, warehouse {a.sql_s:.2f}s), "
          f"{a.calls} calls, {a.credits:.2f} credits")
    if a.sql:
        print(a.sql)
    if a.status == "answered":
        print(a.df.head(10).to_string(index=False))
    return a
对同一批答案求和后的步骤耗时为 3.80 秒和 24.51 秒,与秒表结果接近。早期的一次实时运行中,15 秒预算同时满足了两个目标,但它让开发集中的一个正确答案变错,因此我没有启用它。
向数据仓库提问
所有工作最终汇聚为一个函数:接收问题并解释答案。
测试集中的第一个日常问题:
   from config import M_PLUS
from panel import answer_panel
from speed import make_speculative_agent

final = make_speculative_agent(Config(intake=True, glossary=True, fewshot=3, repair=True, writer=M_PLUS))
answer_panel("Give me the total in-store revenue for Tennessee in 1998.", final)

#### OUTPUT ####
answered, confidence 0.95.
3.13s (model 2.78s, warehouse 0.33s), 3 calls, 0.60 credits
SELECT sum(r.sales) AS sales
FROM rollup_store_day r
JOIN date_dim d ON r.date_sk = d.d_date_sk
WHERE r.store_state = 'TN' AND d.d_year = 1998
         sales
12469910783.89
两条路径达成一致,因此 panel 展示了路径 B 使用的 store rollup SQL。仓库中更完整的 panel 还会添加路径和时间线;图中也展示了它如何拒绝 2015 年的问题并给出原因:

在答案展示后,图表会交给 Qwen/Qwen3.8-Omni-Flash 进行检查。在 12 个真实图表上,它没有产生任何误报,同时捕获了我植入的 71% 的错误。
已知限制
仍有两个目标没有达成。在测试集中,已回答问题中有 9.8% 是错误的,是 5% 目标的两倍;15 个错误答案中有 14 个来自只有一条路径返回行的问题。实时第 95 百分位为 24.55 秒,而目标是 15 秒。
这些数字只覆盖一个生成的数据仓库、一台笔记本电脑、一个用户,以及运行当天的 API。它们不能与 text-to-SQL leaderboard 直接比较。
安全测试通过 SQL 发送了 11 个攻击,但没有尝试隐藏在数据值中的指令。较早的系统也在测试集上运行过,而在开发集上我修复了两个错误的决策规则。图表检查器使用的模型没有公布价格,因此其成本未计入。
left out:表清单与计时代码、链接和覆盖率检查、官方答案加载器、zone-map reader、副本构建器和汇总 SQL、investigator,以及图表检查器