0. 核心术语定义
"本体(Ontology)"一词在不同语境下口径不同。
狭义的知识工程口径,采用 Tom Gruber 1993 年的定义:"共享概念化的显式形式化规范说明"(a formal, explicit specification of a shared conceptualization),以 RDF、OWL 等形式化语言为载体,常见于学术文献、语义网与知识图谱技术栈。
广义的业务建模口径,指用业务语言对企业世界的对象、关系、行为、规则做的显式建模,不强制要求形式化语言,Palantir Ontology、企业架构与业务中台语境下多用此义。
行业常用的数据治理口径,则把本体理解为数据资产与业务概念之间的语义映射层,常与元数据管理、数据目录混用。
在此口径下,本文对三个核心概念采用如下统一定义。
业务本体:用业务语言对企业核心对象、对象关系、对象行为(动作)与约束规则做的显式建模,载体可以是白板、表格,也可以是形式化语言。
数据本体:数据资产到业务概念的语义映射层,回答"这张表、这个字段、这个指标代表什么业务含义"。
本体语义网络:本体以"节点+带标签的边"构成的网络形态,用RDF/OWL形式化编码后支持机器查询与逻辑推理。
1. 背景:为什么是现在
1.1 演进脉络:每一代方案解决了上一代什么痛点
企业对本体的需求不是凭空出现的,而是沿着一条清晰的演进链走过来,每一代方案都在修上一代的短板。
2000年前后,企业用词表和业务术语表解决"同一个词各部门理解不一"的问题。词表给了定义,但没有结构,术语之间无法建立关联,支撑不了任何分析。
2000年代的数据仓库与主题域模型统一了报表口径,让数据可以按主题组织。但数仓以表和字段为中心,业务语义被埋进 ETL 逻辑里——看懂"客户"这张表为什么这么加工,需要读代码。
2010年代的数据中台与元数据管理让数据资产变得可见、可管。但元数据管理多停留在技术层(表在哪儿、谁在用、什么时候更新),"这份数据在业务上到底代表什么"依然答不上来,"数据沼泽"问题没有根治。
2012年之后,知识图谱从Google搜索扩散到企业,实体关系第一次被显性化、可查询。但实践中很快发现:没有解释框架的图谱,只是一堆连起来的数据——节点和边的含义各写各的,难以治理,也难以在其上做严格推理。
2020年后,以Palantir Ontology为代表的企业级本体范式和GraphRAG架构兴起,目标是给AI补一层可追溯的业务语义底座,抑制大模型的幻觉。这一代的遗留问题也很明确:建模人力成本高,落地门槛集中在组织协作而非技术本身。
对这条脉络的读法是:本体不是替代数据中台,而是在其上补一层业务语义。数据中台解决了"资产汇聚与质量管控",本体层解决"资产代表什么业务含义、AI如何据此推理"。
1.2 当前驱动因素
第一是大模型的幻觉与不可追溯问题。大模型缺乏企业私有业务知识,直接回答业务问题不可靠。GraphRAG类架构需要显式的实体关系与约束框架来锚定检索与推理。
第二是数据治理存量需要语义化。多数企业已完成数据汇聚,卡点从"有没有数据"变成"数据口径是否一致、能否被机器理解"。
第三是市场信号。据Grand View Research(转引自 STS Tech 白皮书,第三方转引口径),企业知识图谱市场2025年约29亿美元,预测2033年达134亿美元,年复合增长率21.3%。
2. 核心定义与底层逻辑
2.1 业务本体:业务世界的可计算镜像
业务本体通常归纳为五类要素:对象、关系、属性、动作、规则。需要说明的是,不同范式的归置略有差异:Palantir官方范式以Object Type(对象类型)、Link Type(链接类型)、Action(动作)为三个核心原语,Function(函数)承载业务逻辑,属性不单设原语、而是作为对象类型的字段内含其中,故常被概括为"四原语"。国内实践中(如金融、政务等强合规场景)则常把"规则"从函数中独立出来,与对象、关系、动作并列为第四类核心要素,形成"对象、关系、动作、规则"的四分法。无论哪种口径,本文的五分法都可与之对应:属性对应Palantir对象类型上的字段,规则对应Function或独立的规则要素。
用业务语言对应来看:对象对应名词,是业务世界里的实体,如客户、订单、合同、风险事件。关系对应动词和介词,如"客户-下单-订单"、"事件-影响-区域",关系是一等公民,自带语义且可反向推导。属性对应限定词,描述对象的状态特征,如金额、状态、签约日期。动作对应业务上可执行的操作,如审批、发货、创建工单,动作让本体从"描述世界"升级为"操作世界",Palantir 类平台已将其产品化,自建企业需自行实现。规则对应约束与推理逻辑,如"信用额度不足的订单不能审批通过",形式化规则引擎的成熟度不一,多数企业目前停留在文档层。
与传统数仓建模的差异在于建模中心:数仓以表、字段、ETL流水线为中心;业务本体以对象、关系、行为为中心。Palantir方法论称之为"决策倒推建模"——从关键决策场景出发,推导需要哪些对象、关系与动作,"每个模型必须支撑一个决策或触发一个动作"。
业务本体的另一个关键特性是数据-语义解耦:底层系统可替换,本体层保持稳定,应用只依赖本体。这是Palantir Foundry已落地的架构设计原则,但该经验限于其平台,自建场景下需要自行投入治理成本维持。
2.2 数据本体:业务语义与物理数据的桥梁
数据本体站在数据视角,回答"数据代表什么业务含义",通常覆盖三层元数据,这一分层在业内已是通行做法。
业务元数据是本体化的主战场,包括概念定义、业务规则、指标口径和数据血缘。本体化后,跨系统的语义互操作成为可能——信用卡客户、贷款客户、理财客户可以统一挂载到"客户"这个概念下,共享核心属性、保留专属属性。
技术元数据包括物理存储、数据格式和加工逻辑。本体负责把它们"对号入座":某个概念对应哪张表、哪个字段、哪个接口,映射关系被显式记录。
操作元数据包括质量指标、访问日志和变更历史。本体为质量检查提供了语义依据:属性值必须在定义域内、关系必须满足完整性约束、跨系统数据必须满足一致性规则。
数据本体与业务本体的分工可以概括为:业务本体定义概念框架,业务人员是主角。数据本体完成数据挂载与口径统一,数据团队是主角。二者是上下游关系,不是并列可选关系。
2.3 本体语义网络:形式化载体
本体语义网络用W3C标准技术栈编码,技术栈本身成熟。RDF 把一切知识表达为三元组(主语-谓语-宾语),例如"订单#1001 属于客户#C007",这是最底层的知识原子。RDFS/OWL在其上定义类层级、属性约束和公理,支持推理——定义"VIP客户是客户的子类"及相应折扣规则后,机器可自动推导出每个具体VIP的订单折扣,无需逐条人工编写。OWL成熟但需要权衡表达力与推理成本,OWL 2 DL在大实例规模下推理开销明显。SPARQL是图上的查询语言。SWRL/SHACL负责业务规则表达与约束校验,可用但工程采用度低于前三者。推理机(HermiT、Pellet 等)负责一致性检查与新事实推导,在学术和医疗、生物领域使用广泛。
部署后的企业知识图谱通常分两层维护,职责必须分清。TBox(术语层/规则层)就是本体本身——类、属性、公理,相对稳定,需要版本治理;ABox(事实层/数据层)是具体实例——某张订单、某个客户,数据量大、更新频繁。没有本体的图谱是一堆带连接的数据,缺少统一的解释框架,没有图谱实例的本体则没有推理对象,二者互为存在条件。
2.4 概念对比矩阵一:词汇表/分类法/模式/本体
这四个概念经常被混用,用矩阵厘清边界:
维度 |
词汇表Glossary |
分类法Taxonomy |
模式Schema |
本体Ontology |
解决的核心问题 |
术语含义不统一 |
归类层级不清 |
数据结构不清 |
概念、关系、规则、推理全覆盖 |
形态 |
术语+定义 |
树状层级 |
表/字段定义 |
类+关系+属性+公理 |
机器可推理 |
否 |
有限(父类继承) |
否(仅结构校验) |
是 |
与数据的关系 |
无直接绑定 |
弱绑定 |
强绑定 |
绑定且可映射物理数据 |
典型误区 |
当成本体做完就结束 |
与本体混为一谈 |
用建表思维建本体(追求一次定型) |
追求大而全,迟迟不交付 |
边界说明:最容易混淆的是"模式"与"本体"——本体包含模式,但增加了模式无法表达的关系语义与推理规则。
2.5 概念对比矩阵二:业务本体vs数据本体
二者经常被统称为"本体",需要按视角区分:
维度 |
业务本体 |
数据本体 |
边界说明 |
解决的核心问题 |
业务世界是什么、能做什么 |
数据代表什么业务含义 |
二者经常被混称为"本体",需按视角区分 |
建模中心 |
对象、关系、动作、规则 |
概念与表/字段/指标的映射 |
边界在"业务语言"与"数据语言"之间 |
主角角色 |
业务人员、架构师 |
数据团队、治理团队 |
组织分工的依据 |
典型载体 |
工作坊产出物、Palantir类平台、OWL |
元数据平台、数据目录、指标语义层 |
工程上二者常共用一套工具链 |
成熟度 |
方法论通行,产品化程度因平台而异 |
数据目录工具成熟,语义映射多需人工 |
最易混淆处:把元数据管理当成数据本体建设的全部 |
依赖关系 |
上游,先定义 |
下游,后挂载 |
顺序颠倒会导致数据驱动建模,语义失真 |
2.6 三层递进结构
三者构成"业务语义 → 数据映射 → 形式化计算"的递进链:
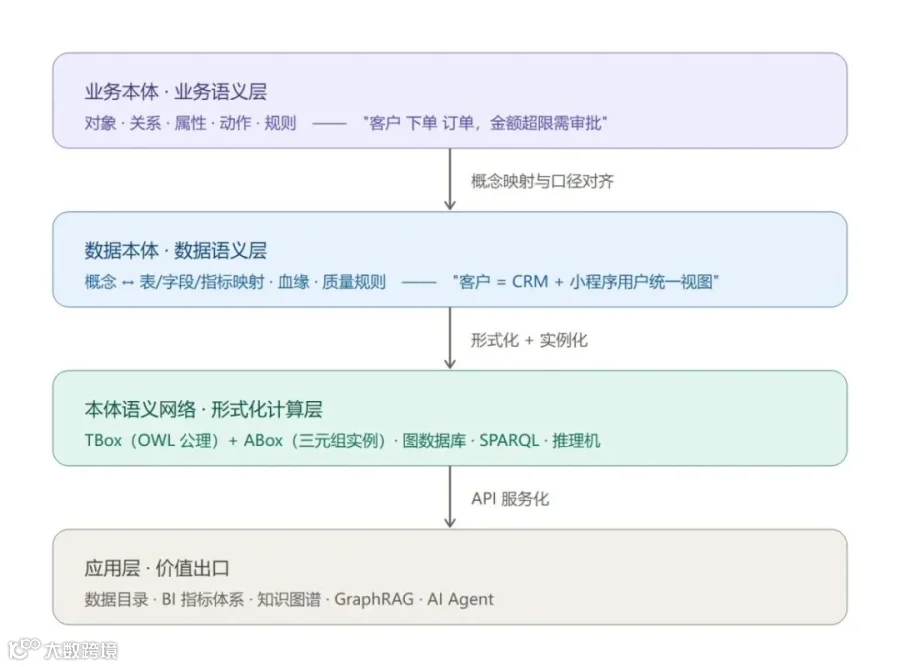
第一层:业务本体(业务语义层)——对象/关系/属性/动作/规则,对应业务断言"客户-下单-订单,金额超限需审批"。
向下经过「概念映射与口径对齐」,进入数据语义层。
第二层:数据本体(数据语义层)——概念与表/字段/指标的映射、血缘、质量规则,对应映射声明"'客户'=CRM.customer+小程序用户统一视图"。
向下经过“形式化+实例化”,进入形式化计算层。
第三层:本体语义网络(形式化计算层)——TBox(OWL公理)+ABox(三元组实例),由RDF/OWL+图数据库+SPARQL+推理机承载。
向下经过“API服务化”,最终到达应用层。
应用层(价值出口),包括数据目录、BI 指标体系、知识图谱、GraphRAG、AI Agent。
用一个贯穿的例子说明(零售场景,示例属说明性构造,非公开案例)。
业务本体层定义:"客户"与"订单"存在"下单"关系;规则:"月消费超 1 万元自动升级 VIP"。
数据本体层映射:"客户"对应 CRM 的customer表与小程序用户表的统一视图;"订单金额"统一取订单主表pay_amount字段,口径与财务核对。
语义网络层把两层内容编码为OWL公理与三元组,推理机自动识别出所有VIP客户;当AI Agent被问"该客户为何是 VIP"时,可沿语义网络给出可追溯的推理路径,而非大模型生成式回答。
3. 本体语义网络构建方法
3.1 业务本体构建
业务本体构建分为五步:
第一步,圈定最小可行本体(MVO)。 只选一个高价值决策场景(如大客户续约、分销断货预警),列出10~30个核心概念。首发规模建议5~8个实体类型、10~15个关系类型(STS Tech白皮书建议口径)。
第二步,工作坊共创,先语义对齐、再形式化。业务、数据、技术三方以白板或在线表格列出名词(对象)、动词(关系)、限定词(属性)、"能不能做"(规则)。直接从OWL公理入手会导致业务人员退出协作。
第三步,定义能力问题(Competency Questions)。写出本体建成后必须能回答的业务问题,作为验收标尺,防止模型范围膨胀。
第四步,对齐数据源。 每个概念对应的表、接口、指标口径当场记录进语义词典,第一天不必使用 RDF。
第五步,迭代验证。 用最小本体跑通一个真实决策场景,再扩充,保持向后兼容。
方法论选择上,中小项目与入门场景用可以使用斯坦福七步法(确定范围、复用已有本体、列举术语、定义类层级、定义属性、定义约束、创建实例),简单直接。企业级全生命周期项目可用METHONTOLOGY或NeOn,覆盖完整生命周期但文档与治理成本高。希望业务专家主导快速原型时,UPON Lite 的六步流程(领域词表、术语定义、层级划分、属性、部分整体关系、形式化)对业务人员最友好。分布式团队的长期演进协作,则适合DILIGENT的"本地适配+控制板评审+共享本体更新"机制。
3.2 数据本体构建
数据本体构建有两条路径,自下而上和自上而下。
导入驱动(自下而上)方式从已有数据资产出发,适合数据资产厚实的企业:按外键约束排序遍历库表Schema,把表映射为实体、字段映射为属性、外键映射为关系;可以辅助用大模型从数据字典、制度文档中抽取语义,逐片生成、验证后合并为全局本体。LLM辅助管线目前仍停留在论文与早期实践阶段(见 2026 年arXiv相关论文),尚无大规模落地。
场景驱动(自上而下)方式从业务本体的概念框架出发,反向为每个概念指定数据来源与加工口径,适合从零起步、以高价值场景切入的团队。
无论哪条路径,两项工程动作不可省。其一是实体解析先行:同一客户在 CRM、ERP、日志系统中的多种表示需先做 ID 归一与去重——在未清洗的资产上建本体,只是把混乱形式化——这一点已是行业共识。其二是指标语义层建设:先完成指标口径与元数据标准化,确保同名同义。国内金融机构的轻量化实践普遍选择"独立指标语义层"而非改造核心业务系统,并指出本体的抽象概念建模通常仅需3~4层指标关联,传统关系型数据库即可满足性能需求,中小机构不必盲目投入图数据库。
3.3 语义网络构建
语义网络构建分为四步:
第一步,形式化建模。 将概念表导入 Protégé,定义类层级(subClassOf)、对象属性(含定义域、值域)、数据属性、约束公理,导出 OWL/Turtle。
第二步,实例化(数据水合)。 按数据本体定义的映射规则,将物理表数据转换为三元组灌入图数据库(GraphDB、Neo4j、Apache Jena 等),边灌边做结构校验。
第三步,推理与查询验证。 将能力问题逐一改写为SPARQL查询验证,用推理机检查逻辑一致性(如矛盾继承链)。
第四步,发布与服务化。 通过API或GraphRAG组件暴露给应用层。典型协同架构为"大模型(意图识别与生成)+向量库(语义检索)+本体/知识图谱(逻辑推理与一致性保证)",属当前主流设计方向,但工程上理论方案与早期实践并存,规模化案例仍有限。
工具选型上,开源与商业方案并行,无公开权威打分,以下为常见组合:本体建模环节,开源用Protégé、WebVOWL,商业用PoolParty、TopBraid;存储与推理环节,开源用GraphDB免费版、Apache Jena,商业用Stardog、Ontotext商业版;数据目录环节,开源有DataHub、Amundsen,商业有Collibra、Alation;可视化环节可用Cytoscape、Linkurious社区版或Cambridge Semantics等商业产品。初次尝试的企业,从Protégé加GraphDB免费版的轻量组合起步即可。
4. 产业案例与量化收益
Palantir×汽车供应链是常被引用的正面案例:构建供应链本体后,公开行业文章口径称库存周转率降低25%、响应时间从3天缩至8小时、物料分配效率提升45%。需要说明的是,这些数字来自国内行业社区文章转述,未在 Palantir 官方文档中逐项核实。
金融数据治理是行业通行方案描述最充分的领域:以本体Schema让信用卡、贷款、理财客户共享核心属性、保留专属属性,解决跨产品线的语义互操作。该描述属行业通行方案,公开细节有限。
医疗数据校验方面,用本体规则发现 15% 的处方记录存在药物相互作用风险,而传统字段校验难以发现。
金融风控方面,基于本体的特征工程使模型开发效率提升约 40%,可解释性提高。
反面案例:瀑布式建模。 某机构为营销知识图谱开了9 个月工作坊、14个干系人参与,最终产出180页规格书、0条可用查询,项目被取消(STS Tech白皮书匿名案例)。它说明的结论与正面案例指向一致:本体工程失败的主因是瀑布式组织方式,而非技术本身。
除了上述业务收益,可解释性与可追溯性是更值得强调的收益:本体支撑下的AI问答可给出推理路径,这是纯大模型方案不具备的性质,属结构性收益而非百分比收益。
5. 成本约束与短板风险
5.1 成本约束
成本与门槛是落地的主要约束。人力成本上,本体建模需要"深度业务认知+建模方法"的复合能力,学界与业界均指出该人才缺口是规模化推广的主要壁垒;Palantir的FDE驻场模式人力投入重,中小机构难以复制。工具成本上,入门组合(Protégé + GraphDB 免费版)零许可成本,商业组合(Collibra、Stardog等)许可费无公开统一口径,需按规模询价。组织成本上,工作坊需要业务、数据、技术三方持续投入,本体版本治理需要长期专职角色,多数企业低估这一点。存算成本上,实例层数据量大,图数据库选型与硬件投入需按场景评估;轻量化路径(指标语义层+关系型数据库)可控制此项。
5.2 技术短板与落地风险
技术层面有三条主要局限。一是OWL推理的表达力与性能矛盾:OWL 2 DL推理在实例规模大时性能下降明显,工程上常退化为"轻量推理 + 显式规则"的组合。二是LLM自动建本体的质量风险:大模型从文本抽取类与关系存在幻觉与口径漂移,生成的层级需领域专家逐项审核,该管线目前仍处于论文与早期实践阶段,不可无人审直接交付。三是实体解析的错误传导:ID归一错误会沿语义网络传导到推理结论,且难以事后定位。
组织与治理层面有四类高频风险。 一是瀑布式规划:追求一次建成"全企业百科"是最高频的失败模式(见第 4 节反面案例),对策是MVO加90天内可演示。二是本体漂移:业务术语与规则持续变化,缺乏版本治理与评审机制的本体会逐渐失真,半年后与业务脱节,DILIGENT类协作评审机制是可行对策,但需要专职角色支撑。三是业务参与断档:建模由数据团队单方面推进时,业务口径的争议无法及时裁决,本体沦为技术自嗨文档。四是与存量体系的关系处理不当:本体层需要对接数据中台、数据目录、BI指标体系,任何一处口径冲突都会放大为组织级争议,轻量化路径建议先做指标语义层而非全面铺开。
7. 本体工程演化方向
业界对于本体工程的未来演化方向众说纷纭,大致有以下四个方向:
其一,神经符号架构常态化:大模型(自然语言理解)+向量库(语义检索)+本体/知识图谱(逻辑推理与一致性保证)的三件套组合,可能成为企业级AI问答与Agent的标准底座;前提是本体建模的门槛通过工具与大模型辅助显著降低。
其二,Agentic Ontology 平台化:国内厂商已出现将本体作为AI知识基础设施中枢的平台设计(比如东方国信Agentic Ontology),方向是把对象、关系、动作、规则做成AI Agent可直接调用的操作层。
其三,本体建模的组织众包化:基于BI画布的"业务人员拖拽建链 + 审核发布"模式(金融机构轻量化报告口径)若验证有效,本体建模的主力可能从专业建模师转向业务专家,FDE驻场模式相应收缩。
其四,上下文图谱与本体分层共存:本体提供稳定的实体关系骨架,其上记录决策痕迹(谁批的、依据什么先例)的上下文层可能成为合规场景的标配,二者不冲突、需联合规划。
8. 结语
业务本体用业务语言把企业"是什么、有什么、能做什么"建模为可计算的对象-关系-动作-规则网络,是语义的源头。数据本体把数据资产挂载到业务概念上,实现跨系统语义统一,是业务语义与物理数据之间的桥梁。本体语义网络用RDF/OWL把前两者形式化为"规则层+事实层",是机器推理的技术载体。
本体工程的价值不在于概念本身,而在于它给AI补上了一层共享的、形式化的、可推理的业务语义。落地的主要瓶颈不在技术栈,而在建模人才、组织协作与持续治理。
本体论、FDE、Workbuddy资料下载方式:
扫描下方二维码加入知识星球“金融科技与数字化转型”(持续运营2000余天),更有清华大学、北京大学、复旦大学最近报告论文,人工智能、金融科技、智能制造、麦肯锡、IBM、埃森哲、华为咨询方法论案例等超千份资料实时更新。