一、开源初心
调用过大模型 API,搭过 RAG,也尝试过预训练?Transformer 里的归一化、位置编码和激活函数,为什么这样设计?模型训练变慢、显存不够时,又该从哪里排查?
这些问题,把我们从模型的使用带到了模型的内部。想回答它们,就需要把模型架构、训练方法、数据处理与系统工程放到一起理解。
斯坦福 CS336(Language Modeling from Scratch)为这条学习路径提供了扎实的起点。不过,从英文课程、论文和作业出发,把知识串起来,再落实到自己的代码与实验,依然需要投入不少时间。
为此,Datawhale 社区共建了
Diy-LLM
:一套
在 CS336 基础上整理与拓展、面向中文学习者的大语言模型教程
。
我们希望用中文讲解、配套代码和实践作业,把构建语言模型拆成可以逐步理解、逐步实现的环节。读到分词器,就去实现文本编码;学到模型架构,就搭建一个小模型;遇到训练与推理瓶颈,再回到资源核算和系统优化中寻找原
因。
Diy-LLM 目前围绕
16 章
教程和
6 组
实践作业展开,覆盖预训练数据、分词器、Transformer、MoE、分布式训练、Scaling Laws、推理与对齐。主体章节和全部作业已经可以学习;第 1 章「工具使用」仍在完善,第 16 章扩展内容持续更新。
项目入口:https:在线阅读:https:离线阅读:仓库 Releases(https:
二、学习指南
我们把 16 章教程与 6 组实践作业梳理成五个循序渐进的阶段。你可以循序渐进地读,也可以带着已经遇到的问题,直接找到对应章节与实践入口。
1. 从基础组件出发,手搓你的第一个语言模型
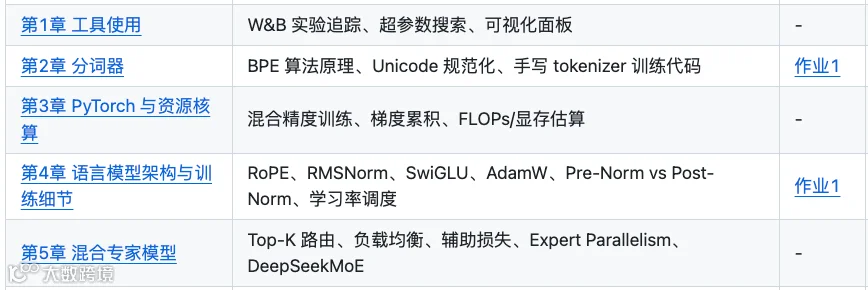
教程第 1—5 章从工具使用、分词器与 PyTorch 出发,逐步进入语言模型架构、训练细节和混合专家模型(MoE)
。结合
【作业1:基础组件实现】
,你将走出一条从 BPE 到 Transformer 的手写路径:读懂 RoPE、RMSNorm、SwiGLU 各自在解决什么,把分词器、模型结构和优化器自己接起来,完成一次完整的小模型训练。、
2. 走进 GPU 与分布式训练,理解模型为什么跑得快或慢
模型跑起来之后,接下来的问题往往是:时间花在哪里,显存又被谁占用了?
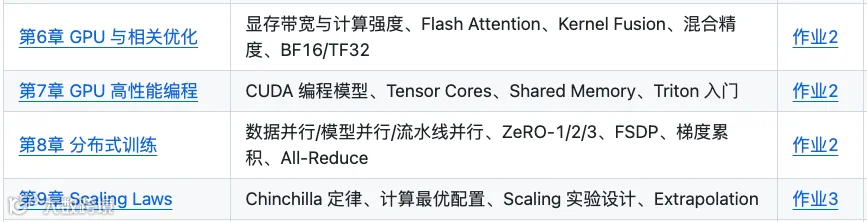
第 6—9 章深入 GPU 原理与优化、高性能编程、分布式训练和 Scaling Laws。从显存带宽、算子融合、FlashAttention,到 Triton、ZeRO 与 FSDP,把训练背后的工程问题逐一展开。配合
【作业2:系统优化】
与
【作业3:扩展定律】
,你可以带着性能分析、注意力计算优化与缩放规律拟合的实验结果回头理解:一次优化到底改善了什么,扩大模型之前又该如何估算规模、数据和算
力的配比。
3. 连接数据、推理与评估,把训练放进完整闭环
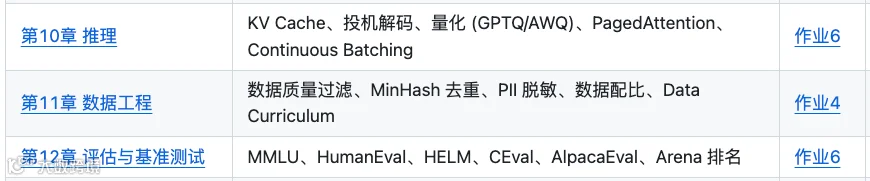
第 10—12 章分别讨论推理、数据工程以及评估与基准测试。
【作业4:数据处理】
围绕预训练数据的清洗、过滤与去重展开,带你直观感受原始网页如何变成高质量训练语料;推理章节则深入拆解 KV Cache、量化和批处理如何影响效率;而在
【作业6:模型评估】
中,你将结合 lm-evaluation-harness 与 EvalScope 等工具,在语言理解、代码、数学推理等维度建立起完整的评估判断
依据。
4. 从预训练走向对齐,理解模型能力如何继续塑造
第 13—14 章梳理大模型的基本训练流程,以及可验证奖励的强化学习。从预训练、监督微调(SFT),到 DPO、RLHF 与 GRPO,重点拆解不同阶段的目标、数据形式和优化方式。
【作业5:模型对齐】
提供了 SFT 与强化学习的配套实践,以数学推理任务为切入点,让你在可观察的任务反馈中,亲手验证推理模型的对齐
路线。
5. 延伸到多模态与前沿内容,继续读懂新的模型设计
进入第 15—16 章,视野将延伸到多模态模型与扩展内容,涉及 CLIP、视觉语言模型(VLM),以及 LLM 推理和未来发展方向等主题。后续项目还会持续补充主流模型的架构解读,连接具体模型的关键机制与实现思路,让基础积木的学习与前沿模型阅读无缝衔
接。
三、 写在最后
在深入大模型研发与学习的过程中,我们常常会遇到这些渴望“打破黑盒”的时刻:
看着最新论文里的架构设计(如 RoPE、SwiGLU、MoE),明白公式却不知道落到代码里该怎么写;
多卡训练一跑起来就显存爆炸或通信变慢,面对庞大的系统级优化参数不知从何下手;
想要把模型做大或引入新数据,却搞不清数据清洗管线怎么搭、算力预算该怎么科学估算;
听说强化学习与 GRPO 能激发模型的数学与推理潜力,却苦于没有一套干净的代码库来动手验证。
在这些时刻,我们需要的是一套
能单步调试、能剖析耗时、能形成数据与评估闭环的实践方案
。
Diy-LLM 适合大学生、研究人员,以及希望系统理解大模型训练与工程细节的开发者。只要你具备 Python 与 PyTorch 深度学习基础(CUDA 完全可以跟着第 6、7 章边学边补;已经写过 kernel 的朋友则可以直接切入性能分析和分布式训练),就可以从小规模实验入手,先跑通流程,再逐步增加难度。
不妨现在就打开在线文档,从分词器章节和第一组作业开始:读一段原理,实现一个组件,再用实验检查自己的理解。也欢迎大家通过项目仓库反馈问题、补充实验,一起共建后续的前沿模型架构解读!
从一个分词器、一个小模型开始,动手理解大模型。
开源地址
:
https://github.com/datawhalechina/diy-llm
 开源贡献,点赞在看↓