2025年中国人工智能核心产业规模已超过1.2万亿元人民币,并保持约40%的年增长率,人工智能产业基础层包括AI芯片、传感器、计算算力平台等内容,技术层包括机器学习/知识图谱、智能问答/虚拟助手、自然语言处理、云平台/大数据服务、计算机视觉、生物特征识别等内容,应用层包括AI+工业、AI+交通、AI+医疗等场景。
一、产业应用
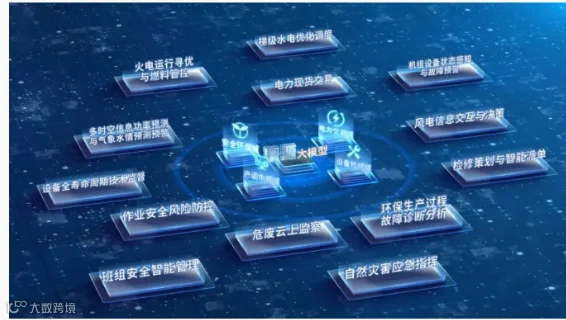
人工智能行业发展如火如荼,并逐步向实体经济渗透,参与、改变各行各业运营流程及管理规则,人工智能大模型已在能源化工、有色金属、航空航天、遥感测绘、电信运营、交通运输、工程管理、生物医药、现代农业等领域落地生根,并实现产业化应用,如国能擎源大模型、中科院磐石大模型,企业端已在营销推广、研发设计、工艺仿真、智能制造、智能财务、数字员工等方面扩大应用。
二、业态类型
人工智能赛道的业态表现为大模型、智能体等项目类型,
1.大模型
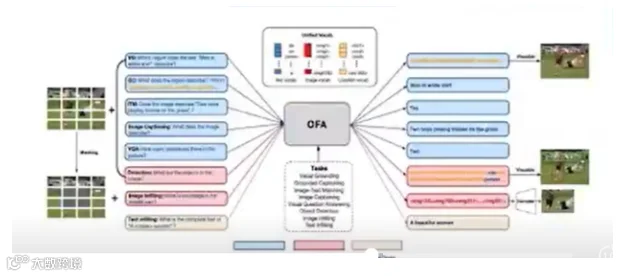
人工智能大模型是指由人工神经网络构建的一类具有大量参数的人工智能模型,大模型根据业务数据总结业务运作流程及最佳经验做法,为业务操作提供参考依据,并对业务安全风险进行预警,提升项目运营智能化程度,人工智能大模型主要类别包括大语言模型、视觉大模型、多模态大模型以及基础科学大模型等类型。阿里达摩院OFA大模型是多任务、多模态统一模型,具备架构统一、模态统一、任务统一的特点,
2.智能体
智能体是指能够感知环境并采取行动以实现特定目标的代理体,它可以是软件、硬件或一个系统,具备自主性、适应性和交互能力,智能体通过感知环境中的变化,根据自身学习到的知识和算法进行判断和决策,进而执行动作以影响环境或达到预定的目标,如openclaw小龙虾AI智能体。
Ø操作Agent
火山引擎HiAgent工作站智能体包括数据智能体服务、创作Agent、客服Agent、安全运营Agent、联网问答Agent、内容审核Agent、内容洞察Agent等智能体操作功能。
Ø复杂流程Agent
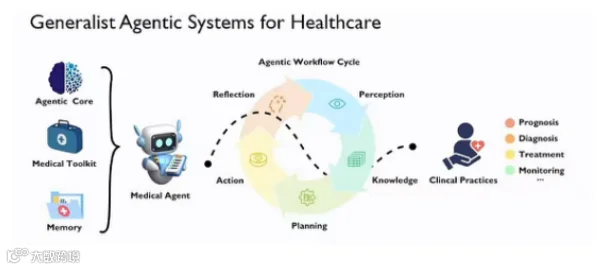
医疗康护领域智能体可进行分析工具尝试、归因模型推理、行动条款决策、实证展示等智能操作。
Ø多智能体协作
多智能体系统是由多个具有一定自主能力的智能体组成的系统,这些智能体可以是机器人、无人机、软件代理等,每个智能体都能独立地感知环境、规划行动并与其它智能体进行通信和协作。智能蜂群中的无人机可以通过无线通信进行实时数据交换,实现多机编队、协同作战、任务分配等功能。多智能体协作核心是agent能力发现与任务闭环,需要建立新型运作架构,如阿里面向Multi-Agent的事件驱动架构。
三、实施措施
人工智能赛道创新项目通过机器学习、推理预测等实施措施完成。
机器学习是一种通过算法和模型使计算机从数据中自动学习并进行预测或决策的技术,其核心目标是让计算机在没有明确编程指令的情况下,通过对大量数据的分析,识别模式和规律,从而构建适应新数据的模型。机器学习包括监督学习、无监督学习和强化学习等不同类型,广泛应用于图像识别、自然语言处理、推荐系统和自动驾驶等领域,具备自适应、自动化和泛化能力,是数据驱动的技术创新。新材料开发领域机器学习可通过量化分析发现新材料产品开发中的缺陷问题,通过敏感性预测完成新产品开发,如机器学习辅助增材专用镍基高温合金设计。
大模型推理是AI应用落地的关键瓶颈,一个70B参数模型每生成一个token需要数百GFLOPS的计算,在真实业务场景中意味着毫秒级的延迟和数十美元每百万token的成本,推理效率是决定大模型能否大规模商业化的核心变量,大模型推理加速的核心方向包括KV Cache优化、推测解码、模型量化、推理框架生态以及MoE推理等。
赤兔Chitu是一个面向大语言模型LLM的高性能推理框架,核心目标是高效率、灵活性与可用性,适配多种硬件平台并支持生产级部署,它不仅支持 NVIDIA GPU,还针对华为昇腾、沐曦、海光等国产芯片进行了深度优化,可在 CPU、单卡GPU、集群等多种环境下运行,具备多元算力适配、全场景可伸缩、长期稳定运行、多模型支持等优点。
多Token预测(MTP)是多Token推理与生成技术的一种主要技术路线,旨在提升大语言模型的生成效率。与之并列的另一主流技术路线为推测式解码,MTP技术通过修改模型的训练目标,使其具备同时预测多个未来词元的能力。
四、基础设施
AI基础设施指支撑AI模型训练、推理与部署的全栈基础设施,包括算力芯片、高速网络、分布式存储、训练框架、推理引擎与调度系统,是大模型时代的计算底座,通过软硬件协同解决算力、通信、存储与部署效率问题,使大规模模型得以稳定、高效运行。
人工智能需要通过架构创新提升智能化程度,如DeepSeek的混合专家结构,以更小的参数量实现多模态深度交互,机器学习、大模型训练、推理决策等AI活动的新型架构如下:
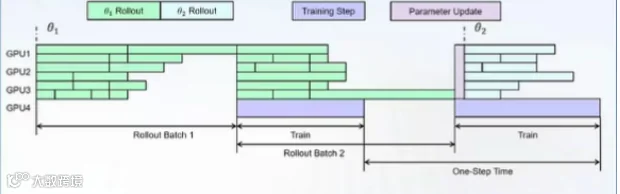
智能时代需要面向智能体的全异步强化学习框架,实现原生全异步强化学习支持,在推理中断时实现参数更新,在并行训练中完成整体迭代任务。
Rlinf是首个为具身智能而生的大规模强化学习框架,学习框架包括用户层、任务层、执行层、调度层、通信层、硬件层6部分,具身场景系统效率提升120%,具身视觉语言动作模型VLA涨幅40%—60%。
SpecForge是由SGLang团队开发的开源框架,专注于训练和优化超大语言模型(LLM)的投机采样技术,它与SGLang推理引擎深度集成,旨在显著提升模型推理效率,同时保持结果的质量和准确性。
vLLM是由UC Berkeley团队开源的一个大模型推理框架,它的目标是让大语言模型(LLM)在推理时更高效,特别是在高并发、多请求、长上下文等场景下关键技术包括虚拟化KV cache、动态批处理机制、前缀请求共享KV cache等。
大模型参数是训练推理的基础,数据管理是基础设施的源头,数据管理包括场景数据集、向量数据库等方面。
RoboCOIN数据集为双手操作提供了一个多实施例基准,集成了15个机器人平台、180K+演示、421个任务和16个场景,三层结构化标注(轨迹层、片断层、帧层)实现了从高级全局概念到低级控制的多分辨率学习。
向量数据库是一种专门用于存储、索引和检索高维向量数据的数据库系统,核心功能是支持语义相似性搜索和高效管理非结构化数据。核心功能包括向量存储、索引与检索、语义搜索、多模态支持等方面,技术特点包括高维向量索引、分布式存储与压缩、嵌入模型兼容等。
有效集群算力影响因素有互联规模、互联效率及单卡算力,算力网络需求为更大规模更广链接、光电融合,因此需要千卡互联、万卡互联,通过超节点规划实现从网络局部优化走向整体架构重构,从DC内/DC间向广域网扩展。