


不同于传统大模型“先写一段长篇大论再给结论”的慢节奏,Xing-VL2.0-Decision 的核心亮点在于“看图直接做决定、不仅判得快还能给出把握度”——平均单次判断仅需 0.3 秒,每小时即可完成超一万份复杂票据核验或抓拍画面判读,同时还能同步给出判断的“把握度”(方便业务系统对高把握结果自动放行、低把握结果转人工复核)。该模型广泛适用于内容安全审核、工业与交通视觉巡检、智能体(手机/网页)自动操作、票据文档信息抽取等需要“秒级响应、海量处理、人机协同兜底”的高频真实业务场景。
|
|
|
|
|
|
|
|
|
|
综合得分居首,无明显单项短板
2026 年 9 月,TypeSafe AI 推出的 Jev 将“决策模型”推向行业热潮:不写长篇分析,直接基于画面做判断、选动作,主打“又快又省”。OpenAI 也于 10 月 22 日正式上线 Decisions API,打响了模型“下一步该做什么”的行动判断入口争夺战。AI 从“能聊天回答”走向“能拍板决策”,已成为大模型迈向产业落地的全新风口。
Decision Index 榜是当前专门评测多模态决策模型的全球权威榜单,发布不到三周,已有全球 55 款模型同台竞技,参与者涵盖 Perplexity 与 vLLM Semantic Router等国际知名AI团队。该榜单的含金量主要体现在三点:
全真场景考题
涵盖近 1.4 万道真实多模态题目(空间感知、实景问答、网页操作、图表抽取与内容审核等),专门考核“看懂画面后当场拿主意”的实战能力;
盲测严防刷分
综合成绩由公开集与从未公开的私有盲测集各占 50%(11 项基准中有 9 项含私有盲测集),有效避免了提前背题或针对性刷分;
全球高手同台
汇聚了海内外主流大模型与专业多模态大模型决策团队,排名全凭硬实力。
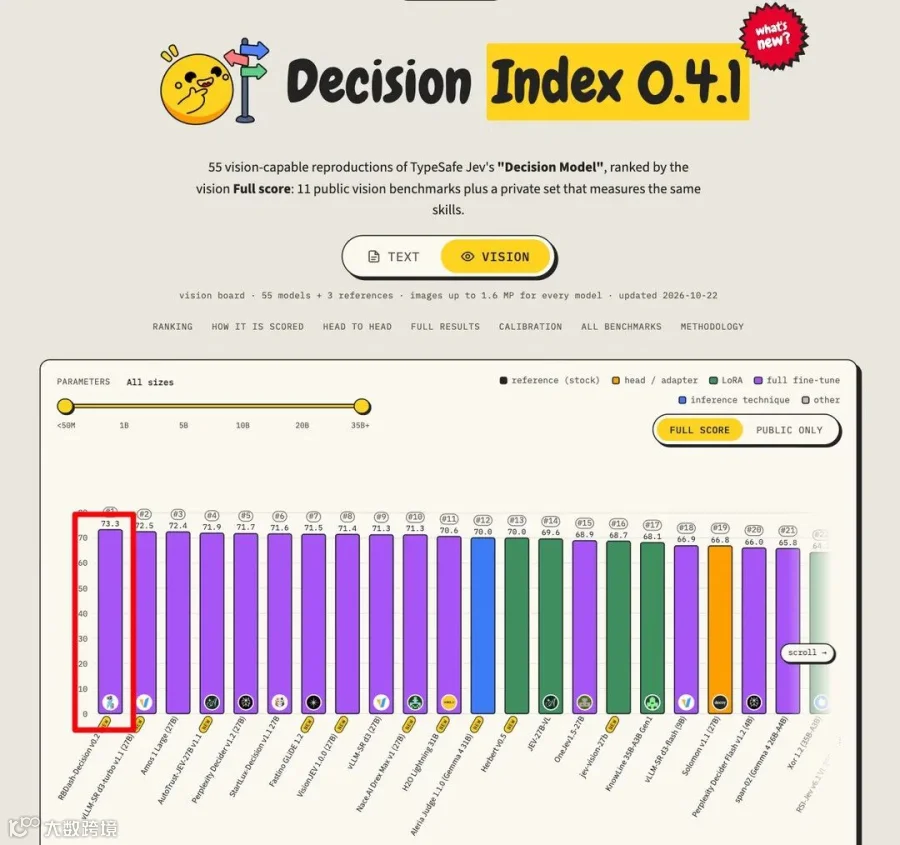
在这场盲测较量中,中国电信星辰实验室研发的 Xing-VL2.0-Decision(由于榜单直接抓取社区仓库名,榜单页面显示为其仓库代号RBDash-Decision-v0.2)以 73.3 分夺得综合第一。
榜单前五名
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
除了总分领先,Xing-VL2.0-Decision 在各分项考核中的表现也较为均衡:在全部 11 项评测基准中,Winoground 斩获单项第一(91.0 分,私有集达 95.0 分),并在感知谜题 BLINK、实景问答 RealWorldQA、网页操作决策 Mind2Web 三个单项中位列全球第二,整体无明显单项短板,展现出扎实全面的综合底子。

完整评测结果已公开:
榜单地址:https://multimodalart-jev-decision-index.static.hf.space/index.html?mode=vision
三类代表性考题拆解:全方位考验多模态决策能力
仅靠分数难以直观理解模型能力,下文选取三项代表性评测任务,展示多模态决策模型的具体考核形式。
任务一 词序陷阱(Winoground,单项第 1,91.0 分)

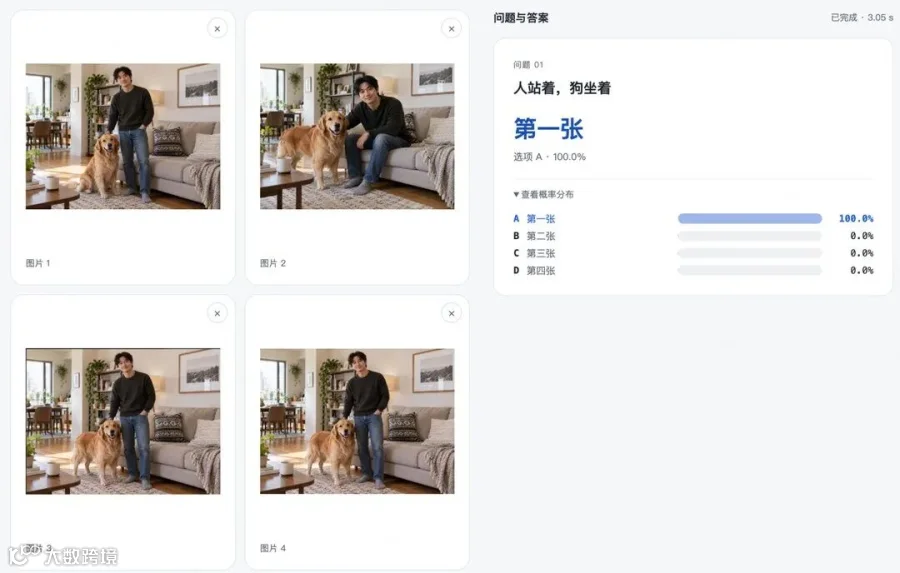
两张图、两句话,用词完全一致但语序不同:A. “人坐着,狗站着”;B. “人站着,狗坐着”。题目要求判断哪句话对应哪张图,仅靠识别画面里有“人”和“狗”无法做对,必须真正看懂画面中的动作关系。该项得分 91.0(私有集 95.0)。
任务二 真实路况判读(RealWorldQA,单项第 2,61.3 分)
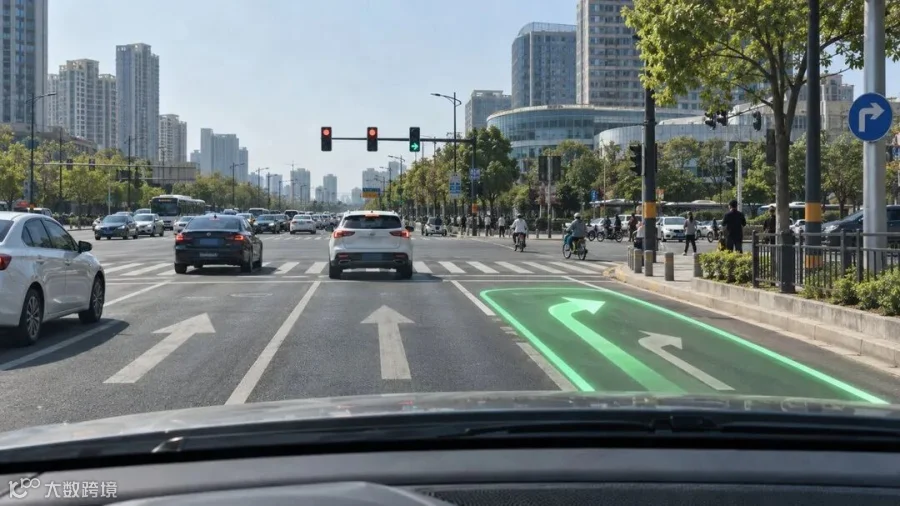
给定一段行车记录仪实拍的路口画面,判断右转时应走哪条车道。此类题型直接取自真实道路抓拍,没有固定套路,要求模型将复杂的视觉路况直接转化为可执行的驾驶判断。
任务三 网页操作决策(Mind2Web,单项第 2,80.2 分)

给定真实网站的截图与任务(如“预订一张去丹佛的单程机票”),在页面的四个候选按钮中选出下一步该点哪里。中间任何一步点错都会导致任务失败,直接对应智能体(Agent)帮人自动操作软件时的每一步抉择。
此外,榜单其余题型还涵盖了科学图表比对(CharXiv)、信息图问答(InfographicVQA)、票据含税总价抽取(KIE,取得 89.6 分)、内容安全审核(单项第 4)等丰富实用场景。
决策即概率:一步到位,有几分把握说几分话
面对业务中的视觉判断需求,Xing-VL2.0-Decision 摒弃了传统大模型“一个字一个字往外蹦”的生成方式,而是一步到位,直接算出各个候选动作的可能性(概率得分)。
以交通违章抓拍场景为例,系统预设结果为「压线、未压线、无法判定」三种。传统大模型往往要先生成一段分析文字再给结论,不仅耗时长,而且企业很难知道模型到底有几成把握,面临“全盘照单全收怕出错、全部人工复核太费人”的两难。相比之下,Xing-VL2.0-Decision 可以在一次计算中直接给出清晰的概率打分(单次最多支持 255 个选项同时比对):
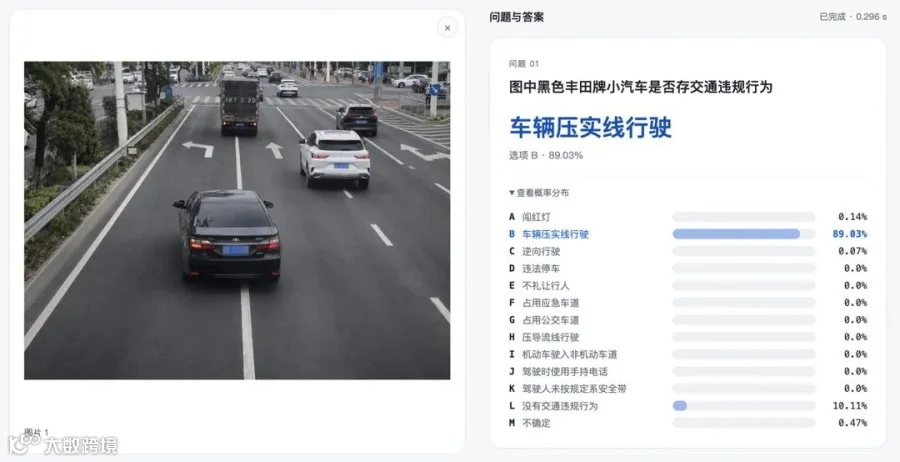
有了这组直观的数字,业务系统才能真正顺畅运转:把握大的自动放行,把握小的转交人工,安全门槛定多高,业务方自己说了算。
那模型给出的“把握度”靠谱吗?这也是落地中最关键的指标。在全部 13,695 道评测题上,模型的校准误差(ECE)低至 0.0298——通俗来说就是:它表示有八成把握的时候,实际准确率就真在八成左右(评测中模型平均给出 83% 的把握度,实际做对比例为 81%,基本做到了“心口合一”)。
在审核、巡检这类容错率敏感的业务里,一个“有几分把握说几分话”的模型,远比一个“每次都自信满满、偶尔却在胡说”的模型更有实用价值。
实机演示:把“秒级决策”和“把握度”摆在眼前
榜单分数证明的是模型在静态评测集上的“答得对”,而真实业务场景还进一步要求“跟得上”和“说得清”。
为此,团队用 Xing-VL2.0-Decision 搭建了三个实时决策演示。在整个演示过程中,模型全程只输入屏幕画面,不读取游戏底层状态或应用内部数据,每一步都直接看屏幕画面、当场拿主意,并把各个候选选项的概率实时标在画面上。
演示一 跑酷游戏:反应要快
跑酷游戏里障碍接连出现,留给判断的时间只有一瞬间。模型每一帧根据当前捕获的屏幕画面,在「跳跃、下滑、继续前进」等动作中实时给出概率打分并立即驱动执行,单步决策耗时约200毫秒。传统生成式大模型往往先写一段分析再给答案,等它想好,角色早已撞上障碍。这个极速响应场景,直接对应的是产线质检瑕疵剔除、交通路口抓拍这类“即拍即判”的毫秒级实时工业流水线。
演示二 网页订票:每一步都不能错
用户只给了一句话:“查看未来一周内北京到上海最便宜的机票,带宝宝。”模型面对的是一个真实布局的机票预订网页,系统把当前可操作的元素用 A、B、C 等字母框标在截图上,模型看图后从候选动作里选出下一步。
整个任务共 7 步:选择单程、点开目的地、选定上海、点开出发日期、选出最便宜的日期、勾选乘客类型、点击搜索,最终跳转到符合条件的航班列表。每一步模型都在 0.2 秒内(159~190 毫秒)给出决策,7 步全部正确,从打开页面到出结果全程约 21 秒。其中两步最考验“看懂”而不是“认出”:
选日期
日历上未来 7 天各标着一个价格 (¥390、¥460、¥430、¥450、¥300、¥480、¥440) ,模型需要读出画面上的数字并 比出最低价 ,最终选中 10 月 30 日的 ¥300;
选乘客
用户说的是“带宝宝”,页面上只有“带儿童”和“带婴儿”两个选项,模型准确对应到“带婴儿”。
这正是 Mind2Web 考题的实战版:从“单张截图选一个按钮”变成了长流程连续任务,中间任何一步点错(选错日期、漏选乘客类型),整个任务就会失败。模型每一步还会给出把握度,例如点开目的地这一步,“目的地选择框”的概率为 0.99;遇到把握度偏低的步骤,系统就可以停下来请用户确认,而不是硬着头皮点下去。放到办公系统填报、电商下单、政务网办等场景,就是“大模型理解需求、决策模型逐步执行”的低成本智能体方案。
演示三 聊天助手:读懂“话外之音”
模型根据即时通信界面中的对话进展,单次计算同时给出三组概率:对方此刻的情绪倾向、我方合适的回复引导方向,以及表情矩阵中最合适发送的表情(推荐的表情会在界面上高亮框出)。面对一句“呵呵,挺好的”,字面上是积极称赞,模型却能准确读出字面背后的不满情绪。这直观展现了第 03 章里的关键能力:一次前向计算就同时比对几十个选项,而且每个选项都带着客观可信的把握度打分。放到智能客服、数字营销等场景里,就是对客户心理状态的实时判断与金牌话术精准推荐。
三个演示的共同点是:模型完全不写长篇大论的推理文本,而是一步到位算出各个离散选项的概率分布。速度足够快,能跟上实时画面流转;把握度又足够客观可信,让系统明确知道什么时候该自己做主、什么时候该平滑交给人。
赋能业务:算得省、跟得上、兜得住
在实际产业落地中,技术指标最终都要转化为实实在在的业务账本。Xing-VL2.0-Decision 在真实场景中的落地价值主要体现在三个方面:
算力成本大幅降低,普通硬件也能跑得起
在交通卡口过车判读、海量票据核验、图文实时审核、自动化软件操作等场景中,每天的业务调用量动辄成百上千万次。如果用传统生成式大模型逐字输出,高昂的显卡算力账单往往让企业望而却步。Xing-VL2.0-Decision 省去了多余的文字生成过程,实测在单张显卡上,不到 2 小时即可完成约 1.4 万份复杂票据抽取、路面抓拍判读或图文合规审核任务(单卡日均处理能力可达近 20 万次)。这意味着企业无需堆砌昂贵的算力集群,依靠常规服务器甚至边缘端设备就能支撑日常海量业务,真正做到“用得起、铺得开”。
0.3 秒极速响应,无缝接入实时流水线
在工业质检传送带、高速路口违章抓拍、智能体连续点击屏幕等现场环境中,业务流转往往以毫秒或秒计,动辄需要等待好几秒的传统大模型很难直接接入产线。Xing-VL2.0-Decision 平均单次判断耗时仅 0.3 秒左右,能够通过标准接口或本地轻量部署直接嵌入现有业务系统,实现“即拍即判、随流随转”,顺畅满足生产一线的节奏要求。
人机协同精准兜底,兼顾效率与安全
企业引入 AI 决策最担心“出错没人管”。依托可靠的把握度评估能力,Xing-VL2.0-Decision 能帮企业搭建一套省心的人机协同流程:企业可以根据自身风控要求设定分数线,让把握度高的常规案例自动秒级过审,只把极少数“模型拿不准”的疑难复杂案例精准挑出来交给人工复核。这样一来,既能帮业务团队节省 初审人力,又能稳稳守住业务安全的底线。
赛道格局:从技术兴起走向产业落地
大模型智能体(Agent)要真正走进产业、解决实际问题,核心不仅在于聊天对话,更在于业务流程中每一次高频、准确的执行决断:调不调工具、点哪个按钮、放不放行、图文合不合规。将这类高频、选项明确的判断任务从庞大的通用大模型中拆分出来,交给像 Xing-VL2.0-Decision 这样的专用决策模型去高效执行,形成“通用模型做复杂规划、专用决策模型做高频执行”的分工配合,正成为业内加速 AI 落地的务实路径。
Xing-VL2.0-Decision 登顶 Decision Index 榜,是星辰大模型在多模态决策落地方向上的一次扎实突破。接下来,中国电信星辰通用人工智能实验室将继续围绕更快、更稳、更贴合产业需求的决策能力持续迭代,让多模态 AI 真正扎根一线业务、服务千行百业。