

2025 年 5 月 30 日,悉尼科技大学、华盛顿大学、伊利诺伊大学厄巴纳—香槟分校和浙江大学的研究者在 arXiv 发布论文 Improving Protein Sequence Design through Designability Preference Optimization,提出残基级可设计性偏好优化方法 ResiDPO,并用它微调 LigandMPNN,得到蛋白质序列设计模型 EnhancedMPNN。

在前几天介绍的 Baker 组的新发的 Nature 的文章中,看到作者用到了这个工具,今天查了一下也是 Baker 组做的,在这里就解读一下。
作者主要解决一个具体问题:给定一个设计好的蛋白质骨架,怎样让模型生成的序列更容易折叠成预期结构?
现有序列设计模型通常学习恢复天然蛋白质的原始序列。但在从头设计中,更直接的目标是找到能够形成目标结构的序列。作者把 AlphaFold2 的结构预测反馈加入训练,让模型学习哪些序列更符合这一目标,并把反馈细化到每一个残基位置。
论文得到几项主要结果。
tips:ResiDPO 是 Residue-level Designability Preference Optimization 的缩写,中文可译为“残基级可设计性偏好优化”。
核心方法 把整条序列的好坏,拆解到具体残基位置
常见的设计流程是先生成蛋白质骨架,再由序列设计模型为骨架分配氨基酸,最后用结构预测模型检查生成序列能否形成目标结构。大量候选会在最后一步被筛掉。
作者希望把这一轮筛选提供的信息提前用于训练。基本过程包含三步。
这种训练方式借鉴了直接偏好优化,也就是 DPO。它利用两个候选之间的优劣关系调整模型,不需要为每个骨架指定唯一的正确序列。
但整条序列的平均分会掩盖局部差异。一条序列总体得分更高,并不意味着它的每个位置都更好。如果把整条高分序列一起奖励,一些表现变差的位置也可能被一并强化。
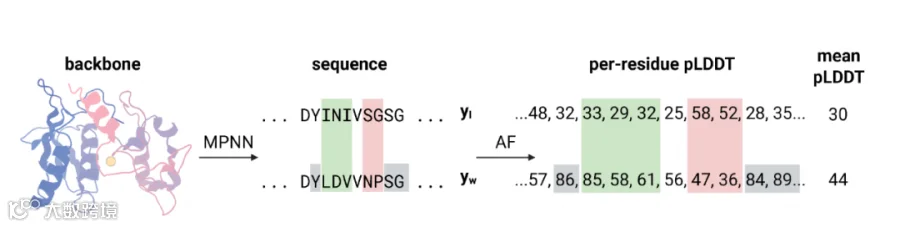
ResiDPO 将训练拆成两部分。
第一部分是残基级偏好学习。 比较两条序列在对应位置的 pLDDT,只在优选序列局部评分高出超过 10 分的位置上,强化对优选残基的相对偏好。
第二部分是残基级约束学习。 对优选序列中 pLDDT 高于 80、且原模型赋予该氨基酸的概率高于 0.5 的位置,约束微调后的预测不要过度偏离原模型。
这样,局部改善明显的位置提供学习信号,已经可靠的位置帮助保留原有结构知识。两部分共同作用,形成 EnhancedMPNN 的训练目标。
tips:简单理解就是用将af2的模型学习到的一些结构规则通过这种方式传递到mpnn模型中,让mpnn生成的序列更符合af2的”口味“。
数据准备 用结构预测建立逐残基反馈数据集
作者从蛋白质结构数据库中筛选单体结构,要求来自分辨率优于 3.5 Å 的 X 射线晶体学测定,蛋白质长度小于一千个残基,构建名为 PDB-D 的数据集。
数据划分同时考虑发布时间和结构相似性。2021 年 9 月 30 日之后发布的结构被指定用于验证;经过结构聚类后,包含这些结构的簇也划入验证部分,其余簇用于训练。
最终得到 19,203 个训练结构和 1,690 个验证代表结构。作者对每个结构生成八条序列,采样温度设为 1.0,以增加序列多样性,再运行 AlphaFold2,获得逐残基评分。
配对时,作者比较了三种策略:选择最高分序列与其他序列配对;只选择高于 80 分与低于 75 分的序列配对;或者使用任意两条评分差超过阈值的序列。
第三种策略表现最好。它能够利用更多骨架上的相对改善,即使某个骨架暂时还没有产生高于 80 分的序列,也可以为训练提供有效样本。后续实验采用 10 分作为配对阈值。
结果一 酶设计通过率提高,更多骨架找到可用序列
作者使用五类酶的催化位点作为起点,通过 RFdiffusion2 为每类酶生成一千个骨架,再由各个序列设计模型为每个骨架生成八条序列。催化残基保持固定,序列采样温度设为 0.1。
这一测试关注结构匹配:AlphaFold2 预测的 pLDDT 高于 80,且预测结构与目标骨架的 Cα 均方根偏差小于 1.5 Å,即记为通过。
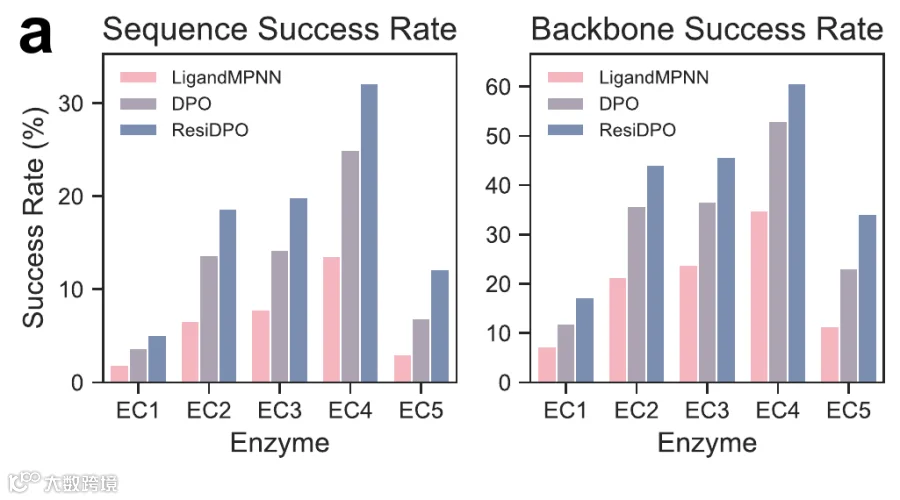
五类酶的设计结果。左侧统计通过筛选的序列比例;右侧统计每个骨架生成八条序列后,至少有一条通过的骨架比例。粉色、紫色和蓝色分别代表原始 LigandMPNN、普通 DPO 微调模型和 ResiDPO 微调模型。
EnhancedMPNN 的平均序列通过率达到 17.57%,原始 LigandMPNN 为 6.56%,五类酶上均有改善。
骨架层面的变化同样明显:至少获得一条通过序列的骨架比例,从 19.74% 提高到 40.34%。在相同的八次采样机会下,新模型让更多骨架找到了符合结构要求的序列。
这给设计流程带来一个直接启发:一个骨架暂时没有筛出合适序列时,改进序列设计模型本身,也可能提高这个骨架的利用率。
结果二 单体结构上学到的偏好,也能改善结合物设计
训练数据以单体蛋白质为主,作者进一步检验模型能否用于蛋白质结合物设计。
测试包含 PD-L1、白细胞介素 7 受体 α 亚基、胰岛素受体、TrkA 受体和流感血凝素五个靶标。每个靶标使用一百个生成骨架,每个骨架设计八条序列,并固定靶标链。
通过标准同时涉及结合物自身和复合物构象:pLDDT 高于 80,链间预测对齐误差小于 10,整体 Cα 均方根偏差小于 1 Å。
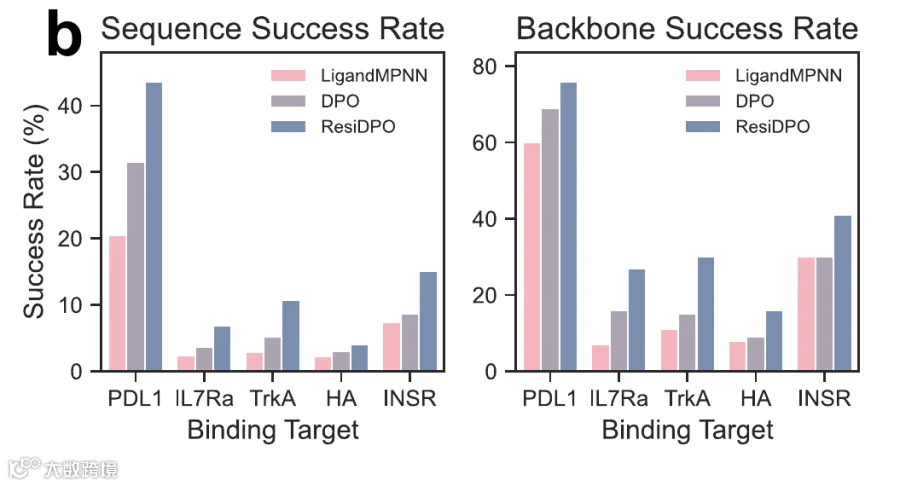
五个蛋白质靶标的结合物设计结果。左侧为序列通过率,右侧为骨架通过率。不同靶标的基础难度不同,ResiDPO 微调模型在五个靶标上均取得提升。
|
|
|
|---|---|
|
|
|
|
|
|
|
|
16.07% |
普通 DPO 已经带来改善,逐残基优化进一步扩大了收益。这说明在单体结构上学到的序列偏好,也能帮助模型生成更符合目标复合物构象的候选。
作者还展示了两个结构案例,分别对应酶的催化口袋和结合物与靶标的相对位置。

a、b:预测结构与设计骨架的叠合。a 为酶设计案例,蓝色的 ResiDPO 预测结构更贴近灰色目标骨架,催化口袋附近的构象也更吻合;b 为结合物案例,蓝色结构更好地保持了与橙色靶标的预期相对位置。粉色和紫色分别对应原始模型与普通 DPO 模型。
结果三 局部学习与知识保留共同起作用,小数据量下也有收益
作者用消融实验比较了普通 DPO、单独的残基级偏好学习,以及完整的 ResiDPO。
这里使用两个指标:天然序列恢复率,以及论文定义的 pLDDT 偏好准确率。后者用于评价模型是否更倾向于给高 pLDDT 的验证序列更高概率,便于在不反复运行结构预测的情况下比较训练方案。
|
|
|
|
|---|---|---|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
55.56% | 66.08% |
只加入局部偏好学习时,模型对高分序列的偏好增强,但天然序列恢复率下降较多。补上残基级约束后,恢复率回升,偏好准确率也进一步提高。保留可靠位置的原有知识,有助于局部学习取得更好的整体效果。
作者随后减少训练骨架数量,比较两种方法的数据利用效率。
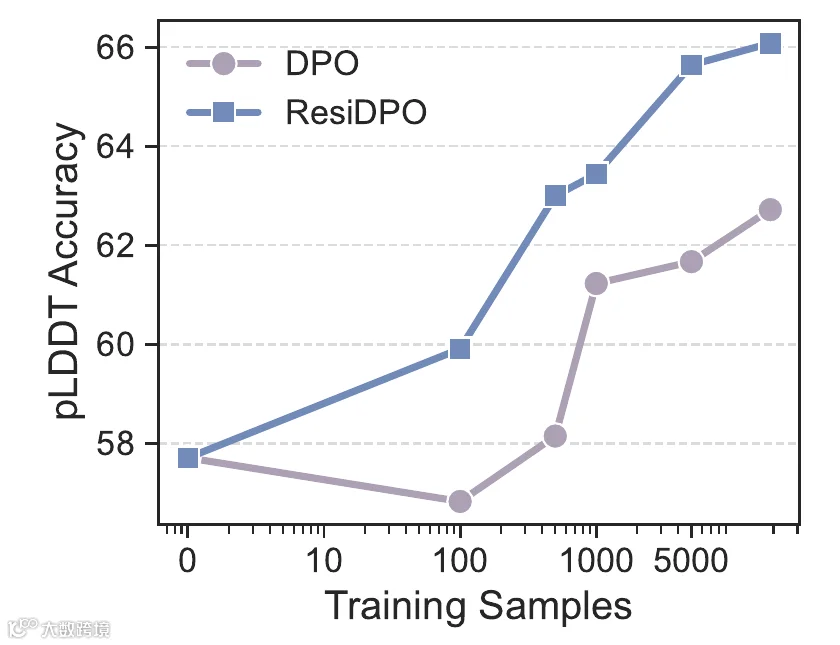
不同训练骨架数量下的偏好准确率。横轴为抽取的训练骨架数,纵轴为 pLDDT 偏好准确率;蓝色为 ResiDPO,紫色为普通 DPO。
只使用一百个骨架时,普通 DPO 的表现有所下降,ResiDPO 已经能够获得改善。抽取一千个骨架时,ResiDPO 达到约 63.44% 的偏好准确率,与使用约一万九千个骨架的普通 DPO 处于相近水平。
在这一千个骨架中,实际只有 502 个满足评分差超过 10 分的配对条件。逐残基反馈让有限的训练样本提供了更具体的优化信息。
结果四 优化结构置信度后,氨基酸组成也随之改变
EnhancedMPNN 生成的序列发生了哪些变化?作者分别在天然骨架和新设计的酶骨架上比较了氨基酸组成。
整体上,微调后的模型增加了谷氨酸、赖氨酸和精氨酸等带电残基的使用,并减少了部分丙氨酸。在设计骨架上,丙氨酸减少、谷氨酸增加的趋势尤其明显。

不同模型生成序列的氨基酸组成。左侧为天然骨架,右侧为新设计的酶骨架。粉色、紫色和蓝色分别对应原始模型、普通 DPO 和 ResiDPO。横轴采用氨基酸单字母代码,其中 A 为丙氨酸,E 为谷氨酸,K 为赖氨酸,R 为精氨酸。
作者提出,这些变化可能减少了序列与结构对应关系中的模糊性。带电残基通常更适合暴露在溶剂中,而丙氨酸既可位于内部,也可出现在表面,对局部环境的指示相对不明确。甘氨酸和脯氨酸具有更鲜明的构象特征,在残基替换分析中也较多地被保留下来。
这种解释将模型的训练目标与序列组成联系起来:围绕结构预测反馈进行优化,会改变模型选择氨基酸的方式。
总结
这项研究把序列设计与结构预测连接得更紧密。LigandMPNN 提供结构条件下的序列生成能力,AlphaFold2 提供逐残基反馈,ResiDPO 再将这些反馈分配给需要学习和需要保留的位置。
在酶和蛋白质结合物两类任务中,这一训练方式都提高了结构筛选通过率,也让更多骨架在有限次数的采样中获得合适序列。
对实际设计流程而言,EnhancedMPNN 的价值在于改善序列生成这一环,提高后续结构筛选获得候选的效率。接下来的实验表征,可以进一步检验这些候选在表达、折叠以及目标功能上的表现。
tips:感觉有点幻觉模型的味道,使用结构预测模型的结果微调了一下mpnn,让生成的序列更符合af2的规则一些。
参考论文
Xue F, Kubaney A, Guo Z, Min JK, Liu G, Yang Y, Baker D. Improving Protein Sequence Design through Designability Preference Optimization. arXiv:2506.00297v1. 2025 年 5 月 30 日。