

摘要
许多蛋白质的功能依赖多个构象,而现有多状态序列设计通常先对各个状态独立预测,再汇总输出。本文提出 DynamicMPNN,通过在构象集合上联合训练,直接生成兼容多个结构状态的氨基酸序列。研究构建了覆盖约 75% CATH 超家族的 CoDNaS 多构象数据,并在 96 个具有较大构象变化的蛋白质上开展计算评估。与 ProteinMPNN 的多状态设计策略相比,DynamicMPNN 在可直接比较的 61 个样本上将诱饵归一化 RMSD 降低约 31%;最佳变体的序列恢复率由 38.0% 提高至 42.7%。模板引导 AlphaFold 3、无模板 AlphaFold 3 和 BioEmu 均支持显式多状态训练的收益,实际构象切换与功能仍有待实验验证。
论文信息
原文标题:Multi-state Protein Sequence Design with DynamicMPNN
会议:International Conference on Learning Representations
第一作者:Alex Abrudan;Sebastian Pujalte Ojeda
参与机构:University of Cambridge;Leipzig University;Ludwig-Maximilians-University Munich
01 多状态设计,要让同一条序列兼容不同结构
从酶催化、膜转运到变构调控,许多蛋白质需要在不同构象之间转换。这样的结构变化既可能是两个结构域之间的开合,也可能涉及二级结构和整体折叠方式的重排。设计目标因此变得更严格:同一条氨基酸序列需要同时满足多个构象的结构约束。
ProteinMPNN 已能通过多状态设计推理策略(ProteinMPNN-MSD)处理这一问题:对不同构象分别预测,在每个自回归步骤汇总各状态的 logits,再采样一个共同的氨基酸。作者指出,这类方法主要在输出端协调状态,其训练本身仍以单状态为基础。
DynamicMPNN 则把多状态约束纳入训练,直接学习“给定多个构象,哪条序列能够同时与它们兼容”。本文主要研究双状态设计,涵盖转运蛋白、发生结构域运动的铰链蛋白,以及能够改变折叠方式的折叠切换蛋白(metamorphic proteins)。

图 1|DynamicMPNN 的设计与评估框架。a,转运、折叠切换与铰链运动的双构象示例;b,多状态结构编码、序列生成,以及带目标模板和诱饵模板的 AF3 评估流程。
02 从结构数据库中整理可用于学习的构象对
多状态学习首先受限于数据。PDB 中存在大量单条蛋白质链结构,但可直接用于学习较大构象变化的集合相对有限。研究利用数据库中的序列冗余,将高度相似的蛋白质链整理为经过序列对齐的结构集合。
第一套数据来自 CoDNaS:以至少 95% 序列相似性聚类,并要求同一簇的成员对应同一 UniProt ID,得到 46,033 个结构簇,覆盖约 75% 的 CATH 超家族。每簇优先选取 Cα-RMSD 最大的一对结构,以增加训练中可见的构象差异。
第二套数据 PDB80 采用至少 80% 的序列相似性阈值,整理出 46,924 个含多个构象的簇。训练时依据结构差异加权采样,使不同轮次能够看到更多构象组合。较低的序列阈值扩大了数据多样性,也可能引入同源蛋白或由突变导致的折叠差异。

图 2|多构象数据的构建与 PDB80 分布。a,序列聚类、结构对齐与构象对选择;b,各簇最大 Cα-RMSD;c,各簇最小 TM-score;d,各簇构象数量。
研究将构象变化较大的 96 个蛋白质用于测试,另设 100 个验证样本,并依据结构与序列相似性剔除训练中的相关簇,最终得到 44,243 个 CoDNaS 训练构象对。作者还加入 27,394 个来自其他序列簇的单状态样本,以扩大折叠空间覆盖。
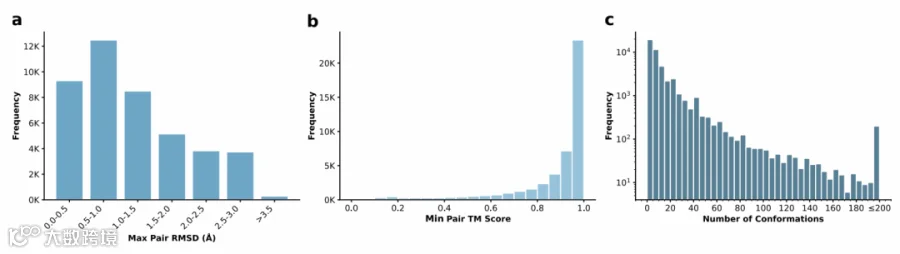
图 3|CoDNaS 数据集的构象差异与簇规模。a,各簇最大 Cα-RMSD;b,各簇最小 TM-score;c,各簇构象数量。
03 先联合结构表征,再生成共同序列
DynamicMPNN 的输入是一组构象及其蛋白质结合伙伴。模型先独立编码每个状态,再对待设计链的结构表征进行跨状态池化,最后由自回归解码器生成一条共同序列。其学习目标可写为 p(Y | X₁, …, Xₘ):序列 Y 的概率以整组构象为条件。
架构沿用 gRNAde 的多状态图神经网络思路,采用几何向量感知机(GVP)处理标量与三维向量特征。基础版本通过 Deep Set 平均池化整合状态,输出不依赖构象输入顺序;DSS 版本进一步在各编码层之间交换状态信息,但需要更多计算。
真实结构数据并不整齐:不同构象可能具有序列差异、缺失残基或对齐空位。模型先进行序列对齐,再独立构建各状态的结构图,对空位位置进行掩蔽,最后汇总可用的对应位点表征。多链版本还保留各状态的蛋白质相互作用环境,为学习由结合伙伴或寡聚状态伴随的构象变化提供上下文。
这里的输入是多个目标结构,而输出仍是一条序列。模型并不直接生成构象间的运动轨迹,也不直接预测状态占比或切换速率。
04 如何评估:检验序列与两种构象的兼容性
序列恢复率衡量设计序列与天然序列在对应位置上的一致程度,但同一种折叠可以由许多不同序列实现。因此,作者同时评估设计序列能否在结构预测中恢复目标构象。
多状态任务给结构预测带来额外困难:没有结构引导时,预测模型可能偏向一个主要状态。作者因此为同一条设计序列分别提供两个目标构象模板,运行 AlphaFold 3(AF3),再比较输出与相应目标的 Cα-RMSD、TM-score 和预测置信度 pLDDT。
为控制模板本身带来的偏向,研究加入与目标结构明显不同的诱饵模板,要求其与目标的 TM-score 小于 0.4。诱饵归一化 RMSD 等于“目标模板下的结构偏差”除以“诱饵模板下的结构偏差”。较低的比值表示序列对目标结构表现出更好的相对兼容性。
这一框架把评估重点放在已知目标构象的兼容性上。它提供的是计算代理证据,不能直接给出真实自由能差、构象布居或实验切换行为。研究另外加入无模板 AF3 与 BioEmu 构象集合采样,检查不同评估方式下的结果是否一致。
05 性能提升,首先来自多状态训练
在 96 个测试蛋白质上,混合单状态与多状态数据训练的模型(Combined Training)获得 41.0% 的序列恢复率;仅用单状态数据训练的同架构模型为 27.1%。进一步采用混合预训练与多状态微调,恢复率达到 42.7%,而 ProteinMPNN-MSD 为 38.0%。
从 38.0% 到 42.7%,对应提高 4.7 个百分点,相对提高约 12.4%。这一指标反映模型对天然序列约束的恢复程度,与结构兼容性评估相互补充。

图 4|不同模型变体的序列恢复率。多状态训练及微调模型总体优于仅接受单状态训练的模型,比较基于 96 个测试蛋白质。
结构指标也支持这一趋势。在完整测试集上,Combined Training 的模板引导 AF3 平均 RMSD 为 2.35 Å,仅单状态训练模型为 8.16 Å。与 ProteinMPNN-MSD 的直接比较则限于 61 个可完成相应评估的样本,原因是基线对空位和缺失残基的处理限制了部分序列进入 AF3。
在这 61 个样本上,Combined Training 的诱饵归一化 RMSD 为 0.129,ProteinMPNN-MSD 为 0.187,相对降低约 31%;原始 RMSD 则分别为 2.27 Å 和 3.31 Å。这一结果表明,在该计算评估下,多状态联合训练生成的序列与目标结构具有更好的相对兼容性。
作者还指出,ProteinMPNN 原训练数据在 30% 序列相似性聚类层面与 96 个测试蛋白质中的 91 个有关联。论文未在相同数据划分上重训 ProteinMPNN,因此,同架构单状态与多状态训练的对照,对判断训练策略收益尤其重要。
06 BioEmu 提供独立的构象集合评估
每个测试蛋白质由各模型设计 16 条序列。BioEmu 对每条序列采样 50 个结构,研究再分别寻找与两个目标状态最接近的样本。两个目标可以由集合中的不同样本恢复。
当成功标准设为“至少一条设计序列对两个目标状态的最佳 TM-score 均超过 0.7”时,Combined Training 的靶标级计算成功率为 37.5%,仅单状态训练为 17.7%。阈值提高至 0.8 时,两者分别为 22.9% 和 7.3%。这些比例描述的是规定采样预算下的双状态结构恢复。

图 5|BioEmu 采样数量与累计最大 TM-score 的关系。左为 Combined Training,右为 Single Training;结果在设计序列与测试靶标层面汇总,两图纵轴范围不同。
无模板 AF3 给出了另一个侧面的结果:Combined Training 在较难恢复状态上的 TM-score 为 0.69,模板引导时为 0.82;仅单状态训练的对应数值为 0.47 和 0.59。多状态训练的优势在两种条件下均存在,而模板引导有助于评价较难被自发预测到的目标状态。
BioEmu 与模板引导 AF3 的模型排序一致,但 BioEmu 的评估仅针对单链,无法纳入可能驱动构象变化的蛋白质结合伙伴。作者认为,这也限制了现有构象集合模型对多链设计的评价能力。
07 折叠切换获益明显,更多状态却未必更好
按蛋白质类别分析,DynamicMPNN 相对于 ProteinMPNN-MSD 的优势在折叠切换蛋白中最突出。这类蛋白质涉及二级结构和三级结构的共同重排,比单纯的结构域开合提出了更复杂的序列约束。
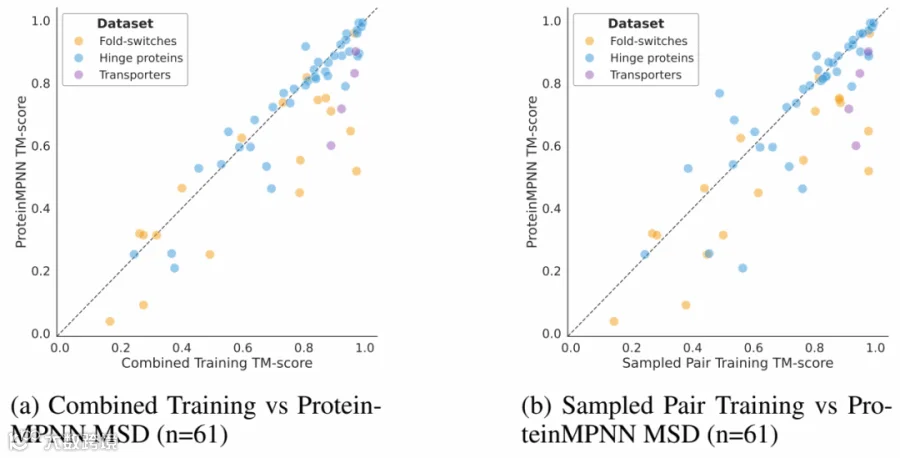
图 6|按蛋白质类别比较 AF3 结构恢复表现。a,Combined Training 与 ProteinMPNN-MSD;b,Sampled Pair Training 与 ProteinMPNN-MSD。黄色为折叠切换蛋白,蓝色为铰链蛋白,紫色为转运蛋白。

图 7|目标状态间结构相似性与模板引导 AF3 恢复结果的关系。a–f,依次为 ProteinMPNN-MSD、Combined Training、Combined Training + DSS、Sampled Pair Training + DSS、Sampled Pair Training 和 Single Training。
Arc 折叠切换蛋白提供了一个具体例子。原文展示的最佳设计中,DynamicMPNN 的预测结构能够恢复其中一个目标状态的 β 折叠特征,而 ProteinMPNN 的对应设计未能恢复该特征。这是结构预测案例,用于展示两种方法在不同目标折叠上的差别。
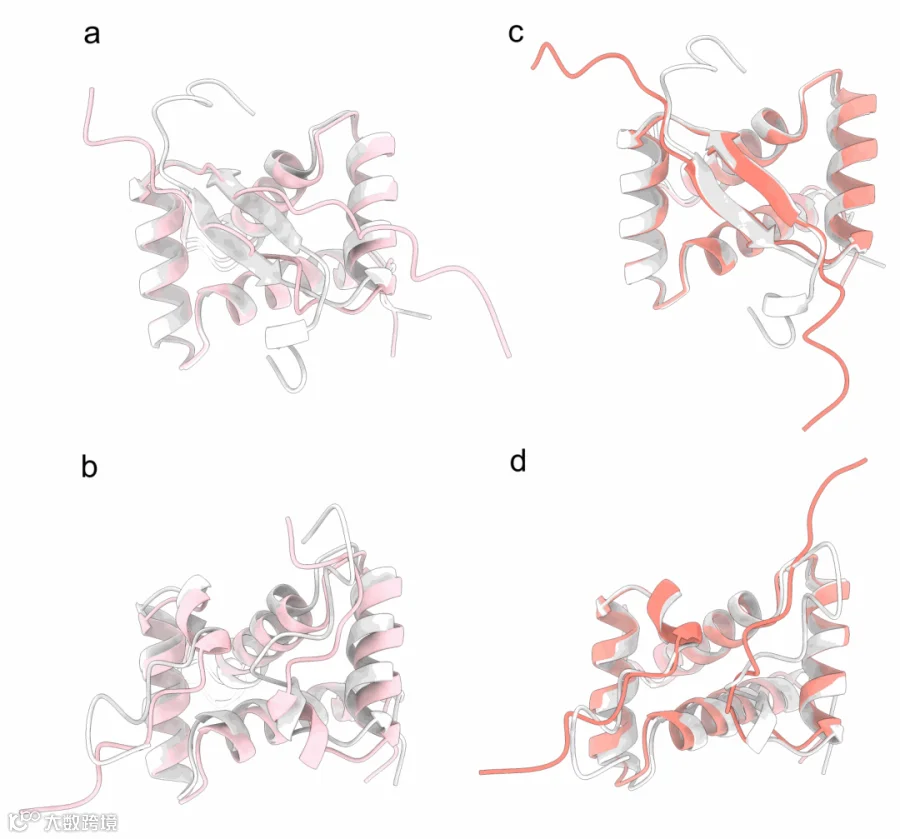
图 8|Arc 折叠切换蛋白案例。a、b,ProteinMPNN 最佳设计的预测结构;c、d,DynamicMPNN 最佳设计的预测结构。灰色为两个目标状态,分别对应 PDB 1BDT 与 1QTG。
模型架构能够接收更多状态,但增加输入状态并不总能改善结果。作者在少量三状态和五状态蛋白质上进行了单链模型探索:钙调蛋白的部分指标受益于更多状态;对另一些体系,额外构象没有带来稳定收益。DSS 的效果同样依赖具体体系。
这些补充测试每组仅含三个蛋白质。作者将结果与训练集中此类体系稀缺、不同构象信息更难协调等因素联系起来,并未据此宣称已普遍解决连续构象景观或无序蛋白质设计。
08 讨论与展望
作者的核心结论是:在构象集合上显式联合学习,能够帮助模型掌握兼容多个功能状态的序列约束。在模板引导 AF3、无模板 AF3 和 BioEmu 三种计算评估下,多状态训练均优于仅单状态训练,为这一训练方向提供了一致证据。
与此同时,结构数据中的构象分布高度不均衡,多数簇仅包含少数构象,低布居状态也难以充分覆盖。PDB80 扩大了多样性,却可能混入突变驱动的折叠差异;多于两个状态的验证仍局限于很小的样本范围。
作者提出,这一方法可能用于合成生物开关、变构调节蛋白和分子机器的工程设计。但目前仍不清楚,通用的多状态模型能否在实验中持续有效,还是需要针对不同构象变化类型及其热力学复杂性开发专门模型。实际序列的双状态存在、切换行为和功能,需要后续实验检验。
参考文献
[1] Abrudan A, Pujalte Ojeda S, Joshi C K, Greenig M, Engelberger F, Khmelinskaia A, Meiler J, Vendruscolo M, Knowles T P J. Multi-state Protein Sequence Design with DynamicMPNN. International Conference on Learning Representations, 2026.