

Hugging Face 的 Ben Burtenshaw、Sergio Paniego 和 merve 整理了这份 Agent 后训练学习指南。从监督微调到蒸馏、强化学习,再到真实环境与大规模训练,每一步都配有示意图、课程和代码入口。以下为全文翻译。
后训练,是指预训练之后的训练阶段,例如监督微调、蒸馏和强化学习。这些阶段让预训练模型学会遵循指令、使用工具,或解决特定任务。当模型作为 Agent 工作时,它需要经历多轮交互:调用工具、读取结果,再决定下一步做什么。Agent 后训练将这些训练方法用于 Agent,因此需要考虑整个多轮交互序列,而不只是一次回答。
在入门介绍之后,本文分为五个步骤。每一步都包含方法示意图、直播或幻灯片、讲解思路的博客文章,以及相关文档。部分步骤还提供了用该方法构建的示例项目。下面的表格汇总了各步骤中模型从什么信号学习、使用哪个 TRL 训练器,以及你需要准备什么。
这些步骤的顺序来自 Hugging Face YouTube 频道的 Training Agents 系列直播。每期介绍一种后训练方法,并始终以训练一个编程 Agent 为例。“Post-training Agents”播放列表收录了四期直播和两场相关工作坊。
步骤总览
|
|
|
|
|
|---|---|---|---|
|
|
|
SFTTrainer |
|
|
|
|
DistillationTrainer |
|
|
|
|
GRPOTrainer |
|
|
|
|
GRPOTrainer |
|
|
|
|
AsyncGRPOTrainer |
|
0. 开始之前
先了解后文会用到的术语,例如 agent、harness、scaffold,以及整条学习路线的概况。
-
阅读:《Harness、Scaffold 与值得弄清的 AI Agent 术语》。 -
总览幻灯片:《训练 Agent,而不只是模型》(Train the agent, not just the model),共 20 页,覆盖全部步骤。 -
如果你还不熟悉微调:先看 LLM Course。
1. 监督微调(SFT)
模型学习模仿 Agent 轨迹,也就是 Agent 解决任务的完整记录,其中包括每次工具调用及其结果。这些轨迹通常由更强的模型生成。这个方法成本低,也很稳定。
模型看到的只有正确轨迹,从未见过自己的尝试。因此,当它在解决任务时犯错,并没有学过该怎样从错误中恢复。在线策略蒸馏(on-policy distillation)和强化学习通过在模型自身的输出上训练,来解决这个问题。

SFT:模型读取通常来自更强模型的 Agent 轨迹;只对 Agent 回合计算下一 Token 预测损失,用户和工具回合仅作为上下文。
-
观看:Training Agents 第 1 课《微调一个编程 Agent》(附代码)。 -
阅读:《Training Agents 第 1 课:从零开始做 SFT》。 -
文档:SFT Trainer。
2. 蒸馏
教师模型指导学生模型,可以用自己生成的数据,也可以对学生生成的 Token 给出概率。教师通常是一个更大的模型,也可以是多个专家模型共同蒸馏出一个学生模型,例如 MOPD;如果是自蒸馏,教师还可以是获得了额外上下文的同一个模型。训练信号是密集的,每个 Token 都有一个值,因此所需样本比强化学习更少。
另一方面,学生的能力受限于教师知道什么,而且在线策略蒸馏在每一步训练中都需要运行教师模型。强化学习则用一个只检查结果的奖励信号来代替教师。

在线策略蒸馏:学生模型先生成 Token,教师逐 Token 给出概率作为训练信号,低概率 Token 会得到纠正。
-
观看:Training Agents 第 2 课《蒸馏》(附资源合集)。 -
阅读:《AI 蒸馏简史》;《2026 年的蒸馏进展(截至目前)》。 -
文档:Distillation Trainer。
3. 强化学习(RL)
在强化学习中,模型根据自身输出的评分来学习。它先写出答案,由奖励函数评分,再通过训练提高生成高分答案的概率。这样就不再需要教师模型,只要有一种检查答案的方法即可。
这一步使用的算法是 GRPO,即组相对策略优化(Group Relative Policy Optimization)。针对每个提示词,它会采样多个答案,逐一评分,再提高那些得分高于组内平均值的答案的生成概率。通过组内比较,模型可以知道哪些尝试更好,而不必另外训练一个模型来做这项估计。
它的信号比蒸馏更弱:整个答案只有一个分数,而不是每个 Token 都有一个值,因此模型需要大量尝试才能学会。如果只用一个简单的奖励函数,每份答案就是一轮输出,只评分一次。引入环境后,模型就能采取多次行动,并看到每次行动的结果。
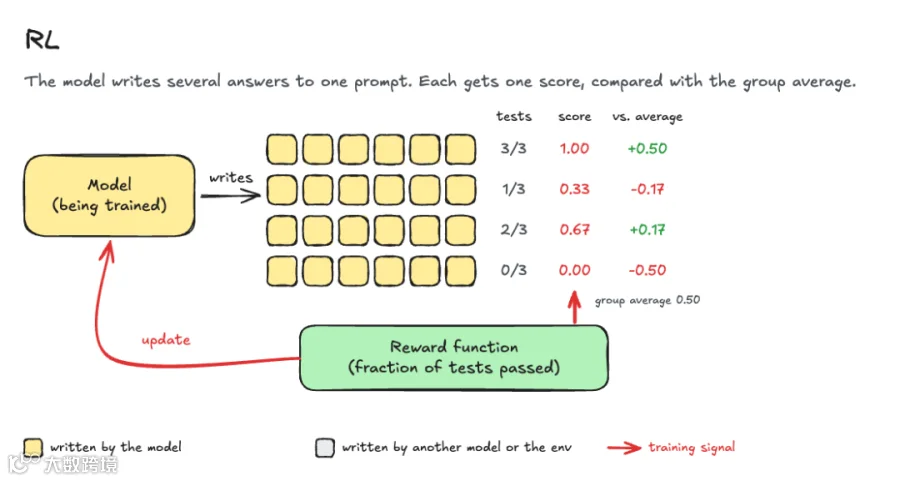
强化学习:针对同一提示词生成多个答案,按测试通过比例评分,再与组内平均值比较。
-
观看:Training Agents 第 3 课《强化学习》(附资源合集)。 -
阅读:《2026 年前沿模型如何根据结果进行训练》。 -
项目:《用 100 步 GRPO 微调一个 3.5 亿参数模型以生成结构化输出》。 -
文档:GRPO Trainer。
4. 强化学习环境
奖励来自模型在环境中的行动。环境会保留状态、提供工具,并在多轮交互中返回反馈。它负责运行工具、记录发生了哪些变化,并检查最终结果,例如运行编程任务的测试。
每个回合都比单次回答更长,因此生成运行轨迹(rollout)会成为训练中最慢的环节。
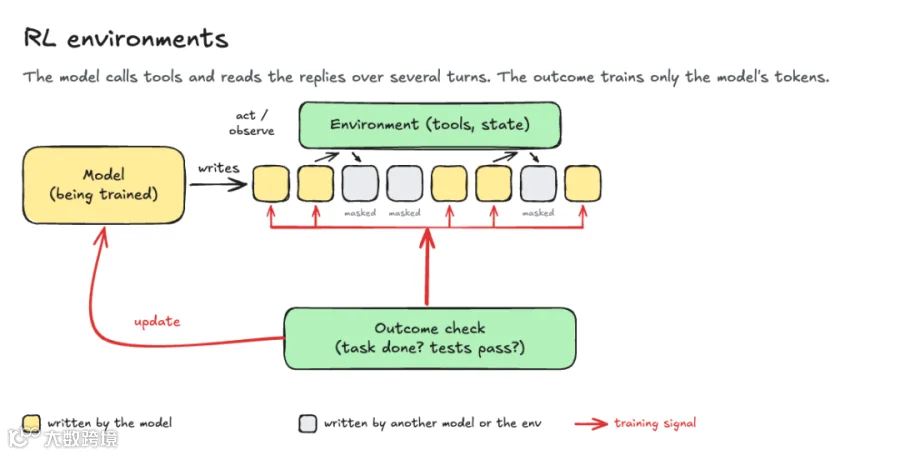
强化学习环境:模型多轮调用工具并读取反馈;结果用于训练模型自己生成的 Token,环境返回的 Token 被掩码屏蔽。
-
观看:Training Agents 第 4 课《从奖励函数到环境》(附资源合集);《Agent 强化学习工作坊》(RL for Agents Workshop)。 -
阅读:《为什么强化学习环境现在行得通,而在 2016 年不行》。 -
项目:用代码画水彩画;使用 CARLA 实现自动驾驶。 -
文档:TRL + OpenEnv;OpenEnv 文档。
5. Harness 与规模化
每条运行轨迹,都是 Agent 在远程沙箱中通过现有 harness 完成的一次完整运行。训练时使用与实际工作中相同的 harness,意味着模型是在未来真正运行的场景中学习。
生成与训练运行在不同的 GPU 上,因此漫长的交互回合不会让训练器闲置。随后,训练器再将更新后的权重发回 vLLM。

Harness 与规模化:远程沙箱运行真实 Agent,采集代理记录各轮模型调用;训练器接收会话和奖励,再向 vLLM 发回更新后的权重。
-
幻灯片:《通过一个并非自己编写的 Harness 训练编程 Agent》。 -
阅读:《多 Harness 强化学习终极指南》;《每条运行轨迹一个沙箱》;《让 Token 持续流动:从 16 个开源强化学习库中学到的经验》。 -
文档:Async GRPO Trainer;OpenEnv harnesses。
参考链接
-
原文:https://huggingface.co/blog/huggingface/train-agents -
Agent 后训练系列播放列表:https://www.youtube.com/playlist?list=PLo2EIpI_JMQvQZm-kVlz4wY1vWF0LBcf5 -
Harness、Scaffold 与值得弄清的 AI Agent 术语:https://huggingface.co/blog/agent-glossary -
训练 Agent 而不只是模型:总览幻灯片:https://huggingface.co/spaces/sergiopaniego/train-the-agent-slides -
Hugging Face LLM Course:https://huggingface.co/learn/llm-course -
Training Agents 第 1 课:微调一个编程 Agent:https://www.youtube.com/watch?v=rNgUoH7Wbv8 -
第 1 课代码:https://huggingface.co/burtenshaw/gemma4-pi-mono-youtube-livestream-1-scripts -
第 1 课:从零开始做 SFT:https://x.com/ben_burtenshaw/status/2067615361428545566 -
SFT Trainer 文档:https://huggingface.co/docs/trl/sft_trainer -
Training Agents 第 2 课:蒸馏:https://www.youtube.com/watch?v=GZT_oNQnLV4 -
第 2 课资源合集:https://huggingface.co/collections/sergiopaniego/training-agents-class-2-distillation-6a47a62b9f09867dccf61e1e -
AI 蒸馏简史:https://huggingface.co/blog/sergiopaniego/brief-history-of-distillation-in-ai -
2026 年的蒸馏进展:https://huggingface.co/blog/sergiopaniego/distillation-2026 -
Distillation Trainer 文档:https://huggingface.co/docs/trl/distillation_trainer -
Training Agents 第 3 课:强化学习:https://www.youtube.com/watch?v=ztdTed5egrM -
第 3 课资源合集:https://huggingface.co/collections/sergiopaniego/training-agents-class-3-reinforcement-learning-6ad6aa71050342629dd0e3ec -
2026 年前沿模型如何根据结果进行训练:https://huggingface.co/blog/sergiopaniego/agentic-rl-2026 -
用 100 步 GRPO 微调 3.5 亿参数模型以生成结构化输出:https://huggingface.co/blog/grpo-with-trl-ifstruct -
GRPO Trainer 文档:https://huggingface.co/docs/trl/grpo_trainer -
Training Agents 第 4 课:从奖励函数到环境:https://www.youtube.com/watch?v=nJV3yUuz6DU -
第 4 课资源合集:https://huggingface.co/collections/sergiopaniego/training-agents-class-4-rl-environments-6aa27543918888a0f2b5312c -
Agent 强化学习工作坊:https://www.youtube.com/watch?v=cixmqTsi2A4 -
为什么强化学习环境现在行得通而在 2016 年不行:https://huggingface.co/blog/sergiopaniego/rl-environments-story -
用代码画水彩画:https://huggingface.co/blog/train-to-paint-with-code -
使用 CARLA 实现自动驾驶:https://huggingface.co/blog/sergiopaniego/bringing-carla-to-openenv-trl -
TRL + OpenEnv 文档:https://huggingface.co/docs/trl/openenv -
OpenEnv 文档:https://huggingface.co/docs/openenv -
通过并非自己编写的 Harness 训练编程 Agent:https://huggingface.co/spaces/FineEnvs/multi-harness-rl-slides -
多 Harness 强化学习终极指南:https://huggingface.co/spaces/FineEnvs/multi-harness-rl -
每条运行轨迹一个沙箱:https://huggingface.co/blog/sergiopaniego/rl-environments-2026 -
让 Token 持续流动:16 个开源强化学习库的经验:https://huggingface.co/blog/async-rl-training-landscape -
Async GRPO Trainer 文档:https://huggingface.co/docs/trl/async_grpo_trainer -
OpenEnv harnesses 文档:https://huggingface.co/docs/openenv/tutorials/harnesses