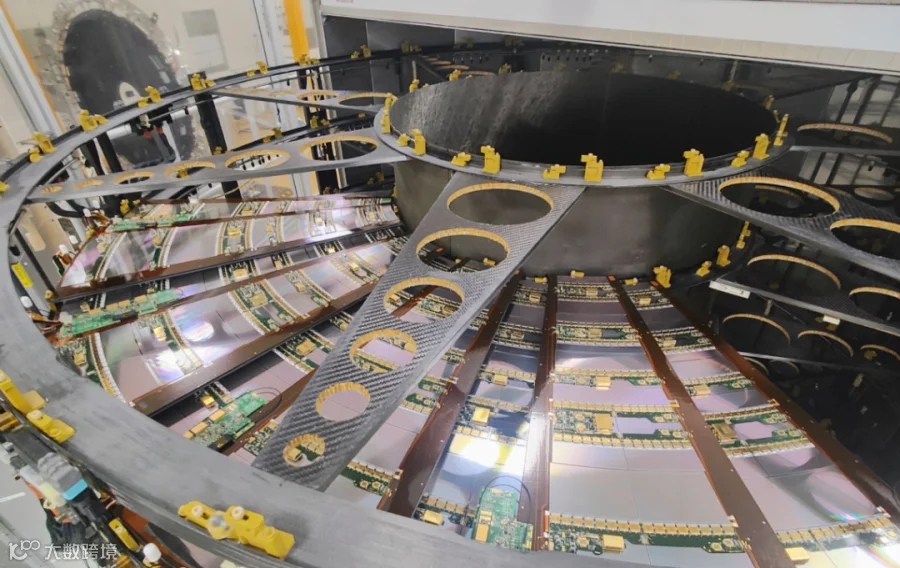
CERN(欧洲核子研究中心)作为世界上最大的粒子物理实验室,数十年来一直在从粒子碰撞中收集海量数据。随着近期AI能力的快速增长,CERN希望开发一个能更好地利用所有这些数据的基础模型。

为帮助实现这一目标,这家欧洲物理实验室已与法国AI公司Mistral展开合作。双方已签署意向声明,探索开发面向科学研究的基础模型。CERN已经在将AI用于粒子物理。通过与Mistral合作,CERN希望从多个专用AI模型转向一个更通用的、能够执行多项科学任务的基础模型。他们的第一个项目是一个拟议中的大型物理模型(据称名为Flare),将基于大型强子对撞机(LHC)的数十亿次模拟碰撞进行训练。
LHC已经收集了多少数据?
根据一些估算,CERN目前持有约1EB来自LHC的实验数据。这相当于100万TB。而且这一数量预计将大幅增长。2030年前后LHC的一次升级预计将使碰撞次数增加十倍。
与Mistral合作的新基础模型可以同时处理其中多项任务。它可以帮助重建碰撞事件和识别粒子,减少对独立算法的需求。

Mistral能从中得到什么?
这一合作提供了访问世界上最大科学数据集之一的机会,以及将其工作扩展到科学研究领域的机会。目前,CERN在流程的不同环节使用不同的AI工具。一些工具帮助重建碰撞后粒子的轨迹,而另一些则判断产生了什么类型的粒子。每个工具都是为特定任务训练的。通过Flare,CERN想看看一个模型能否从这些不同阶段的数据中学习,并同时完成其中几项工作。这可能使流程减少对独立算法的依赖,尽管无法保证它会比现有方法表现更好。
Mistral首席执行官Arthur Mensch认为,先进的AI模型正变得对科学进步不可或缺,其收益不应仅限于少数公司。CERN首席信息官Enrica Porcari表示,计划是将由此产生的任何成果与更广泛的物理界分享,而不是留在内部。两家公司还谈到将这种方法扩展到粒子物理之外,应用于科学研究的其他领域。目前,合作仍处于早期阶段,后续进展值得关注。两家公司尚未提供任何开发时间线或预算。此外,通用模型能否达到CERN现有专用算法的精度,仍有待观察。
据CERN称,Flare将是首个对撞机物理领域的模型,尽管在该领域使用基础模型的想法并不完全是新的。研究人员几年来一直在试验类似方法。2024年,汉堡大学的一个团队推出了OmniJet-α,他们将其描述为第一个面向粒子物理的跨任务基础模型。研究人员发现,一个被训练生成粒子喷注的模型,也能将所学到的知识应用于识别粒子喷注。后续使用真实LHC碰撞数据的工作也显示了预训练的收益,至少对某些任务如此。
CERN-Mistral的合作还有一个欧洲视角。CERN将其描述为加强欧洲在科学和AI领域能力的机会。Mistral以开发开放权重模型而闻名,这些模型可以被下载并独立运行,不过目前尚未确认Flare是否会以同样方式发布。
CERN并非唯一在探索这一领域的机构。
非营利研究计划Polymathic AI已经发布了开放科学模型和约115TB涵盖物理和天文学的训练数据。其Walrus模型拥有约13亿参数,旨在学习物理系统的行为方式。
另一个模型AION-1专注于天文学。
Google也在加大对科学AI的投入。我们最近报道过Gemini 4 Argon模型的发布,该模型在数小时内帮助设计了五种新酶,并提升了其AlphaQubit纠错系统的性能(延展阅读:Gemini 4 Argon 发布,称对AI Agent和科学发现产生重大影响)。Isomorphic Labs也在药物发现研究中使用该模型。
这些都是有趣的进展,不过对Google科学性能声明的独立评估结果外界褒贬不一。