

02第二章:qPCR为什么能够定量?
01两管DNA最终扩增得差不多,科学家却能知道它们最初相差多少倍?
两管PCR反应,第一管加入的目标DNA比较多,第二管加入的比较少。
仪器不断改变温度,DNA经历一轮又一轮的变性、退火和延伸。原本只有少量的目标片段,逐渐积累成大量扩增产物。
如果第一管最初有8000份目标DNA,第二管只有1000份。
两管的起始模板相差8倍。
使用传统PCR,等到35轮反应全部结束,再把产物拿去跑胶,你会发现两条条带都很亮。
PCR进行到后期,反应物逐渐消耗,扩增速度开始下降。两管反应即使起点不同,也可能在后期积累出接近的产物量。
但你使用实时荧光定量PCR,情况就不同了。
仪器在扩增过程中不断记录荧光信号。
第一管的荧光曲线可能在第18轮达到设定阈值,第二管则在第21轮才达到同样的阈值。
这两个数字就给我们提供了定量线索,
第一管比第二管提前3个循环达到阈值。
如果两管具有相同的扩增效率,并且在所分析的阶段每轮都恰好翻倍,那么:
23 = 8
起始模板数量正好相差8倍。
这个计算里藏着几个问题:
仪器究竟是怎样发现DNA增加的?
为什么DNA增加会让荧光信号改变?
为什么可以用达到某个阈值的循环数推算起始模板数量?
如果DNA每轮只增加90%,计算结果还会是8倍吗?
把这些问题弄清楚以后,后面出现的ΔCt、ΔΔCt以及各种相对表达量计算方法,就有了可以理解的科学依据。
02仪器看不见DNA分子,为什么还能知道DNA扩增了多少?
1qPCR仪真正测量的是荧光信号
你打开一台实时荧光定量PCR仪,里面有控制温度的模块,也有负责检测荧光的光学系统。
温度模块让反应体系按照设定程序升温和降温。
光学系统则负责激发荧光物质,并检测它们发出的光。
PCR反应本身仍然在扩增DNA,
只不过,研究人员在反应体系中加入了特殊的荧光检测组分,让扩增产物的积累能够转化为可记录的光学信号。
仪器在每个循环的指定阶段采集荧光数据,
一个孔完成40个循环以后,软件就能够得到这一反应孔在不同循环下的荧光强度变化。
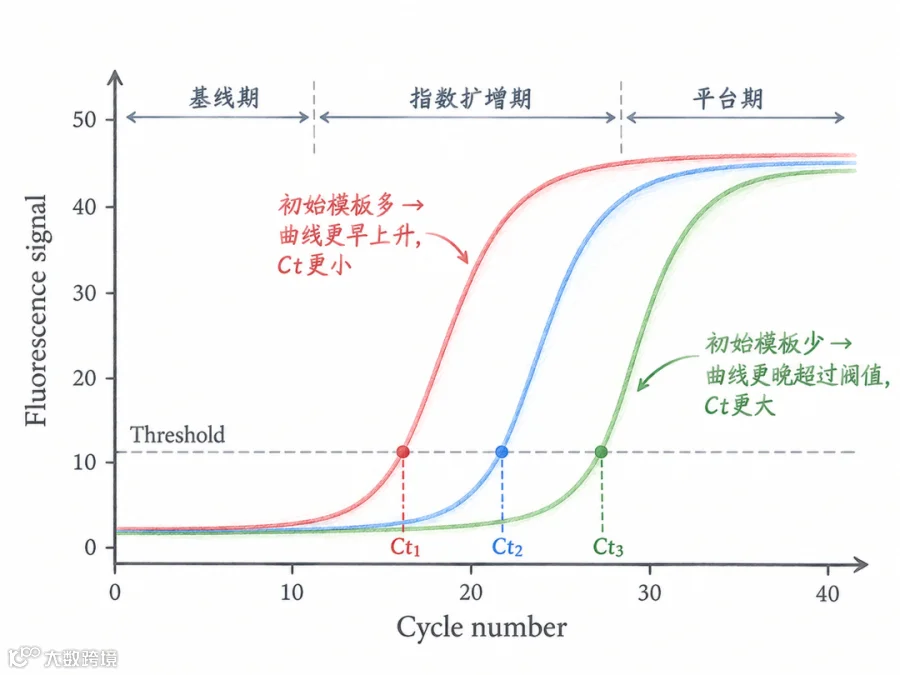
把循环数放在横坐标,把荧光信号放在纵坐标,再将每一轮的数据连接起来,就得到你熟悉的扩增曲线。
现在需要解决一个问题,
DNA本身不会在普通qPCR检测条件下自己产生足以供仪器进行这种定量分析的特征荧光。
研究人员究竟往反应体系里加入了什么?
目前常见的实时荧光PCR检测方法主要包括DNA结合染料法和序列特异性荧光探针法。
这两种方法的信号产生原理不同,但目的相同:让目标扩增产物的积累转化为可监测的荧光变化。
2SYBR Green:让双链DNA的增加变成荧光变化
还是我们上节课使用的例子,检测炎症相关基因IL6的表达。
从细胞中提取RNA,逆转录成cDNA,再把cDNA加入PCR反应体系。
体系里除了引物、DNA聚合酶和其他反应组分,还加入了一种能够与双链DNA结合的荧光染料。
常见的就是SYBR Green I。
这种染料在游离状态下的荧光比较弱。当它与双链DNA结合以后,荧光会明显增强。
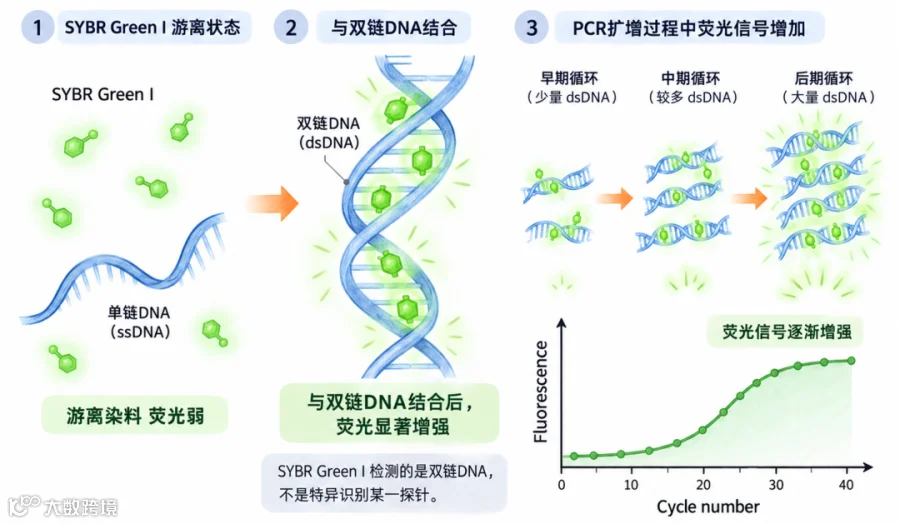
PCR扩增开始时,目标DNA数量较少,能够产生的扩增相关荧光信号也比较弱。
经过多个循环以后,目标扩增产物逐渐增加。
越来越多的染料能够与新形成的双链DNA结合,荧光信号便逐渐增强。
仪器每隔一个循环记录一次荧光强度,就能够观察扩增产物积累所引起的变化。
你可以把它理解成给双链DNA配备了一种能够发光的标记。
DNA积累得越多,在合适条件下产生的荧光信号就越强。
不过,SYBR Green有一个需要认真理解的特点。
它识别的是双链DNA结构,对DNA的具体序列并没有高度特异的识别能力。
如果你设计了一对IL6引物,
理想情况下,这对引物只扩增你希望检测的IL6目标片段。
可是,如果引物设计或反应条件存在问题,也可能产生非特异性扩增产物,甚至出现引物二聚体。
这些产物同样可以形成双链DNA。
SYBR Green也会与它们结合,并产生荧光信号。
于是,仪器记录到的荧光增加,同时包含目标扩增产物和非特异性扩增产物的贡献。
这也是为什么SYBR Green实验需要检查扩增特异性。
你看到一条漂亮的扩增曲线,只能说明检测到了荧光积累,还需要确认产生信号的是不是预期的目标片段。
3TaqMan探针:让目标序列被识别时产生荧光
研究人员还发展了另外一种思路。
既然普通DNA结合染料能够识别双链结构,我们能不能利用一段专门识别目标DNA序列的探针来产生荧光?
TaqMan探针就是这种思路的典型应用,它是一段能够与目标DNA特定序列互补结合的寡核苷酸。
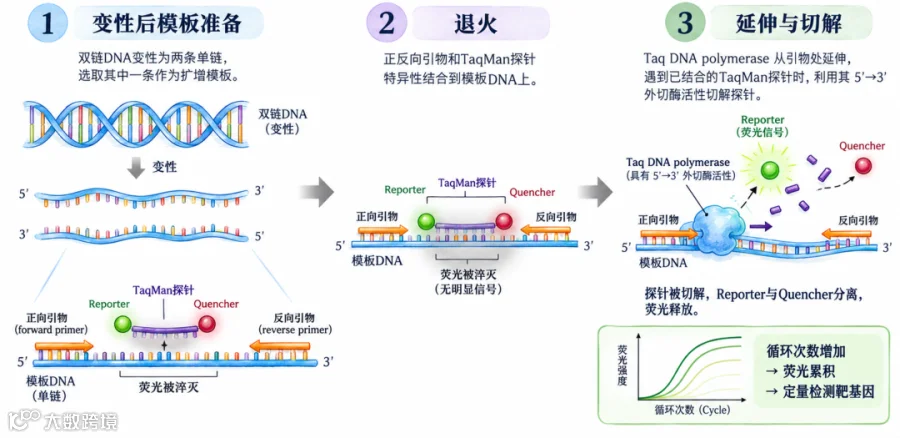
探针一端连接荧光报告基团,另一端连接淬灭基团。
当探针保持完整时,淬灭基团会抑制报告基团发出可检测的荧光。
PCR开始以后,引物和探针分别与目标DNA上的相应序列结合。
DNA聚合酶从引物末端开始延伸,
在典型的TaqMan水解探针体系中,当具有5′核酸酶活性的DNA聚合酶延伸到已结合的探针位置时,会切割探针。
探针被切割以后,报告基团与淬灭基团分离,荧光抑制作用减弱,报告基团的信号便能够被检测到。
每轮扩增都可能使更多探针被水解,报告荧光逐渐积累。
仪器监测这种荧光变化,就可以跟踪目标扩增过程。
和SYBR Green相比,TaqMan体系除了依靠引物识别目标序列,还利用探针提供额外的序列识别。
因此,在正确设计和验证的前提下,探针法通常具有较高的检测特异性,也适合利用不同荧光通道进行多重检测。
代价则是每个目标通常还需要设计或购买相应探针,实验成本和检测体系设计要求可能更高。
SYBR Green和TaqMan都是成熟的检测方案,
无论选择哪一种,仪器最终交给你的都是随PCR循环变化的荧光信号。
接下来的定量问题,就需要从这些信号的变化规律中寻找答案。
03qPCR扩增曲线为什么通常呈现S形?
1刚开始扩增时,为什么曲线几乎是一条平线?
打开qPCR软件,选中一个正常扩增的反应孔。
横坐标显示循环数,纵坐标显示荧光强度。
在常见的线性荧光坐标下,你会看到:
前面若干个循环,曲线几乎贴着底部。
经过一段时间以后,曲线开始明显上升。
再往后,曲线上升得越来越缓慢,最后逐渐趋于平稳。
整条曲线看上去接近一个S形。
我们从最开始的平缓部分讲起。
如果反应管里最初只有100份目标DNA,
第一轮理想扩增以后变成200份,第二轮变成400份,第三轮变成800份。
DNA数量在不断增加,
可是,与背景荧光和仪器检测噪声相比,这些新增产物产生的荧光信号可能仍然很弱。
仪器能够记录荧光读数,但暂时难以把扩增相关信号与背景变化可靠地区分开。
因此,在扩增曲线的早期,你能看到信号在某个水平附近轻微波动。
这一部分通常称为基线区。
基线区的荧光读数包含染料、探针、反应液和仪器系统带来的背景贡献。
需要特别记住,基线区目标DNA已经在复制,只是扩增带来的荧光变化还没有明显超出背景噪声。
这可以解释为什么一些低起始模板量的样本,要经过很多个循环以后才能看到曲线明显抬升。
2DNA积累到一定程度以后,曲线为什么突然升起来了?
PCR继续进行,
扩增效率很高,目标DNA在适当阶段接近每轮翻倍。
起始时的100份目标模板,经过10轮理想扩增,理论上可以达到:
100 × 210 = 102400
再经过5轮,理论数量进一步变为:
100 × 215 = 3276800
目标产物的积累速度越来越快。
当扩增产物形成的荧光信号明显超出背景波动范围时,软件就开始显示出一条不断上升的曲线。
在扩增效率相对稳定的阶段,DNA数量按照近似指数规律增长。
这个阶段称为指数扩增期。
对于正常的定量反应,研究人员希望在这一阶段,或经过验证的适当动力学范围内,提取与起始模板量有关的信息。
因为在这里,扩增产物的积累还能够较好地反映最初模板数量的差异。
你可能又有一个疑问,
为什么指数扩增在图上看起来是一条越来越陡的曲线?
扩增数量每一轮增加的绝对值不断变大,
从100份增加到200份,只增加100份。
从100万份增加到200万份,却增加了100万份。
两次变化都是翻倍,但新增产物的绝对数量相差很大。
当纵坐标使用线性刻度时,这种指数增长就会表现为不断加速上升的曲线。
如果把扣除背景后的荧光信号取对数,再绘制扩增曲线,理想指数扩增阶段则会近似呈现一段直线。
指数关系经过对数转换,可以转化为线性关系。
后面建立标准曲线、计算扩增效率时,我们还会利用类似的数学性质。
3为什么扩增曲线最后会进入平台期?
PCR反应不可能无限复制DNA,
反应体系中的引物、脱氧核苷酸、聚合酶和其他组分都有一定限制。
经过大量循环后,反应环境也逐渐发生变化,扩增产物之间的重新结合等因素可能进一步影响扩增。
于是,反应不再保持早期相对稳定的指数增长。
曲线开始从快速上升转入增长减缓的阶段,随后逐渐接近平台。
到了平台期,即使再增加一个循环,扩增产物的增加量也可能已经很小。
现在重新看文章开头的两管样本,
A管有8000份起始模板,B管有1000份。
它们进入快速扩增阶段的时间不同,都在反应后期接近各自的产物积累上限。
因此,仅观察最终荧光强度,通常难以准确恢复它们的起始模板数量关系。
还有一个容易被忽略的问题,
不同反应孔的最终荧光高度可能受到探针浓度、染料性质、扩增产物特征、背景信号和光学检测条件影响。
所以,你不能看到某条曲线的最高点比另一条高,就直接断言它的起始模板更多。
对于常规qPCR,科学家更重视扩增曲线在经过验证的定量阶段所表现出的信息。而Cq值,就是从这段扩增过程里提取出的一个重要数字。
04Cq值究竟是怎么产生的?为什么数值越小,通常意味着起始模板越多?
1仪器怎样从一条曲线里得到一个Cq值?
你依然有两份样本,
A样本的扩增曲线比较早开始明显上升,
B样本则要晚几个循环才能出现明显的荧光增加。
现在,我们在扣除背景后的扩增曲线上设置一个合适的荧光阈值。
阈值需要高于背景噪声,并落在适合进行定量分析的扩增区域内。
A样本的曲线先到达这条阈值线,B样本的曲线随后到达。
在采用固定阈值法的软件中,曲线与阈值线的交点所对应的循环数,就是常见的Ct或Cq值。
例如:
A样本在第18个循环附近达到阈值,Cq约为18。
B样本在第21个循环附近达到阈值,Cq约为21。
A样本达到相同荧光水平需要的循环数更少。
在检测性能相同的前提下,这通常提示A样本加入反应中的起始目标模板量更多。
你可能还发现了,软件导出的 Cq 经常是 18.37、21.64 这样的数字。
PCR循环明明是按整数轮进行的,为什么会出现小数?
仪器在离散循环点上采集信号,而分析软件可以根据相邻数据点及所采用的计算模型,估计曲线达到阈值时的连续位置。
因此,Cq可以是小数,它是从扩增信号中计算出的定量指标。
2为什么有的仪器写Ct,有的写Cq,还有的写Cp?
不同仪器和软件在历史上采用过不同的术语。
Ct通常写作循环阈值,英文为Threshold Cycle。
Cq通常写作定量循环数,英文为Quantification Cycle。
一些仪器软件还使用Cp等名称。
这些术语都与从扩增曲线提取定量信息有关,但具体算法可能存在差异。
有些软件使用固定荧光阈值法,有些使用基于曲线形状或导数的分析方法。
不同算法得到的数值可能不同,为了方便理解,本章接下来主要使用Cq这一术语,并以固定阈值法进行数学推导。
你以前看到的Ct,在对应同一种阈值判定方法时,可以按照同样的思路理解。
实际分析时,需要保留软件所采用的定量算法及相关设置。
3阈值放在哪里,会影响Cq值吗?
一条正常扩增曲线在第19轮时荧光信号较低,第20轮继续增加,第21轮又进一步增强。
如果你把阈值放得比较低,曲线可能在19点几个循环就与阈值相交。
如果把阈值调高,交点可能移动到20点几个循环。
因此,Cq值会受到阈值设置的影响,但这并不意味着阈值可以随意选择。
阈值需要避开早期背景噪声,也要避免放在扩增效率已经明显下降的后期区域。
对于采用统一阈值进行比较的同一检测体系,阈值设置应保持一致并经过合理验证。
如果两条曲线具有相同的扩增效率,在指数扩增阶段保持平行,那么在合适范围内改变统一阈值,通常不会明显改变它们之间的Cq差。
可是,如果两条曲线的扩增效率不同,改变阈值就可能影响两者之间的差值。 因此,遇到不同组之间差异很小的实验,除了看Cq值,还要检查扩增曲线的形状以及实验体系的扩增性能。
此外,基线校正也会影响Cq计算。
如果软件错误地估计背景荧光,扣除背景后的曲线会发生偏移,最终改变Cq结果。
到这里,我们已经知道Cq值从哪里来。
下面进入整章最核心的部分,它为什么能够用于推算DNA起始数量?
05从PCR扩增规律出发,亲手推导Cq与起始模板量的关系
1最理想的情况:DNA每轮恰好增加一倍
第一章已经提到,PCR利用DNA模板不断复制目标序列。 假设最初有100份目标DNA。
|
|
|
|---|---|
|
|
|
|
|
|
|
|
|
|
|
|
我们可以把这一过程写成:
Nn = N0 × 2n
其中,N0是起始目标模板数量,Nn是经过n轮扩增以后的目标数量。
这是理想扩增模型。
现在假设仪器在某一设定阈值下,对应的有效扩增产物数量为一个固定值,记为Nt。
这里的Nt是为了推导而引入的等效阈值数量。仪器直接检测的是荧光信号,并不会在每个循环里逐个数出DNA分子。
如果扩增体系相同、荧光信号与扩增产物数量在相关范围内保持稳定的对应关系,就可以用这种模型理解定量原理。
当反应达到阈值时:
Nt = N0 × 2Cq
把公式稍微整理,就得到:
从Cq反推起始数量
N0 = Nt2Cq
现在你应该能够看出Cq为什么有定量意义了。
对于同一套检测体系,当有效阈值数量固定时,Cq越大,分母越大,对应的起始模板数量越少。
Cq越小,意味着目标模板需要经历的扩增轮数越少,对应的起始数量通常越多。
2为什么Cq相差一个循环,可能意味着起始模板相差两倍?
有两份样本A和B,
A样本达到阈值时的循环数是20,B样本达到阈值时的循环数是21。
按照前面的公式:
N0,A = Nt220
N0,B = Nt221
我们想知道A样本的起始模板量是B样本的多少倍。 用A除以B:
N0,AN0,B = 221220 = 2
这说明,在理想翻倍扩增、有效阈值一致的条件下,Cq相差一个循环,起始模板数量相差两倍。
如果A样本Cq为20,B样本Cq为22呢?
N0,AN0,B = 222 − 20 = 4
相差两个循环,对应4倍。
相差三个循环,对应8倍。
相差四个循环,对应16倍。
所以,大家经常听到的“Ct差1就是2倍,差3就是8倍”,来自指数扩增的数学规律。
不过,这个规律有一个非常明确的前提。
PCR需要在相关定量阶段达到理想的100%扩增效率,而且所比较的反应需要具有可比的检测条件。
真实实验中的PCR,很少能够在所有循环和所有样本中始终完美翻倍。
那么,当扩增效率偏离100%时,公式该怎么变?
3真实PCR并不总能翻倍:扩增效率E是怎么来的?
有100份目标DNA,
理想情况下,经过一轮扩增,100份模板对应增加100份新产物,总量达到200份。
这时,我们把扩增效率记为100%。
但如果实际只增加了90份目标产物呢?
原来有100份, 新增加90份。
总共变成190份,这一轮的扩增效率就是90%。
因此,如果把扩增效率记为E,并用小数表示,那么一轮扩增后的目标数量为:
N1 = N0(1 + E)
扩增效率为100%时:
E = 1
N1 = 2N0
扩增效率为90%时:
E = 0.9
N1 = 1.9N0
扩增效率为80%时:
E = 0.8
N1 = 1.8N0
如果扩增效率在所研究的指数扩增阶段近似保持稳定,经过n轮扩增以后,就有:
一般指数扩增模型
Nn = N0(1 + E)n
这才是更一般的PCR指数扩增模型。
你可能在某些文献里看到另一种写法:
Nn = N0An
其中A表示每轮扩增倍数,也就是:
A = 1 + E
如果扩增效率是100%,那么扩增倍数A就是2。
如果扩增效率是90%,那么扩增倍数A就是1.9。
先核对E的定义
这里要留意,不同文献对E的符号定义可能不同。
有的把100%扩增效率写成E=1,有的把对应的扩增倍数写成E=2。
阅读计算公式时,需要先确认作者采用的是哪一种定义。
4扩增效率只有90%时,Cq相差3个循环还代表8倍吗?
我们继续使用两个样本,
A样本的Cq为18,B样本的Cq为21,两者相差3个循环。
但现在假设检测体系的扩增效率为90%。
每轮扩增倍数为1.9。
在其他条件相同的情况下,两者的起始模板量之比为:
N0,AN0,B = 1.921 − 18
= 1.93
≈ 6.86
你看,结果变成了约6.86倍。
如果扩增效率为100%,对应8倍。如果扩增效率为90%,对应约6.86倍。
如果扩增效率为80%,对应:
1.83 ≈ 5.83
同样相差3个循环,起始模板数量关系却不同。
定量的关键条件
因此,Cq差值需要结合扩增效率解释。
”
尤其当实验涉及多个目标基因、多个内参或需要定量比较较小的表达差异时,扩增效率的影响可能逐渐累积。
2001年,Pfaffl提出了一种考虑目标基因和参考基因各自扩增效率的相对定量模型。
同一年,Livak和Schmittgen系统介绍了经典的2 − ΔΔCt方法及其假设条件。
为什么会出现两种不同的计算方法?
实验体系的扩增效率可能不同,而不同计算模型对扩增效率的处理方式也不同。
第四章会把它们放在同一组原始数据中比较。
06扩增效率怎么知道?为什么大家都要做标准曲线?
1科学家怎样测量一套引物的扩增效率?
你设计好一对IL6引物,准备使用它检测20个对照样本和30个实验样本。
这时候,你希望知道这套引物和反应体系能否在相关模板浓度范围内稳定扩增。
一个常用的方法是制作标准曲线。
你准备一份含有目标序列的标准DNA样品,
第一份反应加入100万份目标模板,
第二份加入10万份,
第三份加入1万份,
第四份加入1000份,
第五份加入100份。
每次都按照10倍进行梯度稀释。
为了评估检测重复性,可以为每个浓度设置多个独立反应孔。
接着,使用同一套引物和反应体系进行qPCR。
如果扩增效率为100%,模板数量每减少10倍,达到相同荧光阈值所需要的循环数理论上会增加多少?
我们可以用前面的扩增公式推导。
当起始模板相差10倍,且扩增效率为100%时:
2ΔCq = 10
对两边取以10为底的对数:
ΔCq = log210
ΔCq ≈ 3.32
也就是说,起始模板每降低10倍,理论上需要额外约3.32个循环才能达到相同的阈值。
这是标准曲线中非常重要的数学关系。
2标准曲线为什么是一条向下倾斜的直线?
我们获得一组理想化数据,
|
|
|
|---|---|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
你会发现,起始模板数量每减少10倍,Cq大约增加3.32。
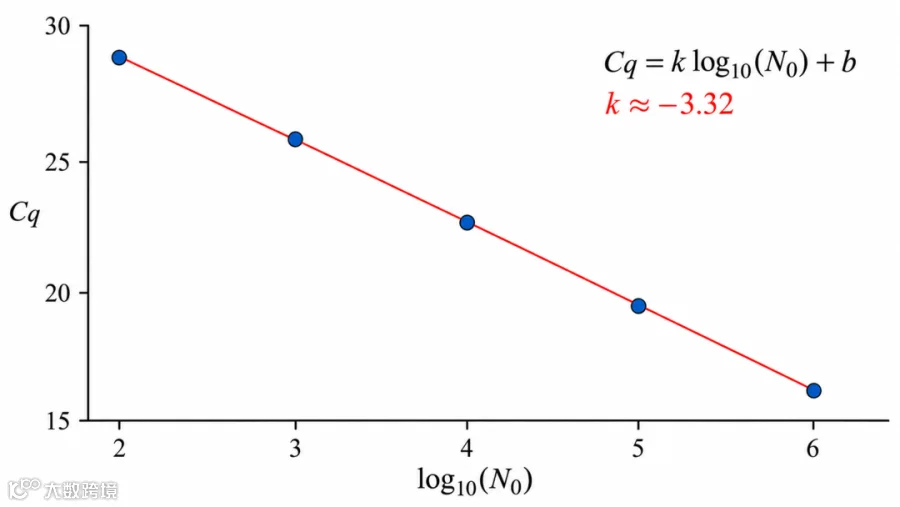
现在,以起始模板数量的常用对数为横坐标,以Cq为纵坐标。因为:
log101000000 = 6
log10100000 = 5
log1010000 = 4
这些点会近似排列成一条向下倾斜的直线。
我们可以使用线性回归得到:
Cq = klog10(N0) + b
其中,k是斜率,b是截距。
对于理想100%扩增效率的检测体系,标准曲线斜率约为:
k = − 3.322
这个斜率和扩增效率之间具有明确的数学关系。
3标准曲线的斜率怎么转化为扩增效率?
从一般扩增公式出发:
Nt = N0(1 + E)Cq
整理并取对数,可以得到:
Cq = log10Nt − log10N0log10(1 + E)
在同一检测体系、有效阈值条件一致时,标准曲线斜率为:
k = − 1log10(1 + E)
把公式整理,就得到扩增效率的计算方法:
由标准曲线斜率计算效率
E = 10 − 1/k − 1
如果你希望把它表示成百分数,再乘以100%。
例如,标准曲线斜率为-3.322,代入公式:
E = 10 − 1/( − 3.322) − 1
得到:
E ≈ 1
也就是100%的扩增效率。
如果斜率为-3.60:
E = 101/3.60 − 1
得到的扩增效率约为89.6%。
如果斜率为-3.10,得到的扩增效率约为110.2%。
看到这里,你可能会疑惑,刚才我们说每轮理论上最多翻倍,为什么还能算出超过100%的扩增效率?
在常规的单一目标PCR扩增模型下,超过100%的表观扩增效率通常提示估计过程受到其他因素影响。
例如,梯度稀释存在移液误差,标准样本浓度记录不准确,存在扩增抑制,或者基线处理与定量范围选择影响了斜率估计。
超过100%的效率如何解释
因此,看到110%甚至更高的结果时,需要检查实验和分析过程。
过去,许多qPCR操作资料会把90%—110%的扩增效率作为常用的初步参考范围。
这一范围有实际使用价值,但还需要检查标准曲线覆盖的浓度范围、重复孔一致性、扩增特异性、测量不确定性和实验用途。
4标准曲线的R²很高,就说明实验一定可靠吗?
你在软件里看到:
R2 = 0.999
这个数字非常接近1。它表示,在所采用的线性回归模型下,数据点与拟合直线具有很高的一致性。
但还需要看斜率,
如果R²很高,斜率却明显偏离合理的扩增关系,说明标准曲线虽然近似线性,扩增效率估计仍然可能存在问题。
再比如,你的标准曲线在高浓度范围内表现很好,但最低浓度的几个反应孔出现随机检出或较大波动。
即使整体R²仍然较高,低浓度样本的定量可靠性也可能不足。
标准曲线需要同时回答几个问题。
-
目标模板数量改变时,Cq是否按照合理的规律变化? -
这种关系在哪些浓度范围内成立? -
同一浓度重复检测时,Cq波动有多大? -
当目标模板数量很少时,仪器还能否稳定检出?
这些信息共同决定了检测体系是否能够支持后续研究。
07为什么有些样本Ct值很大,软件却不能可靠定量?
1能检测到目标,和能准确测量目标数量,是两回事
你检测IL6时,有一个样本的Cq为23,另一个样本的Cq为37。
这两份样本都出现了扩增信号。
可是,它们的测量可靠性一定相同吗?
这取决于检测体系的性能验证结果。
对于Cq为23的样本,如果目标数量位于检测体系经过验证的定量范围内,扩增曲线正常,重复结果稳定,那么就有条件进行可靠定量。
而Cq为37的样本,可能已经接近该检测体系的低浓度极限。
当起始目标分子非常少时,样本分装过程中的随机性会变得明显。
假设某种稀释液平均每个反应孔只有1个目标模板分子。
实际分装以后,有的孔可能分到2个,有的孔分到1个,也有的孔一个都没有。
即使移液操作规范,这种分子抽样的随机性也仍然存在。
结果可能表现为部分反应孔出现扩增,部分反应孔没有扩增。
即使都出现扩增,各孔的Cq也可能产生较大波动。
这里就引出了两个概念:检测限和定量限。
2检测限和定量限有什么区别?
检测限通常记为LOD。
它关注的是,在规定的检测条件和检出概率标准下,目标物质最低能够以多大数量或浓度被可靠检出。
例如,某套检测方法经过验证,在某一低浓度水平下,能够在95%的反应中检出目标。
这个浓度水平就可能用于描述相应条件下的检测限。
定量限通常记为LOQ。
它关注的是,在规定的准确度、精密度等性能要求下,目标物质最低或最高能够在哪些水平被可靠定量。
对于qPCR,还经常使用下定量限和上定量限这两个概念。
二者之间经过验证的浓度区间,构成适用的定量范围。
如果某种检测体系能够在很低浓度下检出目标,但重复检测得到的定量结果波动很大。这个低浓度可能处于可检出范围内,却已经超出可靠定量范围。
高Cq值的处理边界
因此,实验里出现Cq为35、37或39的结果时,需要检查实验体系的定量范围、扩增曲线、阴性对照和重复表现。
3为什么同一个低丰度基因,技术重复之间可能差很多?
你把同一份cDNA分装到三个反应孔中,得到: 22.10、22.18、22.21。
三个结果比较接近。
再检测另一个非常低丰度的目标基因,得到: 35.8、37.1,以及一个没有获得有效Cq的反应孔。
此时,三孔之间的差异已经很大。
你可能想把没有扩增的孔删掉,再计算另外两个孔的平均值。
等等,先查明原因啊,
如果是污染、移液失误、反应失败或软件分析设置错误,应根据事先规定的质量控制标准处理。
如果目标分子本身已经非常稀少,那么部分反应孔没有检出,可能就是低浓度抽样随机性的表现。这种情况涉及检测限附近的缺失或未检出数据,简单删除没有扩增的孔,可能使保留下来的样本显得表达量更高。
同样,把未检出的孔随意指定为Cq=40,也会引入偏差。
因此,样本进入后续统计分析之前,你需要知道检测值是否可靠,以及没有获得有效Cq的原因是什么。
这也是为什么多样本qPCR分析绝不能跳过原始扩增曲线检查。
08研究人员为什么还要看熔解曲线?
1扩增曲线很漂亮,产物却可能扩增错了
你使用SYBR Green检测IL6,仪器输出了一条平滑的S形扩增曲线。
Cq为22.5,数据上看起来很正常。
但如果引物同时扩增了非目标序列,SYBR Green依然产生荧光。
此时,你得到的是包含非特异性产物贡献的检测信号。
需要进一步判断扩增产物是否符合预期,
在使用双链DNA结合染料的实验中,熔解曲线分析是一种常见的检查方法。
2熔解曲线为什么能帮助识别非特异性扩增?
DNA双链依靠碱基之间的相互作用保持结构稳定,当温度逐渐升高,双链DNA会逐步解离成单链。
不同DNA片段的长度、碱基组成和序列特征不同,其熔解行为可能存在差异。
对于SYBR Green这样的染料,DNA双链解离以后,能够结合染料的双链结构减少,荧光信号会随之变化。
仪器连续升温并监测荧光,就能够记录熔解过程。
研究人员通常进一步利用荧光对温度变化的负导数绘制熔解峰图。
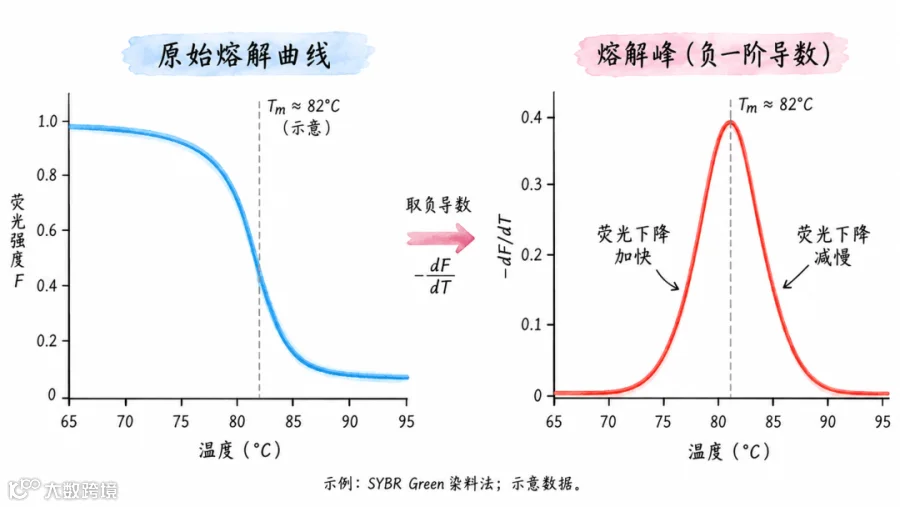
如果反应主要产生一种预期扩增产物,常常能够看到一个占优势的熔解峰。
如果同时存在多种熔解行为不同的扩增产物,可能出现额外峰或肩峰。
引物二聚体也可能形成自己的熔解信号,
因此,熔解曲线可以帮助发现部分非特异性扩增问题。
但要注意,不同DNA片段可能具有接近的熔解温度,某些非特异性产物也可能难以通过普通熔解分析分辨。
如果需要更加严格地确认产物身份,还可以结合琼脂糖凝胶电泳、扩增产物测序等方法。
对于采用TaqMan水解探针的常规检测体系,信号生成原理与SYBR Green不同,熔解曲线也不是其常规判读的核心手段。
因此,质量检查方法需要和检测化学体系相匹配。
3没有模板的反应孔为什么也可能出现扩增?
你在96孔板上设置一个不加入目标模板的阴性对照孔,通常称为无模板对照,也就是NTC。
按理说,这个反应孔里没有人为加入的目标DNA。
如果仍然出现扩增信号,可能需要考虑试剂或操作造成的核酸污染,也可能与引物二聚体等非特异性产物有关。
这时候,熔解曲线以及其他验证方法就可以帮助判断信号来源。
对于研究RNA表达的RT-qPCR,还需要考虑基因组DNA污染。
有些样本提取RNA时可能残留少量基因组DNA。
即使没有完成有效逆转录,后续PCR仍然可能扩增到相应DNA序列。
因此,根据实验设计,还应设置无逆转录对照,检查是否存在能够影响结果的DNA污染。
你看,一张qPCR数据表里能导出多少个Cq值,只代表仪器完成了多少次相关信号分析。
每一个Cq都需要质量依据
每一个Cq是否对应预期目标,是否位于可靠定量范围内,还需要结合实验质量控制判断。
”
09绝对定量和相对定量,到底有什么区别?
1如果你想知道样本里有多少份目标DNA,可以使用绝对定量
你在检测某种DNA病毒时,研究目的要求估计每微升提取液中有多少份病毒DNA。
可以使用经过准确赋值的标准品,制作覆盖适当浓度范围的标准曲线。
检测未知样本以后,根据其Cq在标准曲线上的位置,估计加入反应体系的目标DNA拷贝数。

再结合样本稀释倍数、反应加入体积和核酸提取流程,换算为研究所需的浓度或样本单位。
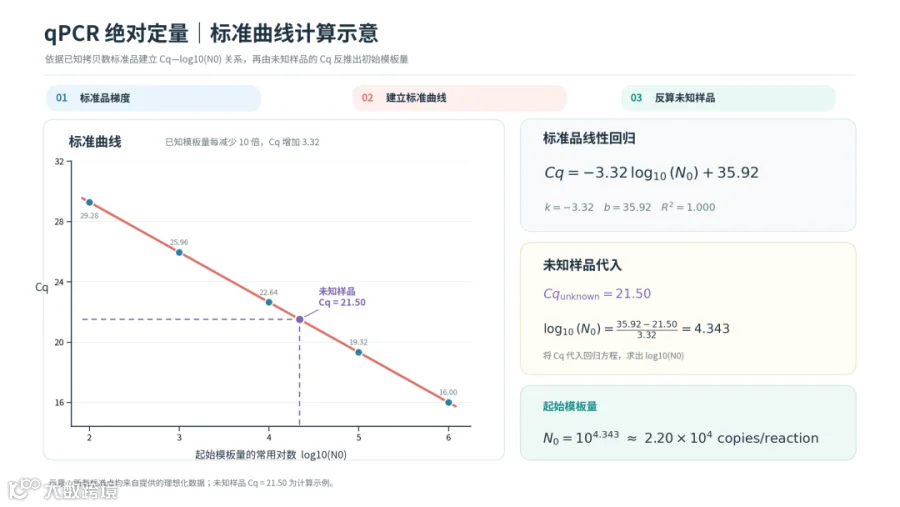
这就是绝对定量的典型思路。
不过,“绝对定量”中标准品浓度赋值、稀释过程、样本提取效率和扩增抑制,都可能影响结果。
对于RNA绝对定量,如果使用的是DNA标准品,RNA逆转录过程的效率差异还需要另外考虑。
因此,结果必须明确报告所测量的对象,以及最终采用的单位。
例如,PCR反应中的目标DNA拷贝数,与每毫升原始样本中的目标RNA拷贝数,需要经过不同的实验和换算步骤才能建立关系。
2如果你想知道药物让IL6表达增加了多少倍,就涉及相对定量
再回到抗炎药物实验,你的问题是:
给细胞加入某种药物以后,IL6的mRNA表达水平相对于对照组变化了多少?
这时,你通常更关心不同实验条件之间的相对表达差异。
例如,对照组经过合理归一化以后,被设定为一个比较基准。
实验组的IL6表达水平相对于这个基准可能增加,也可能降低。
若你最终报告:实验组相对于对照组的IL6表达量增加约3倍。
这里的3倍描述的是相对变化。
在实际研究中,还需要根据实验目的确定使用哪种归一化方法以及如何设定对照基准。
相对定量中最常见的工具之一,就是前面提到的ΔCt与ΔΔCt方法。
但为什么要连续做两次差值计算?
我们可以用一个很小的例子,提前看一下它们试图解决的问题。
10为什么只比较目标基因的Cq值,可能把整个实验带偏?
1一个差异
你检测两份细胞样本,
A样本来自对照组, B样本来自实验组。
目标基因是IL6,内参基因是经过适当验证的参考基因。
检测结果如下:
|
|
|
|
|---|---|---|
|
|
|
|
|
|
|
|
如果只看IL6,你会发现B样本比A样本提前一个循环达到阈值。
如果扩增效率为100%,你可能认为B样本加入反应的IL6目标模板数量约为A样本的两倍。
可接着看看内参,B样本的内参Cq同样比A样本提前一个循环。
也就是说,目标基因和内参基因都出现了相同方向、相同循环数的变化,这可能与两份样本的cDNA投入量不同有关。
如果你直接把IL6的Cq差值解释为药物造成的基因表达变化,就会把这种投入量差异也算了进去。
2把同一个样本里的目标基因和内参联系起来
在一个目标基因和一个稳定内参的经典分析框架中,可以为每个样本计算:
同一样本内归一化
ΔCq = Cq目标基因 − Cq内参基因
对于A样本:
ΔCqA = 22 − 18 = 4
对于B样本:
ΔCqB = 21 − 17 = 4
两份样本的ΔCq相同,在目标基因和内参基因的扩增效率满足相应分析模型要求、参考基因稳定等条件下,这提示两份样本的目标基因相对于内参基因的表达关系没有发生变化。
虽然B样本的目标基因原始Cq提前了一个循环,但内参也发生了相同的变化。
这就解释了为什么要引入内参归一化。
现在你可以把这个例子再扩大一点,
对照组有20个样本,实验组有30个样本。
每份样本都具有自己的目标基因Cq值和内参基因Cq值。
那么,在经典的单内参ΔCq分析中,每一份独立生物学样本都应保留目标基因与对应内参的关系。
你不能把50个样本的目标基因Cq值全部混在一起,再随意选一个内参Cq进行计算。也不能因为实验组有30个样本,就把它们直接当成30个相互独立的统计比较结论。
每一份生物学样本的归一化结果,需要按照实验设计进一步进行组间比较。
还有一个容易忽略的条件,目标基因和参考基因可能使用不同引物和荧光检测体系。因此,直接把不同基因的原始Cq当成具有完全相同测量尺度的分子数量,会产生问题。
经典ΔΔCq模型依赖相应的扩增效率条件。对于不同扩增效率的检测体系,还可以采用效率校正模型。
另外,内参归一化通常能够减少部分样本投入量和共同技术变化造成的影响,但它无法自动消除所有RNA提取、逆转录、抑制和样本质量差异。
第三章会解释如何通过样本处理和参考基因验证减少这些误差。
第四章再把真正涉及20个对照样本和30个实验样本的完整计算过程展开。
11当你真的拿到50个样本的原始数据,应该先看什么?
如果实验涉及20个对照样本、30个实验样本。
每个生物学样本都检测IL6和一个经过验证的内参基因,
每个检测设置3个技术重复孔。
只考虑这两种检测,每个样本就需要6个反应孔。
50个样本合计需要300个反应孔,还没有包括标准曲线、阴性对照和其他质量控制反应。
你把所有原始数据导出来,发现软件已经帮你计算好了Cq。
这时候,你可以点开扩增曲线。
看同一套检测的反应孔是否出现预期的扩增形态,早期基线有没有异常,荧光信号是否正常进入可分析的定量阶段。
随后查看对应的质量控制结果。
对于采用SYBR Green的反应,需要检查熔解曲线,以及是否存在非特异性扩增的迹象。
再看看阴性对照和无逆转录对照有没有出现需要调查的信号。
确认检测体系具备适当的扩增效率,并且样本结果处于已经验证的定量范围内。
接下来,检查技术重复,
某个样本的三个技术重复 Cq 分别为22.10、22.15、22.18,
这些结果比较接近。
而另外一个样本的三个技术重复 Cq 分别为22.10、22.20、27.50。
第三个孔和前两个孔出现很大差异,这时需要检查原始曲线、孔位、熔解结果、移液记录和其他相关信息,按照预定的质量控制规则判断异常原因。
当你把每个反应孔的检测质量检查清楚以后,再依据实验设计整理生物学样本对应的数据。
如果同一生物学样本的一组技术重复通过了质量检查,可以根据经过验证的分析方法汇总这些测量结果,随后计算相应的归一化表达指标。
如果检测体系采用效率校正的定量方法,则需要按该方法处理原始曲线或Cq数据。
最后才进入组间统计分析。
现在再看“每组有很多样本”这个问题,样本数量虽然增加了,但测量规律依然相同。
-
每个反应孔的荧光信号都来自自己的扩增过程。 -
每个Cq都需要在正确的检测体系和算法下解释。 -
每份独立生物学样本都需要保留自己的测量与归一化关系。 -
而组间差异是否可靠,要由合适的统计方法结合独立生物学样本的数据来判断。
既然每个Cq都受到样本投入量、引物性能和检测条件影响,那么一场可靠的qPCR实验究竟该怎样安排?
你应该准备多少份生物学样本?
同一个样本为什么要设置技术重复?
内参基因应该怎样选择?
一个实验有50份甚至500份样本时,怎样安排PCR板、对照和质量控制,才能让最终数据真正具有可比性?
第三章,我们将从实验设计开始,逐渐解决这些问题。
•••
本章参考文献
Livak K. J., Schmittgen T. D. (2001). Analysis of Relative Gene Expression Data Using Real-Time Quantitative PCR and the 2−ΔΔCT Method. Methods, 25(4), 402–408. DOI:10.1006/meth.2001.1262。
Pfaffl M. W. (2001). A new mathematical model for relative quantification in real-time RT-PCR. Nucleic Acids Research, 29(9), e45. DOI:10.1093/nar/29.9.e45。