

LangChain 的 Jess Weng 以一个每周生成竞品报告的 Agent 为例,介绍上下文卸载、摘要压缩、Skills、子 Agent 和长期记忆怎样配合。以下是全文翻译。
要点
-
长时间运行的 Agent 会不断积累上下文。当信息量超过模型能够承载的范围时,就会出现“上下文腐化”,导致准确率下降。 -
Deep Agents 是 LangChain 开源的 Agent 运行框架。它通过五种技术,把上下文移出当前窗口,而不是删除这些信息,以此避免上下文腐化。 -
Deep Agents 将 Agent 的记忆保存为普通文件,存放在由你控制的存储中。因此,即使更换模型或服务商,也能保留它已经学到的内容。
如果你曾在考试前一晚临时抱佛脚,应该熟悉这种感觉:越往后复习,前面几章的内容就越容易忘。
Agent 也有同样的问题。任务越长,它接收的信息就越多,包括指令、工具返回结果、文件等。最终,这些上下文会多到难以轻松容纳在模型的上下文窗口中。模型背负的历史记录、噪声和工具输出越多,准确率与推理表现往往就越差。
在 Agent 工程中,我们把这种现象称为上下文腐化(context rot)。本文将介绍管理 Agent 上下文窗口的几种技术,以及 Deep Agents 运行框架如何通过中间件(middleware),把这些技术接入 Agent 的运行过程。
理解上下文工程技术
简单来说,Agent 就是一个模型,外面再包上一层运行框架(harness)。

Harness 是围绕大语言模型的运行框架
Agent 用来应对上下文腐化的上下文工程技术,主要分为两类:
-
阻止不必要的信息进入上下文窗口。 -
管理和筛选已经进入上下文窗口的信息。
运行框架会有针对性地运用这些方法,让模型在合适的时机,获得当前任务所需的上下文,也就是检索(retrieval)。
不过,要把一套能做好这件事的运行框架搭起来,说起来容易,做起来难,需要投入不少工作。如果你属于考前一晚才开始抱佛脚的那类人,这个工作量可能有点大。
Deep Agents 是 LangChain 开源的运行框架。它可以包裹你选择的模型,通过多种技术,把上下文移出当前窗口,放进文件、摘要或另一个 Agent 中。这样,主 Agent 只需携带当前需要的内容,之后有需要时仍能找回原始数据:
-
上下文卸载(offloading):把体积较大的工具结果和用户消息保存到文件系统,模型只看到预览。 -
摘要压缩(summarization):当对话接近上下文上限时,把较早的消息压缩成摘要。 -
技能(Skills):只有模型认为某项任务知识与当前工作相关时,才加载它。 -
子 Agent(subagents):把会产生大量噪声的工作放进独立的上下文窗口,只把结果返回主 Agent。 -
长期记忆:把 Agent 学到的内容保存到文件,带入下一次对话。
将上下文工程用于常见场景
来看一个实际场景:竞品分析 Agent。每周一,它会研究五家竞争对手,再按团队模板写一份报告。一次运行大致如下:
-
拉取 A 公司的市场数据导出文件,包含数万行数据。 -
搜索新闻,阅读几篇文章并做笔记。 -
对 B 到 E 公司重复上述步骤。 -
起草报告,根据你的反馈修改,再完成排版。
到第 4 步时,Agent 的每一次模型调用都已经携带着五份原始数据导出、数十条搜索结果,以及两份过时的草稿。其中大部分内容与最终报告的排版毫无关系。
检索方法,例如 RAG 或文件系统搜索,能帮助 Agent 只取回需要的信息,但这仍然只解决了一半问题。即使 Agent 检索得很精准,也会积累不必要的消息、工具结果和中间产物。因此,运行框架还必须管理已经进入上下文窗口及其周边的信息。
通过中间件实现这些技术
Agent 在一个循环中运行:模型决定下一步做什么,调用工具,读取结果,再重复这个过程,直到任务完成。中间件是一段接入循环中特定位置的代码,例如 Agent 启动前、每次模型调用前后,或每次工具调用前后。
-
在每个接入点,中间件都可以读取上下文,并在下一步运行前修改它。 -
本文介绍的每一种上下文工程技术,都对应一段接入这些位置之一的中间件。大部分能力已经内置,因此使用它们时不需要自己编写中间件,除非你想定制某些具体行为。
上下文卸载:先别放进窗口
Agent 并不总是需要看到每次工具调用或用户消息中的全部数据,尤其是数据量很大的时候。
例如,每次 pull_market_report 工具调用都会返回一份完整的数据导出,包含数千行。但 Agent 只需要其中几个数字,因此可以让模型只看到对应的几行。

工具结果卸载过程(原文动图静帧,完整动画见文末)
每次调用工具时,FilesystemMiddleware 都会运行:
-
当工具结果超过大约 20,000 个 Token 时,完整结果会在进入对话之前写入 /large_tool_results/{tool_call_id}。 -
模型只会看到一小段预览,也就是开头和结尾的几行,以及对应的文件路径。 -
之后,如果 Agent 需要 B 公司的季度营收,就可以用 read_file 分页读取这个文件。
过大的用户消息,例如直接粘贴进来的通话转录,也会得到类似处理,只是阈值更高,为 50,000 个 Token。这些消息会保存到 /conversation_history/。
摘要压缩:整理已经进入窗口的信息
即使我们尽量卸载冗长的工具结果,长任务运行时,上下文仍会逐渐堆积,例如五家公司的搜索结果、笔记和草稿。摘要压缩可以把 Agent 整个上下文窗口中的内容,浓缩成一份到目前为止的进展摘要,让它能够继续研究。

卸载削平局部尖峰,摘要压缩则让持续增长的上下文回落
-
曲线中的尖峰,来自新进入的大体积工具结果或用户消息。卸载会在模型看到它们之前,用简短预览替换完整内容,让上下文只增加一点。 -
摘要压缩处理的是缓慢累积的部分:当使用量达到 85% 时,较早的消息会被压缩成摘要,上下文占用随之下降。
SummarizationMiddleware 会在每次模型调用之前检查 Token 使用量:
-
一旦超过阈值,默认是模型上下文窗口的 85%,就会通过一次独立的 LLM 调用,把较早的消息压缩成一份摘要。 -
较早的消息会从上下文窗口中移除,最近的消息则原样保留。 -
此时,模型会先看到摘要,再看到最近的消息。因此,近期内容不会被改写。
这里有两个重要细节:
-
可以找回原文。被摘要压缩的消息会写入 /conversation_history/{session_id}.md。如果 Agent 起草报告时需要 A 公司研究中的某个细节,就可以重新读取。 -
可以反复进行。随着任务继续,上下文占用会再次增加,下一轮摘要也会包含上一轮的摘要。
你也可以在话题发生变化时生成摘要,而不只是等到 Token 达到某个阈值。定制摘要提示词也可能有所帮助。
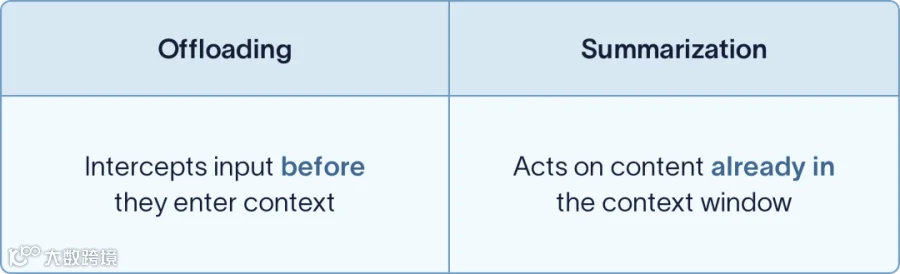
卸载在信息进入上下文前处理输入,摘要压缩处理已经进入上下文的信息
我们关于 Deep Agents 上下文管理的另一篇文章,对这两点有更详细的介绍。
Skills:需要时再加载
假设销售团队对季度业务回顾(QBR)有一套固定格式。Agent 每个季度才需要用一次这些要求,如果一直把它们放在系统提示词中,每次调用都要为此付出 Token 和响应时间的成本。更好的办法是把这些信息打包成一项 Skill。
Skill 是一个存放指令的文件夹,也可以包含脚本和参考文档,为 Agent 完成某项专门任务提供所需内容。
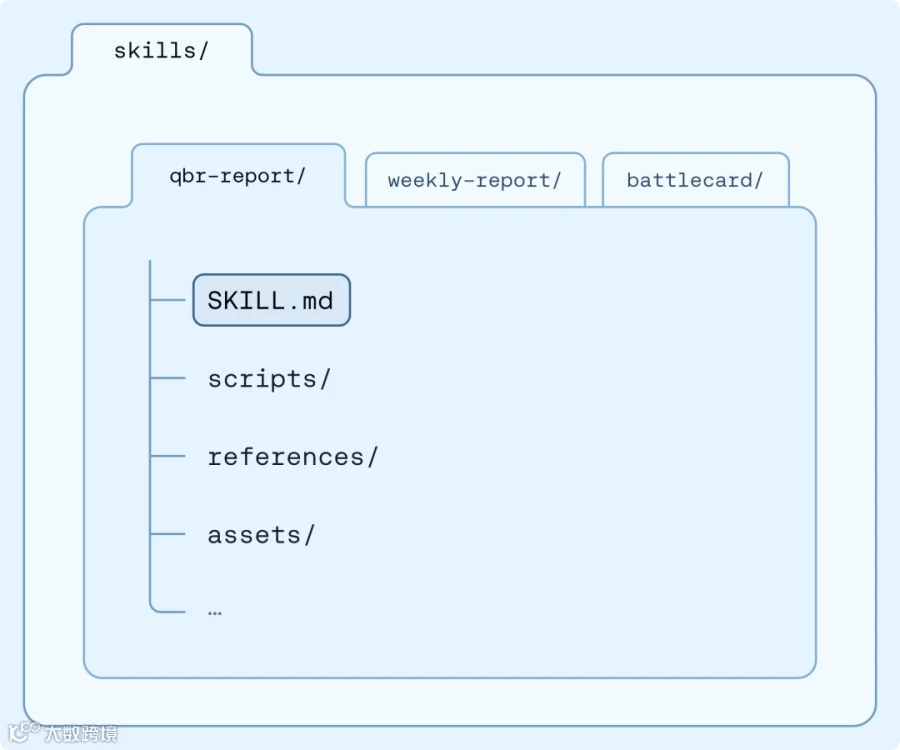
Skill 文件夹的结构
Agent 一开始只会看到一段简短描述。只有真正遇到季度业务回顾任务时,才会加载 qbr-report 的完整指令;处理其他任务时,不会携带这些内容。
Skills 分层加载上下文,因此在某项内容真正相关之前,窗口都能保持精简。这种方式叫作渐进式披露(progressive disclosure):模型先看到“菜单”,需要时再取出完整“菜谱”。所以,十项 Skill 占用的初始上下文,大致相当于十句简短说明。

渐进式披露(原文动图静帧,完整动画见文末)
指定 Skills 所在位置后,SkillsMiddleware 会使用两个钩子:
-
Agent 启动前,扫描 Skills 文件夹,只读取每个 SKILL.md 的头部信息。 -
每次模型调用时,把这些名称和描述加入系统提示词。
只有模型判断某项 Skill 与当前任务有关,并用 read_file 工具读取时,完整指令才会进入上下文。因此,我们的 Agent 在研究过程中不用携带模板,等到需要排版季度业务回顾时再加载。
子 Agent:隔离会产生噪声的工作
卸载能有效应对体积过大的结果。但如果你事先就知道某项工作会产生大量噪声,例如为了研究一家公司而进行数十次搜索、阅读大量页面,那么子 Agent 是一种不错的设计选择。子 Agent 在自己的上下文窗口中完成工作,只返回最终结果,让主 Agent 根本不必接触这些“噪声”。

SubAgentMiddleware 允许我们定制子 Agent 的系统提示词和可用工具。
market_researcher = {
    "name": "market-researcher",
    "description": "Researches a company and returns the 3 most notable developments.",
    "system_prompt": "Use pull_market_report, then return 3 short bullet points. Do not return the raw report.",
    "tools": [pull_market_report],
}

agent = create_deep_agent(model=model, subagents=[market_researcher])
在这个例子中,主 Agent 把每家公司的研究工作交给 market-researcher 子 Agent。
研究子 Agent 在自己的上下文中阅读完整报告,只返回三个要点,因此主 Agent 只会看到这三个要点,连原始报告的预览都不会看到。此外,子 Agent 的任务通常较小、范围明确,因此往往可以使用更便宜的模型,并行运行。
长期记忆:跨对话保留信息
任务结束时,Agent 已经学到了很多东西。有些有用,有些没有。
假设你告诉 Agent:“摘要用项目符号,不要写成段落。”如果没有记忆,你可能每周都要重复一遍。在 Deep Agents 中,长期记忆就是一个 Markdown 文件。你只需要通过一个参数指定这个文件,剩下的事情交给 MemoryMiddleware:
-
加载:在一次运行开始时读取文件。 -
注入:每次模型调用时,把文件内容加入系统提示词。 -
更新:当 Agent 学到值得保留的信息,例如你的格式偏好时,就更新这个文件。
更换模型,保留记忆
Deep Agents 不绑定特定服务商,记忆机制也一样。由于记忆只是保存在你自己的存储中的普通文件,而不是掌握在服务商手里的东西,因此你可以让同一个后端连接另一个模型:
agent = create_deep_agent(
    model="openai:gpt-6",  # different provider, same memory
    memory=["/memories/AGENTS.md"],
    backend=backend,
    store=store,
)
下周,即使换了一个模型,它也可以读取同一份文件,继续用项目符号写摘要。
值得记住的上下文工程策略
无论你使用 Deep Agents、其他运行框架,还是自己搭建,都可以留意以下几点:
-
大体积输入应该卸载,而不是截断。截断会丢失信息,卸载则保留了重新取回的可能。 -
压缩后仍应能找回原文。生成摘要之后,Agent 依然能够重新获取需要的细节。 -
任务知识应按需加载。把所有任务的指令都放进系统提示词,会让每次调用都付出上下文成本。 -
会产生大量噪声的工作应该隔离。子 Agent 使用独立上下文,能让主 Agent 保持专注。 -
记忆应该掌握在你自己手里。存放在自己控制的存储中,更换模型或服务商后仍然可以保留。 -
默认设置应该允许定制。适合某项任务的阈值,很少能适合所有任务。
动手试试
uv add deepagents想跟着讲师现场学习更多内容?我会在 11 月 3 日讲解这个主题,报名入口见文末。
管理上下文只解决了一半问题。另一半是,一开始就把正确的信息取进来。接下来可以阅读我们关于检索的那篇文章。
如果想更深入地学习上下文工程,也可以参加 LangChain Academy 上免费、自定进度的 Deep Agents 课程。
参考链接
-
原文:https://www.langchain.com/blog/context-engineering-deep-agents-remember -
LangChain 上下文工程文档:https://docs.langchain.com/oss/python/langchain/context-engineering -
上下文腐化相关讨论:https://news.ycombinator.com/item?id=44308711 -
上下文工程从检索开始:https://www.langchain.com/blog/context-engineering-starts-with-retrieval -
Deep Agents:https://www.langchain.com/deep-agents -
Deep Agents 的检索与 RAG:https://docs.langchain.com/oss/python/deepagents/rag -
中间件文档:https://docs.langchain.com/oss/python/langchain/middleware/overview
-
Deep Agents 上下文管理详解:https://www.langchain.com/blog/context-management-for-deepagents