


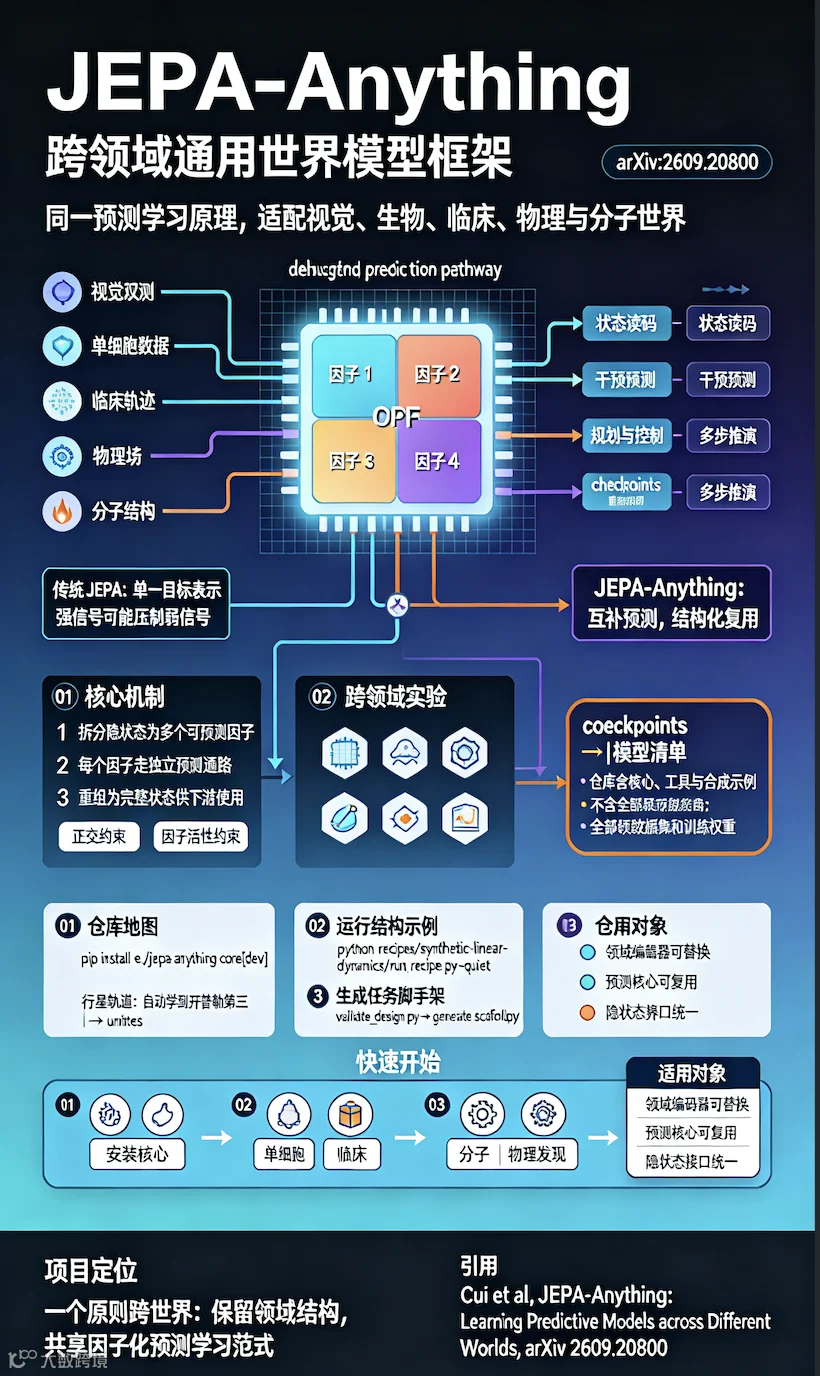
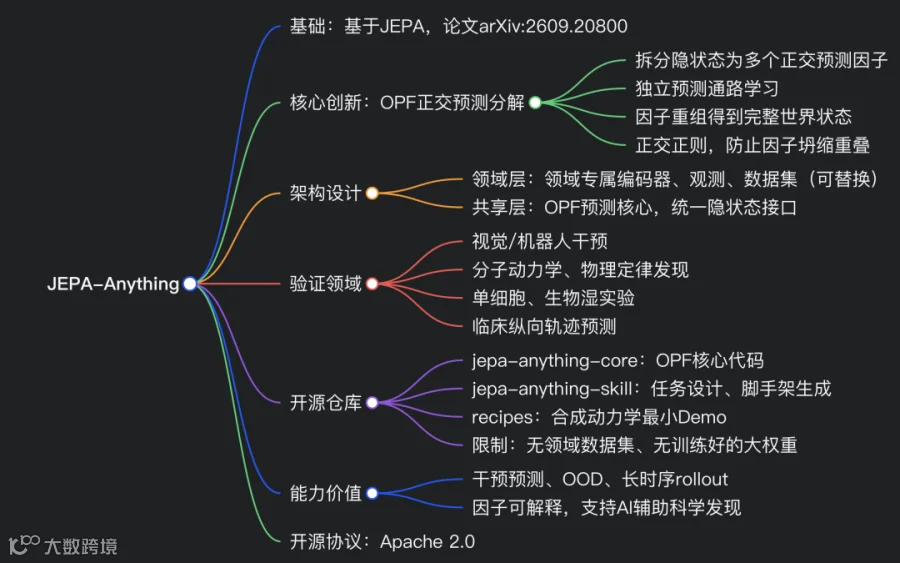
编者摘要:JEPA‑Anything(arXiv:2609.20800)是一套领域无关的通用世界模型开源框架,在 JEPA(联合嵌入预测架构)基础上提出 OPF 正交预测分解作为核心创新。传统 JEPA 将世界状态压缩为单一隐向量,易出现强动力学信号压制微弱科学规律;OPF 把隐世界状态拆分为多个相互正交、具备独立预测通路的因子,各因子单独学习预测任务后再重组为完整隐状态,显著提升干预预测、分布外泛化与长时序推演能力。
框架采用分层解耦设计:领域侧保留专属编码器与观测处理逻辑,OPF 预测核心与隐状态接口全局复用,无需跨领域共享模型权重。项目在视觉、分子动力学、物理系统、单细胞生物、临床轨迹等 7 类完全异质领域完成验证,模型习得的隐因子可对接湿实验,辅助科学发现。
开源仓库仅提供 OPF 核心库、任务脚手架生成工具与合成动力学校验 Demo,不含论文大规模数据集与训练权重,预训练模型托管于 Hugging Face。仓库内置配置校验、自动代码生成与单元测试工具,便于研究者快速将该范式迁移至新领域。
10 个关键问题 Q&A
- Q:JEPA-Anything 是什么?
A:领域无关的通用世界模型框架,基于 JEPA,以 OPF 正交预测分解为核心,可跨物理、生物、临床、视觉等不同领域学习预测世界模型。 - Q:核心创新 OPF(正交预测分解)解决了原版 JEPA 什么痛点?
A:原版 JEPA 使用单一隐向量,强动力学信号会压制微弱但关键的规律;OPF 拆分成正交独立因子,各子动力学单独学习,改善干预、长时序推演与 OOD 性能。 - Q:因子是否需要人工预先定义语义?
A:不需要。因子语义由数据动力学自动学习;训练完成后再反向解析,对接科学实验。 - Q:不同领域之间是否共享编码器与模型权重?
A:不共享领域编码器与领域权重;仅复用 OPF 预测核心与隐状态接口,各领域保留自身观测处理逻辑。 - Q:这个开源仓库是否包含论文里训练好的模型权重和数据集?
A:不包含。仓库只提供核心代码、任务工具、合成动力学结构校验 Demo;预训练权重放在 Hugging Face。 - Q:recipes 下面的 synthetic-linear-dynamics 示例能训练模型跑 benchmark 吗?
A:不能。仅做接口一致性校验,不训练模型、不产生论文的性能指标。 - Q:JEPA-Anything 主要能做哪些下游任务?
A:状态预测、干预仿真、分布外预测、长时序 rollout 推演、表征读取,还可挖掘隐因子用于科学假设与湿实验设计。 - Q:它和普通世界模型(DreamerV3、TD-MPC2)最大区别是什么?
A:目标不是单一环境的控制,而是一套统一学习原理适配完全不同类型的世界,侧重科学发现与跨领域通用预测,不只局限机器人。 - Q:jepa-anything-skill 工具包作用是什么?
A:任务配置校验、自动生成任务代码脚手架、契约测试,降低把 OPF 范式迁移到新领域的工程成本。 - Q:适用场景有什么局限?
A:需要自行准备领域数据集与领域编码器;仓库只提供范式骨架,大规模训练、领域调优需要用户自行完成。
论文标题:JEPA-Anything: Learning Predictive Models across Different Worlds(arXiv:2609.20800) 仓库:https://github.com/Gen-Verse/JEPA-Anything 核心定位:跨领域无关(domain-agnostic)通用世界模型框架,基于 JEPA 改进,核心创新 OPF 正交预测分解,用同一套预测学习原理,为视觉、生物、临床、机器人控制、分子动力学、物理场、天气 7 个完全不同的领域构建世界模型arXiv。
一、核心思想:为什么要做 JEPA-Anything
传统 JEPA(杨立昆提出的联合嵌入预测架构)是单预测头:把整个世界状态打包成一个单一 latent 向量,用一个预测器去预测。
痛点:不同维度的动力学信息(位置、状态、扰动、演化)挤在同一个向量。容易出现强信号压制弱信号:变化剧烈、容易预测的动力学主导梯度,而微弱但关键的物理 / 生物规律会被淹没,干预预测、长时序外推能力变差。
JEPA-Anything 解决方案:OPF Orthogonal Predictive Factorization 正交预测分解
-
将目标隐状态空间拆分为K 个互相正交、互补的子因子(factors)(论文实验 K=4) -
每个因子分配独立的预测通路,单独学习各自的预测任务 -
预测完成后,通过伪逆矩阵把多个因子重新合并回完整的世界隐状态,用于下游读码、干预仿真、长时序 rollout 推演 -
增加三组正则项:正交约束、因子活性约束、编码器方差约束,防止因子坍缩、子空间重叠冗余
重要特点:因子没有预先定义语义,不是人工指定哪个因子负责速度 / 温度 / 基因;因子的含义由数据本身的可预测结构自动学习得到,训练后可以反向解析,对接科学实验。
架构分层(领域适配 + 共享预测核心)
- 领域侧(可替换)
各领域保留自己的观测数据、上下文 - 目标构造逻辑、领域专属编码器(图像、单细胞、病历、分子等),不用统一编码器、不用共享权重 - 共享核心(OPF)
统一的因子化预测内核、统一的隐世界状态接口 一句话:不同领域用各自的编码器,但是共用同一套因子化预测学习范式
二、实验结果(7 大领域验证)
-
动力学任务:全部 10 个对比任务上超过原版 JEPA 基线;Interventional Pong 干预预测误差降低 34.8% -
分子动力学:4 套分子系统,1 步、100 步长时序推演误差均低于对比方法 -
物理发现:行星轨道任务,模型自动学到开普勒第三定律,拟合指数 - 1.4991,理论值 - 1.5 -
生物验证:模型预测的细胞干预方案,在细胞共培养、类器官、肿瘤碎片、小鼠体内湿实验验证有效(IL-18 联合 CD73 阻断抗肿瘤方案) -
临床:对 1000 + 临床事件做纵向轨迹预测;单细胞扰动预测显著优于 scGPT、Cell-JEPAarXiv
三、GitHub 仓库结构(你贴出的目录)
JEPA-Anything
├── .github/workflows        # CI自动化测试
├── assets/figures           # 论文框架图、场景图
├── checkpoints              # 模型权重清单(仓库不含训练好的领域大权重,仅示例未训练checkpoint)
├── docs                     # 架构文档
├── jepa-anything-core       # 【核心包】OPF实现、损失函数、基准、表征诊断(可复用核心)
├── jepa-anything-skill      # 任务设计工具:配置校验、自动生成任务脚手架、契约测试
├── recipes                  # 示例案例:synthetic-linear-dynamics 合成线性动力学(最小可运行demo)
├── README.md / README.zh-CN.md  # 中英文文档
├── pyproject.toml / Makefile  # 工程构建、开发检查脚本
仓库范围说明(重点)
⚠️ 仓库不包含论文里 7 个领域的数据集、训练完成的模型权重;仅提供:
OPF 核心代码库 任务设计工具链 合成动力学的结构校验 Demo(只做接口一致性检查,不训练模型、不跑 benchmark) 预训练权重放在 Hugging Face collection:Gen-Verse/jepa-anything
四、快速上手流程(仓库 Quick Start)
环境要求:Python≥3.10,PyTorch
# 1. 克隆+安装核心库
git clone https://github.com/Gen-Verse/JEPA-Anything.git
cd JEPA-Anything
python3 -m venv .venv
source .venv/bin/activate
python3 -m pip install -e './jepa-anything-core[dev]'

# 2. 运行合成动力学结构校验demo(仅验证接口,不训练)
python3 recipes/synthetic-linear-dynamics/run_recipe.py --quiet

# 3. 校验任务配置 + 自动生成新任务脚手架
python3 jepa-anything-skill/scripts/validate_design.py \
  recipes/synthetic-linear-dynamics/design.expected.json \
  --pretty --output work/quickstart/validation-report.json

python3 jepa-anything-skill/scripts/generate_scaffold.py \
  recipes/synthetic-linear-dynamics/design.expected.json \
  --output-dir work/quickstart/generated-task --config-format json

# 4. 运行自动生成的单元测试
python3 -m unittest discover \
  -s work/quickstart/generated-task/tests -p 'test_*.py' -v

# 一键全量开发检查(代码、测试、demo、清单校验)
make check
五、项目价值与定位
- 世界模型范式升级
:从 “单一体隐空间预测” 走向因子化隐空间预测,解决原版 JEPA 容量分配失衡,显著提升干预、OOD、长时序推演能力 - 跨学科统一建模工具
:一套框架覆盖视觉、生命科学、临床、物理、分子、机器人,支持 AI 辅助科学发现(模型学到的因子可以直接导出湿实验候选干预方案) - 工程化落地友好
:模块化,可插拔接入领域编码器;提供脚手架生成工具,快速在新领域搭建 JEPA-Anything 任务,不用从零重写整套预测逻辑
六、License 与引用
-
License:Apache 2.0 -
BibTeX 引用
@article{cui2026jepaanything,
  title={JEPA-Anything: Learning Predictive Models across Different Worlds},
  author={Cui, Taoyong and Wang, Zhongyao and Xu, Xinyue and Liu, Weiyang and Yu, Zhaochen and Zhang, Yuying and Gao, Qiang and Yang, Mengyue and Ouyang, Wanli and Heng, Pheng Ann and Wu, Yingcheng and Yin, Zhenfei and Yang, Ling},
  journal={arXiv preprint arXiv:2609.20800},
  year={2026}
}