


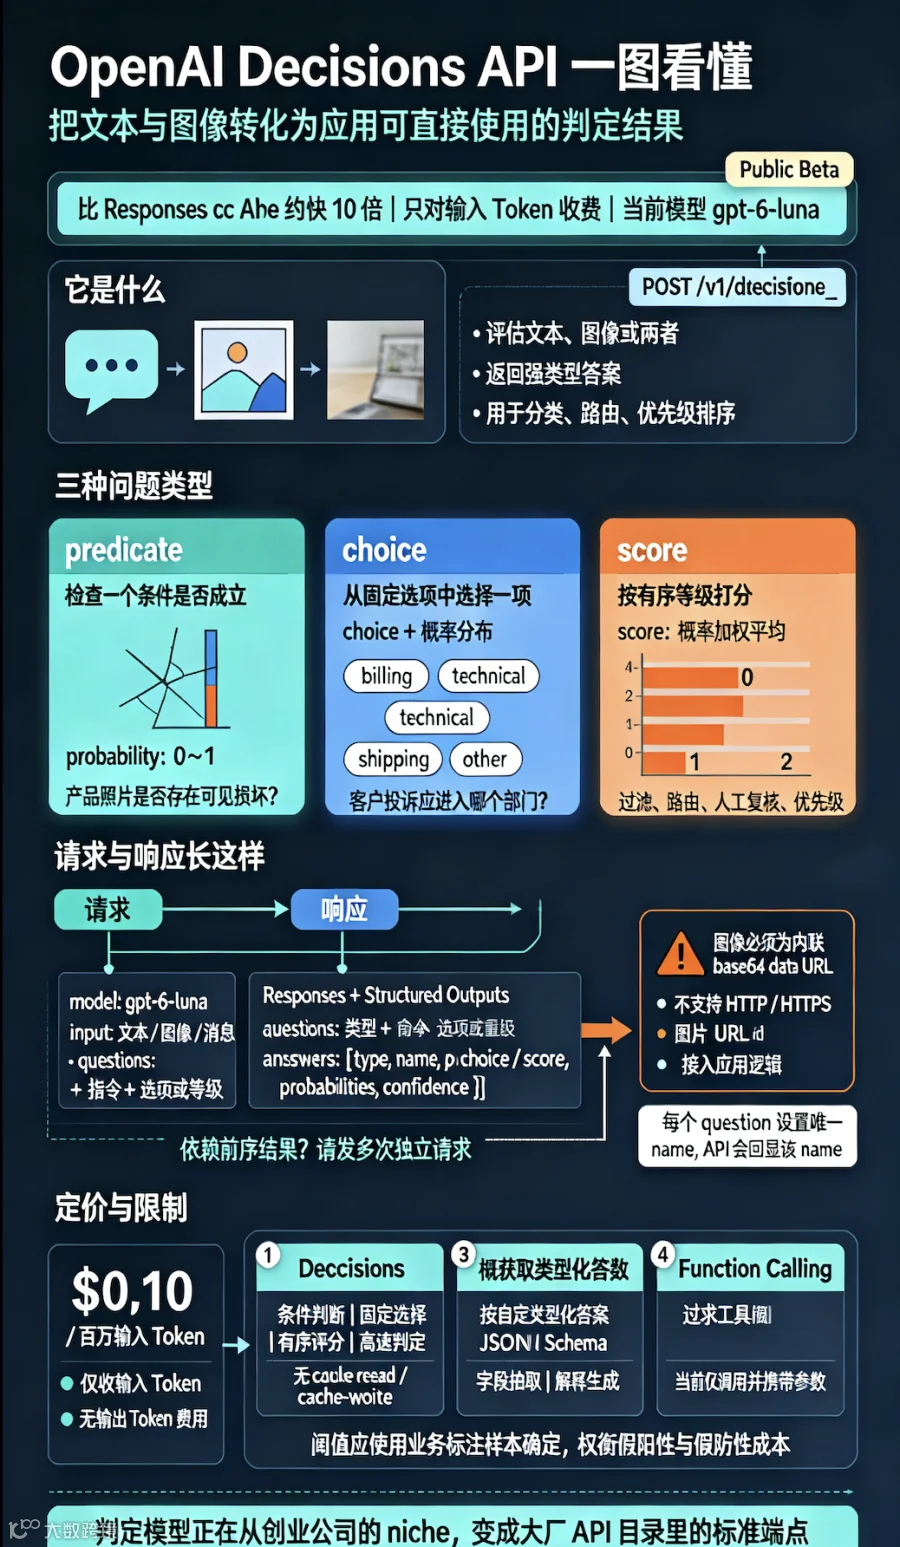
编者摘要:OpenAI 新推出Decisions API,处于公开测试阶段,预计数周内正式 GA,仅支持 gpt-6-luna 模型,独立接口 POST /v1/decisions,判定速度相比 Responses API 提升约 10 倍,面向程序自动化判定场景,支持文本 + 图像多模态输入。
API 请求由模型、输入素材、判定问题三部分构成,内置三类原生判定原语:predicate 条件概率判断、choice 无顺序单选分类、score 有序量表打分。一次请求可并行执行多个独立判定;存在依赖关系的链式判定,则需要分多次调用。图像输入仅支持内联 Base64,不支持外部图片 URL。
定价模式为仅收取输入 Token 费用,0.1 美元 / 百万输入 Token,无输出、缓存读写计费;支持 ZDR 零数据留存、HIPAA 合规,美欧地区支持数据驻留。产品定位清晰,专门承接分类、路由、优先级判定;复杂 JSON 字段抽取用 Responses 结构化输出,工具调用使用 Function Calling。
该 API 与 Jev 产品范式高度同构:同样主打面向代码的轻量化判定,只计费输入。差异在于 Decisions 支持图像,Jev 当前仅文本;价格上 Decisions 约为 Jev 的 2.4 倍。Jev 创始人曾自述,该判定模型理念当年在 OpenAI 内部难以获取资源,如今 OpenAI 自研同类 API,标志判定模型从小众创业赛道进入大厂标准能力。现阶段 Decisions 仍有 beta 限制,落地前需实测错误率与阈值。

对比表:Decisions vs Responses API vs Jev
|
|
|
|
|
|---|---|---|---|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
10 个关键问题 Q&A(围绕 Decisions API)
- Q:OpenAI Decisions API 是什么,核心定位?
A:Decisions API 是 OpenAI 新推出的专用判定接口,当前处于公开 Beta,预计数周内 GA,仅支持 gpt-6-luna。专门面向程序做分类、路由、优先级判定,官方宣称速度比 Responses API 快约 10 倍,返回强类型判定结果。 - Q:Decisions API 提供哪三类判定原语,分别适用场景?
A:① predicate:条件真假校验,返回 0~1 概率;② choice:无序类别单选,返回选中项 + 全选项概率分布;③ score:有序等级打分,输出概率加权得分。 - Q:Decisions API 和 Responses API 该如何选型?
A:业务只需要布尔判断、单选、评级打分,选 Decisions;需要自定义 JSON 抽取、长文本解释、工具调用 Function Calling,使用 Responses API。 - Q:Decisions API 的计费规则是怎样?
A:仅收取输入 Token 费用,0.1 美元 / 百万输入 Token,不收取输出 Token、缓存读写费用;区域溢价、长上下文倍率依旧生效。 - Q:Decisions API 图片输入有什么硬性限制?
A:图片仅支持内联 base64 data URL,不支持外部 HTTP/HTTPS 图片链接、file_id,图片和文本指令放在同一条 user message 一起评估。 - Q:同一个请求能否一次性执行多个判定问题?
A:独立互不依赖的多个问题可以放在同一个 questions 数组,共用同一份输入;判定结果存在前后依赖(链式判定),必须分开多次调用 API。 - Q:Decisions API 和 Jev 有哪些异同点?
A:相同:都面向代码判定场景,原生三类判定原语,只对输入 Token 计费;差异:Decisions 支持图像输入,Jev 仅文本;Decisions 单价约贵 2.4 倍,Jev 原生侧重类型安全语义。 - Q:返回结果里 probability、score、confidence 含义是什么?
A:probability 是条件成立预估概率;score 是等级索引概率加权平均值,可落在两级中间;confidence 代表模型整体置信度,用于业务设置人工复核阈值。 - Q:Decisions API 支持哪些合规能力?
A:支持零数据留存 ZDR;符合资质客户可用于 HIPAA 场景;美国、欧洲(EEA + 瑞士)支持数据驻留与区域处理。 - Q:业务上线前,评估 Decisions 替代方案最关键的验证动作是什么?
A:用真实业务标注数据集,实测假阳性、假阴性率;根据业务损失成本设置判定阈值,横向对比 Decisions、Jev 在同一任务上的准确率与延迟。

OpenAI 直接把「判定」能力独立成 API:每百万输入 token 0.1 美元,只收输入费用。这正好对应昨天 Jev 访谈里的产品形态:概念模型几乎一样,价格贵约 2.4 倍,但额外支持图像输入;官方宣称速度比 Responses API 快一个数量级。
OpenAI Decisions API:与 Jev 架构高度同构
来源:OpenAI 官方文档 + Simon Willison 实操报告与 llm-openai-decisions 插件
核心要点
Decisions API 评估文本 / 图片,返回强类型判定,速度约为 Responses API 的 10 倍。输出三类结果:条件成立概率、固定集合单选、按量表打分,用于内容分类、请求路由、任务优先级。 当前公开 beta,预计数周 GA,仅支持 gpt-6-luna,接口 POST /v1/decisions。SDK 有最低版本要求。
三种问题类型回顾
请求三要素:model、input、questions;返回 answers 数组,每个问题唯一 name 回显。
-
predicate:条件校验,返回 0~1 概率 -
choice:无顺序分类单选,返回选中值 + 全选项概率分布 -
score:有序等级打分,返回概率加权分数
选型分工:三类判定场景用 Decisions;自定义 JSON 结构抽取 / 解释用 Responses 结构化输出;需要工具调用用 Function Calling。
工程落地关键细节
-
图片限制:仅支持内联 base64,不支持外部图片 URL 与 file_id -
链式判定:依赖上一轮结果的逻辑,必须拆成多次 API 调用 -
分类务必增加兜底选项 other,低置信送入人工队列 -
阈值调优:基于业务标注样本,权衡假阳 / 假阴性成本 -
编写提示原则:基于客观可观测标准,多维度拆分成独立 question,选项边界清晰
定价与合规
-
gpt-6-luna:$0.1 / 百万输入 token,仅计费输入,无输出、缓存费用 -
支持 ZDR、HIPAA(合规客户);美、欧支持数据本地驻留
Simon Willison 实操
Simon 基于已有 llm-typesafe(对接 Jev),读取这份 OpenAI 文档开发了 llm-openai-decisions 插件,一行命令就可以图文一起做判定。 示例:判断图片内是否有哺乳动物,返回 predicate 结果 probability:0.0
Decisions 和 Jev 两大核心差异:
-
gpt-6-luna 支持图像输入,Jev 目前只支持文本 -
两者都是仅输入计费:OpenAI $0.1 / 百万 token;Jev $0.042 / 百万 token,OpenAI 价格约贵 2.4 倍。 除此之外 API 设计范式高度同构:Jev 的三类原语(布尔判定、选择、打分)Decisions 全部实现。
为什么这个 API 值得重点关注
昨天刚看完 Diogo Almeida(Jev 创始人)访谈,他提到当年在 OpenAI 内部没法推动这个方向:因为这套 API 的调用方是代码而不是人类,当时得不到资源,于是离职创业,打造面向程序、专注判定、按 token 购买智能能力的判定模型。 现在 OpenAI 把同范式产品放进官方 API 产品线。
三个核心记忆点
-
价格:OpenAI 比 Jev 贵约 2.4 倍 -
多模态:OpenAI 支持图像输入,Jev 暂不支持 -
定位:作为 Responses API 的高速判定通道,不是通用对话模型
一句话总结:判定模型从初创公司小众赛道,正式成为大厂标准 API。
⚠️ 但不能直接等同于 Jev:当前仍在 beta,单模型限制、图片只能 base64 上传;Jev 从 API 形态到语义原生做了类型安全原语设计,OpenAI 目前只是工程实现文档。 评估是否可替代,最务实的方案:在你的分类任务上,同时跑两边,实测阈值与错误率。
将文本和图片转化为应用可直接使用的判定结果,速度比 Responses API 快 10 倍。
Decisions API 可评估文本、图像,或同时评估两者,返回强类型判定结果,性能约为 Responses API 的 10 倍。你可以获取:某条件成立的概率、从固定选项中选出结果、按照评分标准得到分数。基于这些结果,你的应用可以实现内容分类、请求路由、任务优先级排序。
前往 https://platform.openai.com/decisions 试用 Decisions API,在写代码前先调试问题与输入内容。
Decisions API 当前处于公开测试版(public beta),预计未来几周正式 GA(全面可用)。目前仅支持模型 gpt-6-luna,使用独立接口 POST /v1/decisions。
运行下方 SDK 示例,需要使用不低于这些版本的 OpenAI SDK:Python 3.26.0、JavaScript 7.30.0、Go 3.73.0、Ruby 0.101.0、Java 4.78.0。安装文档见:https://developers.openai.com/api/docs/libraries
Decisions 的工作原理
一条请求包含三部分:
|
|
|
|---|---|
|
|
|
|
|
|
|
|
|
返回结果包含 answers数组。给每个问题设置唯一 name用于识别结果;API 会在响应中原样回传这个名称。
选择问题类型
|
|
|
|
|---|---|---|
|
|
|
|
|
|
|
|
|
|
|
|
choice和 score都会返回所有离散选项对应的概率分布。
choice用于无顺序的分类(如部门) score用于有顺序的分级(如严重度),对等级数字索引做概率加权,最终得分可以落在两个等级中间
选型建议:如果你的应用需要上面三类判定结果,就使用 Decisions API。 如果需要生成自定义 JSON Schema 结构化对象(字段抽取、文字说明),使用 Responses API 的结构化输出; 如果需要模型调用工具并携带参数,使用 Function Calling。
案例 1:图片检测可见破损(predicate)
使用 predicate 问题检测产品照片是否存在肉眼可见损伤。请求传入图片,并指定规则识别裂缝、撕裂、凹陷,忽略阴影与包装破损。
IMAGE_BASE64="$(base64 < product.png | tr -d '\r\n')"
curl https://api.openai.com/v1/decisions \
  -H "Authorization: Bearer $OPENAI_API_KEY" \
  -H "Content-Type: application/json" \
  --data-binary @- <<JSON
{
  "model": "gpt-6-luna",
  "input": [{
    "role": "user",
    "content": [
      {"type": "input_text", "text": "Inspect the product in this photo."},
      {"type": "input_image", "image_url": "data:image/png;base64,$IMAGE_BASE64"}
    ]
  }],
  "questions": [{
    "type": "predicate",
    "name": "visible_damage",
    "instructions": "Does the product have visible damage, such as a crack, tear, or dent? Ignore shadows and damage to the packaging."
  }]
}
JSON
示例返回片段:
{
  "answers": [
    {
      "type": "predicate",
      "name": "visible_damage",
      "probability": 0.92
    }
  ]
}
probability 是模型评估该条件成立的概率。你可以自定义阈值,根据概率标记图片进入人工复核。
图像限制:图片必须使用内联 base64 data URL。该接口不支持外部 HTTP/HTTPS 图片链接、file_id。可在同一条用户消息组合 input_text + input_image,让图片和评估指令、上下文一起送入模型。
案例 2:固定选项选择(choice)
choice 问题从你预设选项里选出一个结果,建议给每个选项设置清晰描述,说明适用场景。 示例:客户投诉自动路由
curl https://api.openai.com/v1/decisions \
-H "Authorization: Bearer $OPENAI_API_KEY" \
-H "Content-Type: application/json" \
-d '{
  "model": "gpt-6-luna",
  "input": "I was charged twice for my order.",
  "questions": [{
    "type": "choice",
    "name": "department",
    "instructions": "Which department should handle this complaint?",
    "choices": [
      {"value": "billing", "description": "Payments, invoices, and refunds."},
      {"value": "technical", "description": "Problems using the product."},
      {"value": "shipping", "description": "Delivery and tracking."},
      {"value": "other", "description": "Requests outside these categories."}
    ]
  }]
}'
示例返回片段:
{
  "answers": [
    {
      "type": "choice",
      "name": "department",
      "choice": "billing",
      "probabilities": [
        { "value": "billing", "probability": 0.95 },
        { "value": "technical", "probability": 0.02 },
        { "value": "shipping", "probability": 0.01 },
        { "value": "other", "probability": 0.02 }
      ],
      "confidence": 0.93
    }
  ]
}
返回的 choice是你预先定义的值,同时附带全部选项的概率分布和整体置信度 confidence。
最佳实践:分类一定要增加兜底选项(例如 other),无法匹配的结果送入人工复核队列。
案例 3:按评级量表打分(score)
score 问题根据有序等级评估输入内容。定义每一级的判定标准,从低到高排列等级。 示例:评估问题严重等级
curl https://api.openai.com/v1/decisions \
-H "Authorization: Bearer $OPENAI_API_KEY" \
-H "Content-Type: application/json" \
-d '{
  "model": "gpt-6-luna",
  "input": "Export fails in Safari but works in Chrome.",
  "questions": [{
    "type": "score",
    "name": "severity",
    "instructions": "How severe is this issue?",
    "levels": [
      {"label": "Cosmetic", "description": "Appearance only; no lost functionality."},
      {"label": "Workaround available", "description": "A task fails, but another way works."},
      {"label": "Fully blocked", "description": "A task fails with no workaround."}
    ]
  }]
}'
示例返回片段:
{
  "answers": [
    {
      "type": "score",
      "name": "severity",
      "score": 1.1,
      "probabilities": [
        { "value": 0, "label": "Cosmetic", "probability": 0.1 },
        { "value": 1, "label": "Workaround available", "probability": 0.7 },
        { "value": 0, "label": "Fully blocked", "probability": 0.2 }
      ],
      "confidence": 0.55
    }
  ]
}
等级索引从 0 开始。本例:0 = 外观瑕疵,1 = 存在替代方案,2 = 完全阻断。返回的 score 是概率加权平均值,因此可以落在等级之间。本例 0.1、0.7、0.2 的概率算出得分 1.1。 结果同时包含置信度与每个等级的概率分布。score 用来汇总分级分布;如果只需要单独选中一个类别,请使用 choice。
一次性执行多个问题
将互相独立的多个问题放到同一个 questions 数组,共用同一份输入素材。例如产品照片,一次请求同时完成破损检测 + 产品分类,每个问题可以使用不同类型。
如果判定依赖上一轮的结果,需要分多次独立请求。例如:先检测是否破损,再根据结果判断是否需要请求维修分类。
编写问题建议:围绕可观测、客观标准描述;不同关注点拆分成独立问题;选项含义清晰区分;评分等级相邻两级要有明确可分辨标准。
解读返回结果
-
predicate 返回条件成立的预估概率 -
choice 和 score 返回概率分布,外加独立的 confidence(置信度)字段
使用业务标注样本,设置路由、过滤、人工复核的阈值。阈值选择需要权衡假阳性、假阴性带来的业务成本。
定价与合规
gpt-6-luna:输入 token 0.1 美元 / 百万 token。仅收取输入 token 费用,无缓存读写、输出 token 费用。区域处理溢价、长上下文输入倍率照常生效;该价格仅适用于 /v1/decisions。gpt-6-luna 其他接口请求,按原有定价执行。
支持零数据留存 ZDR;符合资质客户可用于 HIPAA 场景。美国、欧洲(欧洲经济区 + 瑞士)支持数据驻留与区域处理。详见数据文档查看准入条件、协议与限制。
语音控制扩展
参考文档:https://developers.openai.com/api/docs/guides/decisions-voice,可从语音请求识别动作并向用户返回判定结果。