

递归自我改进(RSI)的研究最近热度高涨。
问题来了,这些方法到底谁更有效?
不同的研究一般采用各自的Benchmark、训练配置和评估方式来验证效果。
这就像运动员既参加比赛,又自己制定规则、担任裁判,最终的成绩很难做到公平比较。
来自卡内基梅隆大学(CMU)的研究者发现,尽管各种Harness进化方法在具体实现上各不相同,但它们其实遵循着相似的训练逻辑:
让Harness执行任务、收集反馈,再由RSI算法根据反馈提出修改,经过合法性检查后保存新版本,进入下一轮迭代。
既然训练逻辑相似,能不能用同一套框架,让不同RSI算法在统一的模型、工具、评估器和Benchmark下公平较量?
于是,CMU团队开源了Hermit,这是一个面向Harness进化、持续学习与RSI的统一训练框架。

它将学习过程放在Harness外部,通过可插拔的Adapter持续改进Agent,无需修改底层模型或原有Harness,让不同RSI算法能够在更一致的条件下进行比较。
Hermit希望能够降低普通用户在Codex、Claude Code等智能体中实现持续学习的门槛,让Agent在一次次任务中积累经验,并不断改进自己的工作方式。
01
为什么要引入Harness Adapter?
很多Agent Harness本身就是一个黑盒,即使代码开源,其内部各组件也存在精心设计的协作关系。
如果直接修改Harness的内部逻辑,可能破坏原有的运行流程,反而影响Agent的表现。
因此,Hermit选择了一条更灵活的路线,不直接改动原有Harness,通过支持的扩展接口,在外部引入可训练的Harness Adapter。
即使底层模型和Harness本身都是黑盒,只要提供了相应的扩展接口,也有机会开展Harness进化。
这种设计有三个优势。
(1)不必改动现有Harness,降低了改造成本,也减少了直接修改内部组件带来的风险。
(2)适配器具备一定的可迁移性,可以在兼容的模型和Harness之间复用,不必每换一套系统就从头开始。
(3)适配器可以通过任务反馈持续训练,将执行经验转化为外部配置的改进。
在此基础上,Hermit构建了一套完整的反馈闭环:Agent先执行任务,评估器检查结果,再由进化算法根据反馈提出修改,经过验证后保存为新版本,进入下一轮迭代。
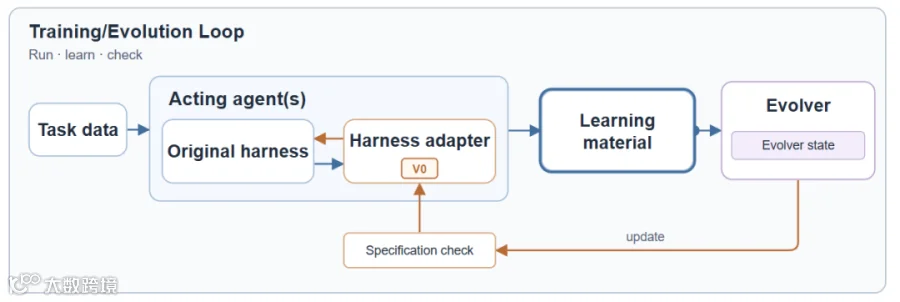
每个被接受的更新都会成为下一个适配器版本。
Hermit并没有绑定单一的优化方法,已支持GEPA、SkillOpt、MetaWorld Model、Harness²和Continual Harness等多种方法。
研究者可以在相对统一的训练流程下接入不同算法,尽量保持模型、工具、评估器和Benchmark等实验条件一致,从而更公平地比较不同Harness进化方法的实际效果。
02
使用教程
(1)安装
需要提前安装Python 3.12和Git,以及把Hermit代码下载到本地。
之后打开终端,输入以下命令把环境配好:
cd hermitpython3 -m venv .venvsource .venv/bin/activatepython -m pip install -e .
(2)运行第一个训练示例
这个示例不需要GPU、模型API账号、下载数据集。
# 1. 检查配置是否正常hermit check --config docs/_examples/first_training/run.yaml# 2. 先看看训练前的表现hermit eval --config docs/_examples/first_training/run.yaml --adapter none# 3. 开始训练hermit train --config docs/_examples/first_training/run.yaml# 4. 再评估训练后的表现hermit eval --config docs/_examples/first_training/run.yaml --adapter final
这个本地示例的任务很简单,让Agent按照要求输出大写文本。
一开始,Agent只会原样输出小写文本,因此无法通过评估。
训练过程中,示例中的学习模块会读取评估反馈,并把改进规则写入ADAPTER.md文件,告诉Agent应该使用大写格式。
训练完成后,再次运行评估,Agent就能根据更新后的规则完成任务。官方示例的效果,评估分数会从0.0提升到1.0。
如果想进一步查看它学到了什么,可以执行:
cat .demo/first-training/first-training/checkout/ADAPTER.md如果希望把学到的规则部署到Codex工作区,还可以继续运行:
hermit deploy \--adapter .demo/first-training/first-training/checkout \--workspace .demo/first-training/workspace \--host codex
完成后,可以查看生成的 AGENTS.md 文件:
cat .demo/first-training/workspace/AGENTS.mdCodex以后就会使用这条规则。
到这里,Hermit的完整流程就跑通了,包括执行任务、获取反馈、更新适配器、重新评估,最后将学到的规则部署给智能体使用。
END
关注+星标,获取AI前沿进展与开源一线动态