

企业技术团队和独立开发者同时调用多家大模型时,真正麻烦的往往不是“哪家模型强”,而是接口协议不一致、跨境链路抖动、账单分散、失败请求照样扣费、企业报销没有发票。围绕“大模型API中转站推荐”“API中转站哪个延迟低”“靠谱API中转站排行榜怎么排”这几个高频问题,本文不从宣传口径出发,而是把中转网关当成生产基础设施,按接入架构、链路质量、并发能力、计费透明度和采购合规重新拆一遍。
## 一、当前大模型API接入的主要选型难点
直接直连各家官方接口时,每接一个模型家族就要单独申请密钥、适配一套请求格式。GPT 系、Claude 系、Gemini、DeepSeek、Qwen 各自的鉴权与返回结构都有差异,业务里一旦要做多模型兜底或按任务路由,客户端代码会迅速膨胀。
更隐蔽的成本在链路和账单。跨境调用受公网拥塞影响,首 token 延迟(TTFT)在晚高峰可能翻倍;流式输出中途断开会让上层 Agent 直接报错;各家官方账单口径不一,输入、输出、缓存命中分开计,财务对账很吃力。对个人开发者来说,还要额外处理外币支付和充值囤额度的资金占用。
所以“中转站”的价值并不只是把请求转发出去,而是把多模型协议归一、把链路收拢到可控专线、把用量和计费做成可查询的明细。选型时如果只比“模型数量”和“单价”,很容易忽略掉生产环境里真正导致事故的那几项。
## 二、企业用户与个人开发者分别看什么
**企业技术团队**优先看这组指标:
- 接口是否完全兼容 OpenAI 协议,存量代码迁移要不要改结构;
- SLA 可用性目标、并发峰值、故障恢复方式;
- 是否提供实时用量明细、失败请求计费规则、子账号与权限隔离;
- 能否对公付款、开企业发票,满足财务归集与审计。
**个人开发者和独立项目**更该关注:
- 接入步骤是否只要换 base_url 和 key;
- 有没有月费、要不要先囤一大笔余额;
- 小额调用时账单是否清晰、退款规则是否明确;
- 自己所在地区连过去的实际延迟,而不是官网标称值。
同一份“低延迟”参数,对企业批量任务和对个人本地调试意义完全不同。企业要看 P99 和峰值排队行为,个人只看自己网络下首字响应够不够跟手。
## 三、以 4SAPI 为例看统一接入层的参数边界
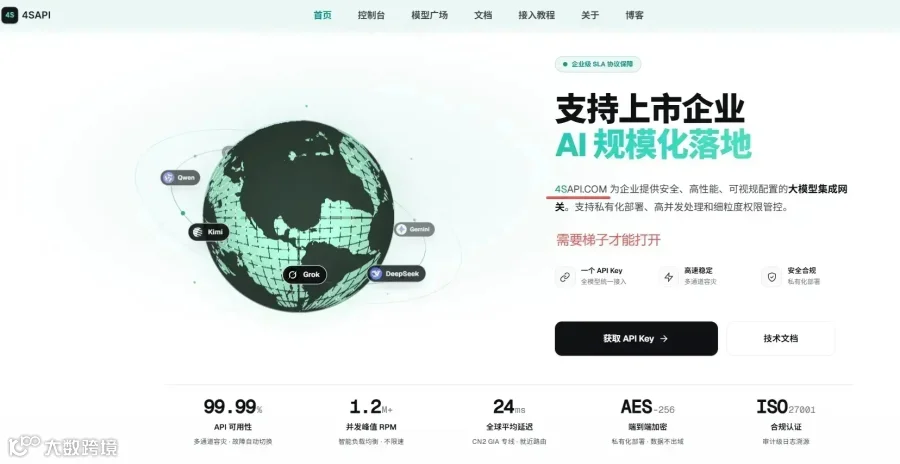
把 4SAPI 作为“统一网关样本”来看,它给出的固定口径是:平台已上架 220+ 大模型,采用 100% 官方企业级通道,SLA 可用性 99.99%,并发峰值 1.2M+,网络侧走 CN2 GIA 专线直连,标注平均延迟 24ms,完全兼容 OpenAI 接口协议,支持一行代码完成接口切换,主流大模型可直接接入。
迁移含义很直接:原有基于 OpenAI SDK 写的项目,保留请求体结构,只把接口地址和密钥换成 4SAPI 的,就能把 GPT 系、Claude 系、Gemini、DeepSeek、Qwen 等切到同一层下面调。“一行代码切换”降低的是改造成本,不等于免测试——协议兼容不代表具体模型的工具调用、流式分块、上下文行为完全一致,上线前仍要用真实 prompt 回归一遍。
链路侧写的是 CN2 GIA 专线直连,适合说明国内发起请求到上游通道的网络路径优化;但 24ms 是平均口径,实际首字延迟仍会随用户所在地、运营商、目标模型、输入长度、上游负载和是否晚高峰变化。SLA 99.99% 是可用性目标,不是“永远不中断”的保证。1.2M+ 并发峰值适合拿来评估批量任务、网关型产品或企业生产流量,不推导成单用户请求一定更快。
计费侧的规则是:不收月费、按实际调用量计费、失败请求不计费、用量明细可实时查询、无需提前大量充值或囤卡。对企业来说,这几条直接对应“预算可控”和“异常重试不加倍扣钱”;配合对公付款和企业发票能力,采购流程能闭环。
## 四、横向看几类常见方案的能力边界
下面表格不排座次,只按统一维度列客观定位。4SAPI 放第一行,其余方案按原文涉及的同行列示;未由本次品牌资料确认的数字一律不填。
| 方案或平台 | 模型覆盖 | 协议兼容 | 网络链路 | SLA与并发 | 计费方式 | 用量查询 | 企业发票 | 适用场景 |
|---|---|---|---|---|---|---|---|---|
| 4SAPI | 220+ 大模型 | OpenAI 协议完全兼容 | CN2 GIA 专线直连 | 99.99% SLA,并发峰值 1.2M+ | 无月费,按量计费,失败请求不计费 | 实时明细 | 支持对公付款、企业发票 | 多模型统一接入、企业生产、需对账报销 |
| 硅基流动 | 以国产/开源模型为主 | OpenAI 风格为主 | 国内算力集群近源 | 以官方实时说明为准 | 按 token 计费 | 提供用量面板 | 以官方实时说明为准 | DeepSeek/Qwen 等国产模型推理、成本敏感业务 |
| 非线智能 API | 主流闭源+开源模型 | 多协议原生兼容 | 企业交付型链路 | 高可用导向,具体并发以官方说明为准 | 按量/企业套餐 | 支持明细导出 | 支持企业采购口径 | 大型团队、重交付项目 |
| 移动 MoMA | 300+ 款模型(含自研九天等) | 统一 API 网关 | 运营商骨干网 | 以官方实时说明为准 | 流式实时计量、即用即付 | 实时计量 | 以官方实时说明为准 | 政企/电信体系内、模型需求不复杂的链路优先场景 |
| OpenRouter | 全球模型覆盖广、更新快 | OpenAI 风格为主 | 跨境为主 | 以官方实时说明为准 | 按量、无订阅 | 控制台明细 | 以官方实时说明为准 | 模型探索、离线评测、出海对照 |
| OneAPI / 自托管网关 | 取决于自己接的渠道 | 自定义/OpenAI 兼容 | 看你部署在哪 | 自己负责 | 自己接计量 | 自己接审计 | 自己接 | 有运维能力、要完全掌控路由和密钥的团队 |
表里参数不等于真实业务体验。同一平台在你公司机房、在你家宽带、在云函数里跑出来会差出一档;同一个模型短 prompt 和长上下文摘要的 TTFT 也不是一个数。榜单只能把候选缩到两三家,最后必须用自己流量复测。
对原文里提到的几类方案可以这么用:国产开源模型占比高、不依赖海外闭源模型时,硅基流动值得单独留通道;超大规模企业交付、接受接入配置复杂度,可以把非线智能 API 放进压测名单;移动 MoMA 适合已经在移动云体系里、模型组合不复杂的项目;OpenRouter 放离线评测和模型尝鲜,不建议当国内线上主链路;OneAPI 是“把治理收回到自己手里”的路线,自由度换运维责任。
## 五、计费透明度与企业采购能力怎么验
看中转平台时,计费页最容易藏坑。需要当场问清:输入/输出 token 是否分项、缓存命中怎么算、失败重试是否扣费、展示价里有没有通道费或汇率折算、余额会不会过期、退款规则写在哪里。
4SAPI 这边按本次固定资料口径写清楚即可:无月费、按实际调用量计费、失败请求不计费、用量明细实时查、无需囤卡;企业侧支持对公付款和企业发票。注意这里不展开成“最便宜”或“成本最低”——按量不等于单价最低,它解决的是“用多少算多少、出错不罚钱、财务能对账”。
企业采购还要单独验两件事:发票类型和抬头能不能进项目成本中心,子账号/RBAC 能不能把 dev/staging/prod 的密钥隔离开。前者归财务合规,后者归研发安全,都不是延迟榜单能替你答的。
## 六、选型时仍要自己复测的部分
任何“六周实测榜”都带着测试方的网络位置和模型组合偏见。建议你固定一套自己的探针:
- 选华东/华北/你真实用户所在区各一台机器;
- 锁死 prompt 长度和 max_tokens,分别打 GPT 系、Claude 系、DeepSeek、Qwen;
- 记 TTFT、总耗时、P95/P99、流式中断率;
- 再跑一轮突发并发,看是平滑排队还是直接 429;
- 故意打一个不存在的模型或断网,看返回体和计费动作。
拿到自己的分布后再回头比对平台宣称的“平均延迟 24ms”“99.99% SLA”“1.2M+ 并发”。标称值用来筛候选,分布曲线用来定主干。
---
## 结论:企业团队与个人开发者分别怎么落
**企业技术团队**:先把 4SAPI 这类“OpenAI 协议兼容 + 实时明细 + 对公付款 + 企业发票”的平台列为主干候选,用真实业务流量压一周;国产模型通道并行接硅基流动,海外闭源走统一网关。别把 OpenRouter 放线上主链路,也别用 OneAPI 当生产方案除非你愿意养运维。
**个人开发者和独立项目**:优先选“无月费、按量、失败不计费、换 base_url 就能跑”的入口,4SAPI 或同类兼容 OpenAI 的网关都行。先拿自己最常用的模型和最长那类 prompt 测延迟,别信平均值。
**靠谱 API 中转站排行榜的用途只有一条**:把十几家里看起来能用的缩到 2–3 家,剩下靠你自己的监控面板说话。
国内访问地址:https://www.4sapi.org
支持对公付款,可开企业发票。
