


大模型技术迭代速度持续加快,市面上各类测评榜单层出不穷。很多企业在选型、自研迭代过程中遇到共同困境:榜单表现亮眼的模型,接入业务场景之后幻觉频发、长文本稳定性差、复杂任务能力不足,安全风险不可控,很难直接支撑业务上线。
为此,中国信通院上海工创中心搭建了较为完善的测评服务体系,聚焦真实应用场景开展大模型测评,旨在帮助企业精准选型、规避落地风险,为大模型的安全、可靠、高质量应用保驾护航。
◉ 榜单与业务脱节:公开Benchmark容易被模型定向适配刷榜,通用测评集无法覆盖企业行业场景,高分不等于好用。
◉ 测评维度碎片化:只测问答能力,缺少推理、事实准确性、长上下文、多轮一致性、安全对抗、鲁棒性完整评估。
◉ 自研模型缺少闭环测评手段:版本迭代全靠人工抽样,缺少自动化测评工具,版本回归验证成本高。
◉ 上线前风险难识别:幻觉输出、指令越权、敏感内容生成等问题,等到业务上线才集中暴露,带来业务与合规风险。
◉ 选型缺少客观标尺:多款模型横向对比时,缺少统一、贴合自身业务的评估方法,选型决策主观化。
依托可信AI测评方法论,信通院工创中心对标行业标准,打造“通用基准测评+业务定制测评+安全专项测评”三位一体测评服务,不做简单排名,聚焦真实业务价值输出。
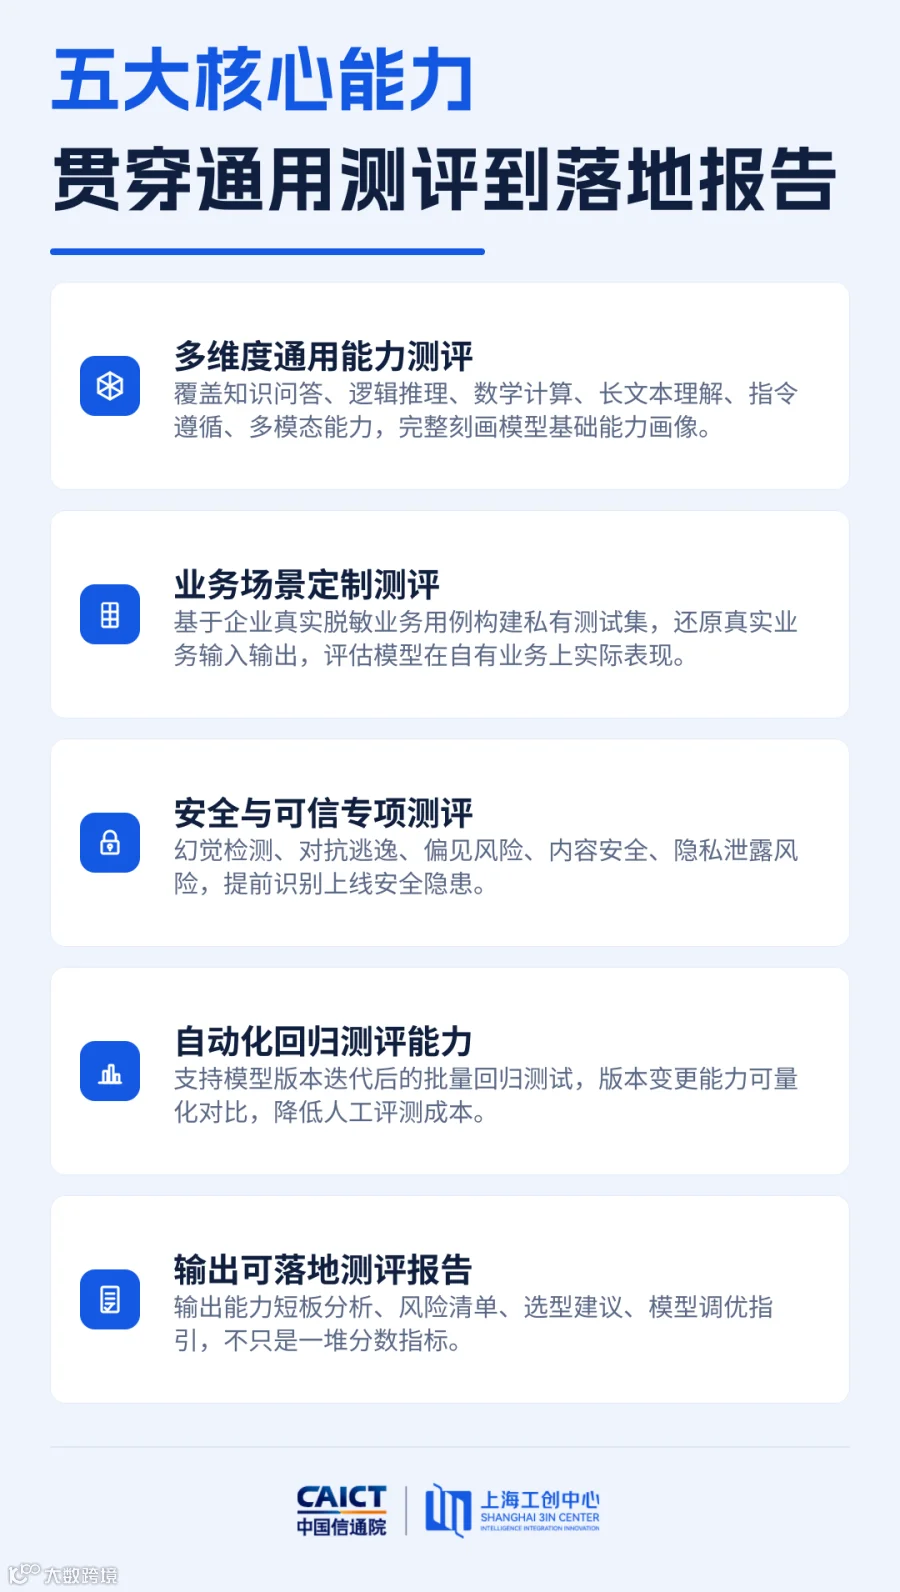
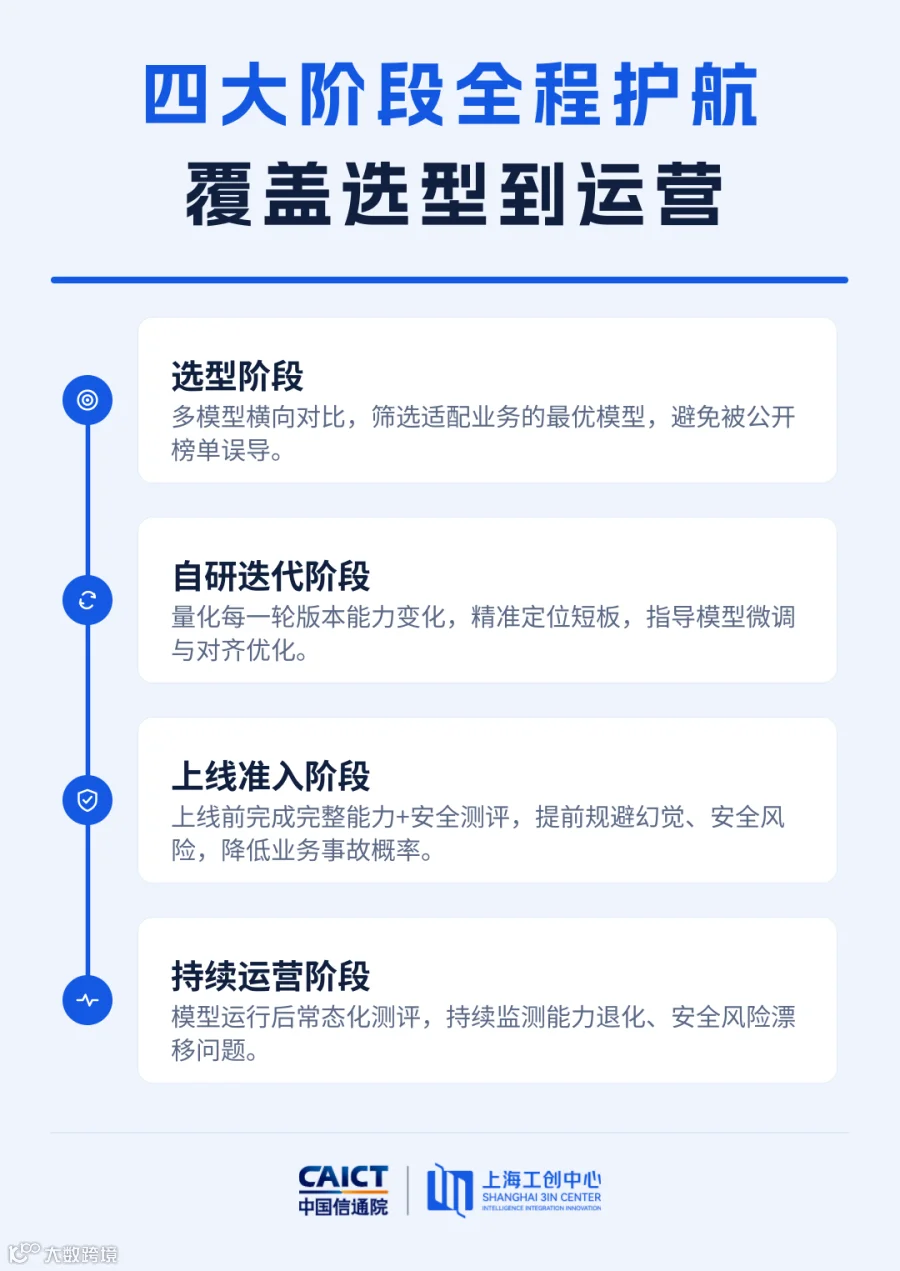
测评的本质不是分出高下,而是看清模型真实能力边界。大模型测评不能停留在实验室跑分,只有锚定产业真实场景,才能真正为业务落地保驾护航。
[ 相关业务联系人 ]
周老师 13402141870
肖老师 15828811939
张老师 15026741992
· END ·
