

我前段时间在自己的朋友圈和线下沙龙让亚马逊卖家做了一份问卷调查,如果你参加了这个沙龙或者你是我的微信好友话,你很有可能看过这个问卷。
先说明一下样本:下面这组数字来自前段时间一次分享会的69份问卷,不是全行业普查,但2-20人的小团队占了76.8%,很像我们身边的大多数卖家。

图1:核心判断,卡点在方法,不只在数据
这组数字先说清一件事:卡住大家的不是不用AI,而是AI没变成团队的方法。方法沉淀和执行链路的卡点,远高于数据底座本身。
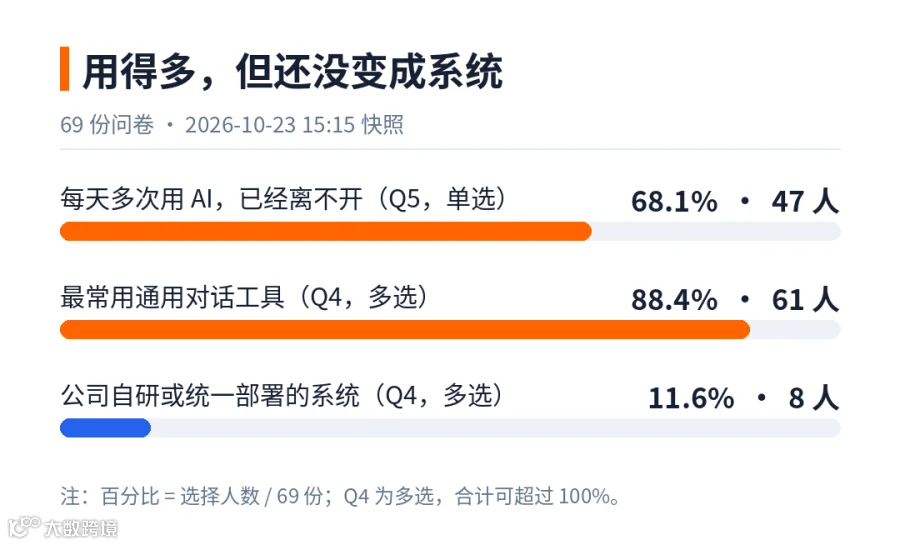
图2:用得多,但还没变成系统
每天多次用AI的人已经很多,可真正有统一系统的人很少。这就是反差:工具人人都在用,方法却还留在个人手里。
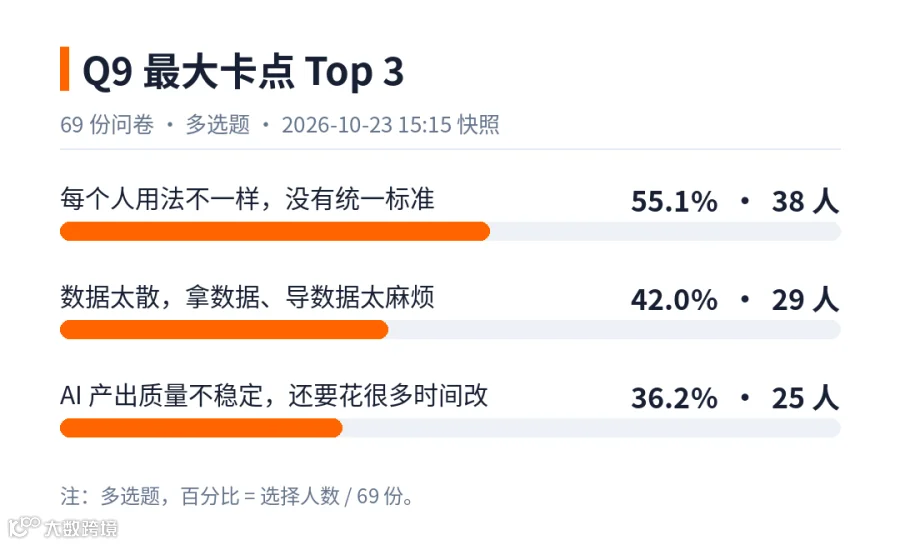
图3:Q9最大卡点Top 3
AI策略失败,不一定是技术不行。很多时候是基础没打对,技术跑得越快,错得越像回事。下面这5件不要做的事,是我自己踩过、也看身边卖家反复踩的。
一、不要从技术出发,要从业务问题出发
最容易犯的顺序是反的:先看到一个很炫的工具、一个很强的模型,再回头找它能干什么。
演示都很漂亮,谁也不想当那个错过下一波技术的人。但AI策略不应该是一张技术可能性清单,它应该是对真实业务问题的回答。
上之前先问清楚:到底要改善什么?是广告决策太慢、太靠感觉?是listing改来改去、转化一直上不去?是补货、调价、看数这些环节太耗人?还是根本不知道钱亏在哪一环?
以及,怎么算成功?是ACoS降下来,是TACOS更健康,是转化率上去,还是同样的人能管更多的链接?
不是每个问题都需要AI。有时候把规则写清楚、把流程理顺、做一个普通的自动化,效果更好,成本只是零头。
目标不是“上AI”,是让生意变好。
二、不要以为数据接进来,AI就懂了
这是最被低估的一坑。
很多人以为,只要把数据连到AI上,问题就解决了。再不行,就在数据湖上面套一个大模型。不是这样的。
亚马逊的数据本来就是散的:广告报表、店铺销售、SQP、搜索词、库存、退款,各在一处,口 径还不一样。ACoS和TACOS混着看,SP 7天、SB/SD 14天的归因窗口混着比,AI给你的解释会非常流畅,也非常可能是错的。
问卷里的数据很直白:76.8%的卖家数据还存在个人Excel和文件里,63.8%没有统一的团队工具。AI缺的不是数据,是“这个数是什么意思、能不能比”的上下文。
AI被问到一个跨店铺、跨市场、跨职能的问题时,它需要的不是更多的数字,而是这些数字代表什么、比较本身合不合理。没有这个,AI就会基于一次误比,给出一个很有说服力的错误结论。
这不是说数据要完美了才能上AI。而是说,数据底座要配得上这个用途。用得越跨来源、越跨职能,底座就越重要。
在我看来,搭系统之前有5个东西必须先统一:数据、口 径、规则、流程、评估。数据准备、口 径统一、治理,不是上AI之前的杂活,它本身就是让AI可用、可信的一部分。
在“让AI”更聪明之前,先确认它依赖的信息是不是配得上这个任务。
三、不要把演示当成业务价值
一个AI演示可以很惊艳:写listing、做图片、调一次竞价,几分钟就出结果。
但演示成功不等于业务成功。真正的考验在日常里:输入不一致、例外情况、权限、库存断货、价格变动、旺季流量波动,还要天天稳定地跑。
一个原型只证明了“这事可能”,没证明“这事值得”。
规模化之前,问自己三个问题:
-
• 它解决的是一个真实的业务问题吗?
-
• 在真实条件下,它够稳吗?
-
• 算上实施和长期运营的全部成本,价值还划算吗?
做实验当然重要,不是每个试点都要马上赚钱,早期的试点能学到东西就值。但探索的标准和规模化的标准应该不一样。
不要规模化让人惊艳的东西,要规模化能持续创造价值的东西。
四、不要让AI变成一堆互不相干的实验
实验应该鼓励,每个小组都需要自己去发现AI能用在哪。
问题出在每个人各自为政,没有一张总图:一个人买个工具写listing,一个人做个Agent调广告,一个人又搞个做图的试点,而且每个人agent的逻辑完全不同。单个看都有道理,合在一起就是能力重叠、成本重复、治理分散、互相接不上。
问卷里有个数字比数据问题更扎眼:方法沉淀和执行链路的卡点占了88.4%,高于数据底座的42.0%。也就是说,很多团队卡的不是没数据,是经验没变成团队标准,新人来了还是靠问、靠跟、靠开会。
解法不是把所有实验都收归中央、用委员会拖慢所有人。而是先定几条共用的原则:业务负责人是谁、数据口 径怎么定、权限怎么管、结果怎么评估。能复用的能力,就不要每个组重新造一遍。
本地可以大胆试,但要按全公司的样子去建。
本地实验,整体思考。
五、不要以为模型越强,结果越好
现在市场总在比模型、比榜单、比谁又发了新版本。模型选择重要,但它只是等式的一部分。
最好的解法取决于任务本身、能拿到什么信息、要多高的准确率、出错的代价多大、长期运营成本多高。有些任务需要深度推理,有些用更小、更快、更便宜的模型就够了,有些甚至普通规则自动化就是最优解。
给模型什么信息、在什么上下文里运行、输出怎么评估,这些跟模型本身一样重要。再强的模型,也补不上缺失的业务上下文、互相矛盾的数据源,和一个本身就没定义清楚的问题。
所以战略问题不是“哪个模型单项最强”,而是“技术、数据、流程的哪种组合,能以可接受的成本和风险,交付你要的结果”。
不要优化最炫的AI,要优化最好的业务结果。
最值得投的,往往不是最显眼的
这5个坑其实讲的是同一件事:大家都盯着看得见的东西,模型、平台、Agent、演示,却低估了把能力变成业务价值的那部分工作。
那部分工作包括:定义对的问题、准备可靠的信息、建立适当的控制、把方案接进真实流程、衡量到底改变了什么。
没有一项比发布一个新AI助手更激动人心。但它决定了那个助手最后是变成一个有用的业务能力,还是停留在演示阶段的又一个实验。
AI越往能查信息、能用工具、能做复杂任务的系统走,我们把越多责任交给它,就越要搞清楚:它用的信息是什么、它影响的决策是什么、它的边界在哪。
这不是说要等到一切完美才动手。而是说:投得更谨慎一点,学得快一点,在有效的东西上继续建。
最后,公司真正投入AI转型之前,问自己5个问题
-
• 是不是在解决一个真实的业务问题?
-
• 数据配得上这个用途吗,口 径能不能比?
-
• 除了演示好看,有没有在真实条件下证明价值?
-
• 能不能放进一个统一、可管理的体系,而不是又一个孤岛?
-
• 选的是最适合这个任务的组合,还是只是最强的技术?
答案可能指向一个Agent、一个新平台、一个更简单的自动化,或者先投数据底座。哪一个都可能是对的。
因为目标从来不是为了投AI而投更多AI,而是投那些能让AI持续交付业务价值的能力。
赢的不一定是花钱最多的团队,而是最清楚什么值得投、什么必须先到位的团队。