

AI TIME 欢迎每一位 AI 爱好者的加入!
本文作者|娄蒙
本文编辑|蒲诗瑶
ICML 2026
论文题目:Parameters as Experts: Adapting Vision Models with Dynamic Parameter Routing
作者:Meng Lou, Stanley Yu, Yizhou Yu
论文链接:
https://arxiv.org/abs/2602.06862
代码链接:
https://github.com/LMMMEng/ParaX
传统视觉 PEFT 的两大核心瓶颈
为什么 adapter 在分类任务上表现亮眼,到了检测分割等密集预测场景就力不从心?论文通过系统分析,指出了现有方法的两大根本性缺陷:
1. 输入无关的静态权重,表征能力先天受限
AdaptFormer、Mona 等经典的视觉 PEFT 方法,本质上都是「静态」的:训练完成后,adapter 的权重就固定不变,无论输入是城市街景还是自然图像,是大尺寸目标还是小物体,都使用同一套变换参数处理。这种「一刀切」的模式对于全局分类任务或许足够,但对于需要精细空间建模、语义理解的密集预测任务来说,很难适配千差万别的输入模式。最终直接导致模型的有效感受野(Effective Receptive Field, ERF)偏小,难以捕捉长距离空间依赖,从根本上导致了性能瓶颈。
2. 层间独立的参数设计,特征冗余严重
现有 adapter 方法普遍采用「每层独立配置」的模式:每个网络层都拥有专属的 adapter 参数,层与层之间没有任何参数共享与信息交互通道。这种孤立设计会让不同层学到的特征高度趋同,产生严重的特征冗余:相当于多层网络在重复完成相似的特征变换,无法形成层次化、差异化的特征表达,既浪费了有限的参数量,又制约了模型的表征多样性。
为了直观验证这两大问题,团队在 COCO 数据集上对不同方法进行了可视化对比:
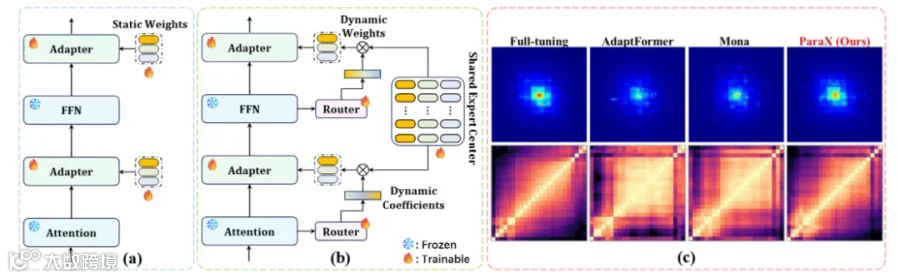
图 1 (a) 经典的 Visual PEFT 方法(例如,Mona); (b) 本文提出的 ParaX; (c) 不同微调方法的有效感受野(上排)与层间表征相似度(下排)对比
从图中可以清晰看到:AdaptFormer、Mona 等传统 PEFT 方法的有效感受野明显小于全微调,同时层间特征相似度更高(CKA 热力图更亮),直接印证了两大缺陷的存在。而 ParaX 的可视化结果与全微调高度接近,完美破解了这两个行业难题。
ParaX:参数即专家,动态路由重构 adapter 范式
如图 1 (b) 所示,ParaX 的核心 idea 源自 MoE:既然不同输入需要差异化的特征变换,那就构建一个「专家参数池」,每个专家有不同的功效,让每个输入根据自身内容动态组合不同的「参数专家」,生成专属的 adapter 权重。同时,让同一阶段的所有网络层共享这个专家池,天然实现跨层信息交互。
1. 整体架构:即插即用,适配多种视觉 backbones
ParaX 的整体设计简洁,可无缝嵌入 Swin Transformer、ConvNeXt、ViT、VMamba 等主流视觉架构:
· 对于层级式视觉模型,在每个阶段(Stage)设置一个共享专家中心,包含 M 组可训练的参数矩阵(即「参数专家」);
· 在每个网络模块(Block)的对应位置插入轻量 ParaX adapter:Swin 风格架构中插入在注意力层与 FFN 层之后,ConvNeXt 风格架构中插入在每个 Block 之后;
· 前向传播时,每个 ParaX 模块通过动态参数路由机制,从当前阶段的共享专家中心中加权聚合参数,生成本层、本输入专属的动态权重,再对特征进行变换。

图 2 ParaX 整体架构示意图
2. 核心机制#1:动态参数路由,实现真正的输入自适应
动态参数路由是 ParaX 实现「输入依赖变换」的核心,整套路由网络设计轻量,额外的参数量增加极小:
1. 对输入特征做全局平均池化(GAP),提取全局特征向量;
2. 通过一个低维线性层将特征压缩至低维,最大限度降低计算量;
3. 经过两个并行的线性层 + Softmax 激活,输出两组长度为 M 的门控系数向量;
4. 用两组系数分别对专家中心中的降维、升维参数矩阵加权求和,最终得到当前输入专属的 adapter 权重。
通过这套机制,不同的图像输入会激活不同的专家组合,生成差异化的 adapter 权重,从根本上突破了静态 adapter 的表征上限。
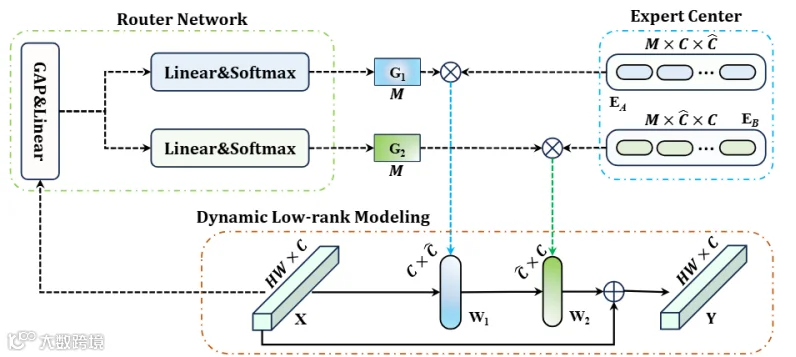
图 3 动态参数路由工作流程
3. 核心机制#2:跨层共享专家中心,隐式实现跨层交互
共享专家中心的设计,是 ParaX 解决「特征冗余」、提升特征多样性的关键:同一阶段内的所有网络层,共用同一个专家参数池,仅通过各自的路由权重实现差异化。在训练反向传播时,每个专家参数的梯度都来自所有调用它的网络层的梯度总和 —— 相当于每一层的学习信号,都会通过专家中心传递给其他所有层,天然实现了隐式的跨层特征交互。
这种设计带来了双重增益:一是显著提升特征多样性:跨层信息交互引导不同层学习差异化的特征表达,减少冗余,形成更丰富的层次化特征,CKA 可视化也直接验证了这一点;二是显著优化的参数效率:无需为每层单独配置参数,所有层共享一个专家池,用极少的参数量就能支撑起强大的表征能力。
4. 额外增强设计:动态多尺度空间混合
为了进一步强化密集预测任务所需的空间建模能力,ParaX 还提供了一个可选的多尺度深度卷积方案:所有卷积核同样从共享专家中心动态生成。
具体来说,路由网络会生成三组门控系数,对应 3×3、5×5、7×7 三种尺寸的卷积核参数,动态生成不同尺度的卷积权重,对特征进行多尺度空间变换。最后通过轻量的空间可变聚合(SA)模块,对不同尺度的特征进行空间注意力加权融合,进一步提升建模精度。和 Mona 的静态多尺度卷积相比,ParaX 的动态卷积可以根据输入内容调整卷积权重,对不同尺度、不同形态的目标适配性更强,空间建模能力实现了质的提升。
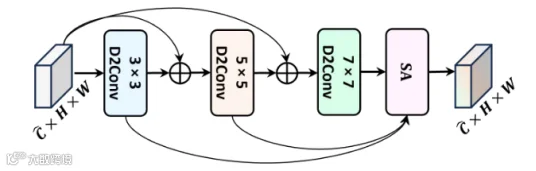
图 4 动态多尺度空间混合结构
视觉任务性能强大
研究团队在语义分割、目标检测与实例分割、全景分割、图像分类等大量主流视觉任务上进行了全面实验,覆盖多种主流视觉网络,充分验证了 ParaX 的优越性。
1. 语义分割
在 ADE20K 语义分割任务(UperNet 框架)上,ParaX 具有显著优势:
· Swin-L:仅用 7.3M 可训练参数(占全模型的 3.7%),mIoU 达到 52.0,比全微调高出 0.8 个百分点,同时领先此前 SOTA 方法 Mona 0.4 个点;
· ConvNeXt-L:同样超越全微调,mIoU 达到 52.0,大幅领先 LoRA、AdaptFormer 等基线方案。

表 1 ADE20K 语义分割性能对比
2. 目标检测与实例分割
在 COCO2017 数据集(Mask R-CNN 框架)上,ParaX 继续保持强势:
· Swin-L:AP^b 达到 48.6,AP^m 达到 44.0,与全微调持平,远超 AdaptFormer、LoRand 等其他 PEFT 方法;
· ConvNeXt-L:性能爆发,AP^b 达到 49.5、AP^m 达到 44.8,分别比全微调高出 1.4 %/1.6%,同时领先 Mona 0.6%/0.4%。
ParaX 仅用极少的可训练参数就能实现对全量微调的超越,充分证明了其强大的表征能力。
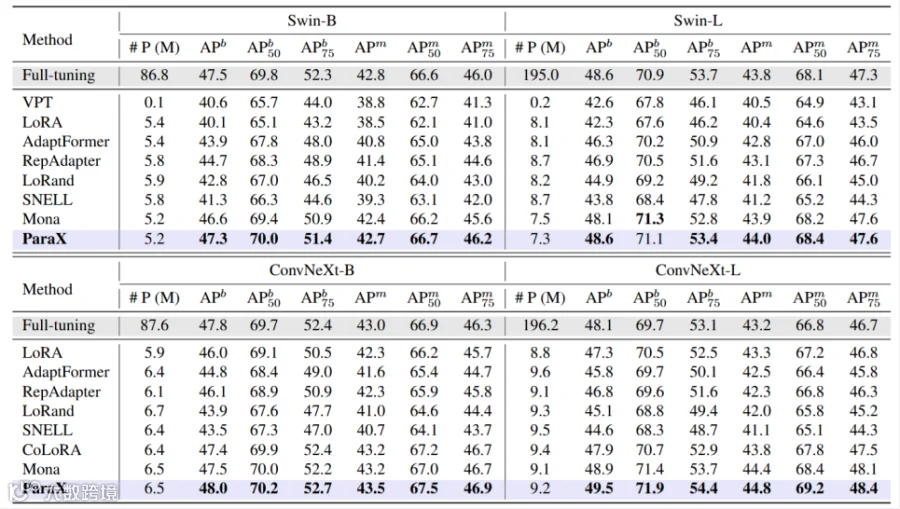
表 2 COCO 目标检测与实例分割性能对比
3. 全景分割与更多任务:通用性拉满!
在难度更高的全景分割任务上,ParaX 同样全面领先:Swin-B 骨干下 PQ 达到 48.8,比 AdaptFormer 高出 1.7%;ConvNeXt-B 下 PQ 达到 48.9,比 CoLoRA 高出 1.3%。

表 3 COCO 全景分割性能对比
在图像分类任务上,ParaX 在四个数据集的平均精度位列所有方法第一,尤其在存在严重域偏移的 ImageNet-R 数据集上,top-1 精度比 Mona 高出近 2%,展现了极强的泛化能力。此外,团队还在人体姿态估计、遥感图像分割、VMamba 架构适配等场景进行了拓展,ParaX 均取得了最优性能,充分验证了框架的通用性。
效率方面,ParaX 的训练吞吐量和显存占用与 Mona 相当,虽然比 AdaptFormer 略有增加,但换来的性能提升极其可观。更重要的是,相比全微调需要保存整套模型权重,ParaX 仅需保存少量专家参数,存储成本降低 95% 以上,对于多任务部署场景价值巨大。
总结与展望
ParaX 为视觉参数高效微调领域带来了全新的设计范式。其核心价值可以总结为三点:
提出「参数即专家」的核心思想,将 MoE 路由思路引入 adapter 参数生成,首次实现了完全输入依赖的视觉 adapter 权重动态生成;
设计跨层共享的专家中心机制,通过隐式跨层交互解决了传统 adapter 层间隔离导致的特征冗余问题,同时实现了极致的参数效率;
在语义分割、目标检测等多个密集预测任务上,以极少的参数量实现了对全微调的超越,大幅刷新了视觉 PEFT 的性能上限。
对于未来,团队表示将从三个方向继续推进:进一步优化架构,在保持性能的同时降低计算开销;将 ParaX 拓展到更大规模的视觉模型以及多 MLLM 中,为大模型的高效微调提供新的可能。
往期精彩文章推荐
中科院、 NUS、 清华等重新拓展持续学习边界 !勾勒大模型与 Agent 新地图
关于 AI TIME
AI TIME 源起于 2019 年,旨在发扬科学思辨精神,邀请各界人士对人工智能理论、算法和场景应用的本质问题进行探索,加强思想碰撞,链接全球 AI 学者、行业专家和爱好者,希望以辩论的形式,探讨人工智能和人类未来之间的矛盾,探索人工智能领域的未来。
迄今为止,AI TIME 已经邀请了 2000 多位海内外讲者,举办了逾 800 场活动,超 2000 万人次观看。

我知道你
提出观点,表达想法,欢迎

点击 阅读原文 查看原论文