


·聚焦:人工智能、芯片等行业
资本破局“内存墙”:从HBM到3D堆叠
中国电信研究院《智能体时代AI基础设施发展研究报告(2026)》预测,2026年我国Token年消耗量将达10亿亿,2030年超3500亿亿。国家数据局数据显示,2026年3月国内日均Token调用量已突破140万亿。德勤判断,未来超80%的算力需求将集中在推理侧。
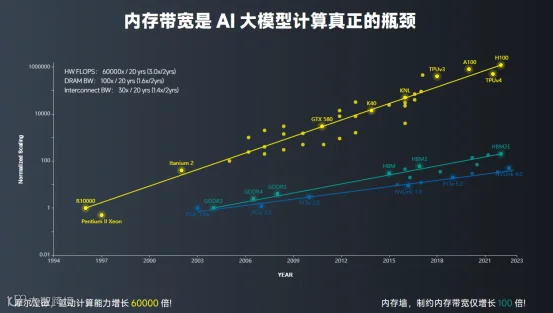
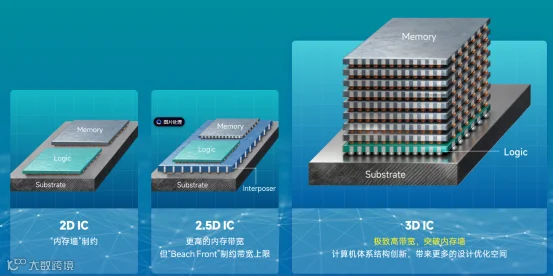
大模型推理的瓶颈在于数据搬运,参数在存储器与处理器间传输,消耗了约80%的能耗和70%的成本。这一现象被称为“内存墙”。主流解决方案HBM通过将内存靠近计算芯片缩短横向传输距离,但代价高昂:HBM3E现货价约2100美元,HBM4报价约3500美元,且产能已被三星、SK海力士等巨头垄断。
摩根大通预计2026至2028年供需持续偏紧。国产算力若想突围,需寻找替代路径。
技术路径:垂直堆叠重构数据通路
算苗科技提出的3D芯片方案,核心在于改变计算单元与存储器的相对位置。传统GPU加HBM方案虽提高了带宽,但数据仍需横向传输。算苗将存储直接叠放在计算单元上方,通过混合键合、硅通孔等技术形成密集垂直连接。
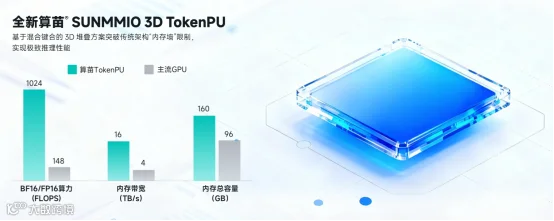
2026年6月流片的首代3D TokenPU芯片A4E,将8层DRAM存储晶圆垂直堆叠在逻辑晶圆上。数据显示,其访存带宽达16TB/s。这种设计显著缩短了连接距离,增加了传输通道,使计算单元能更持续地获取数据,同时降低数据搬运功耗。
此外,算苗采用面向Token生成的专用架构,通过Tile-Native理念优化数据复用。芯片基于自研RISC-V架构,并兼容LLVM、Triton等开发生态。该路线不依赖最先进制程,采用国产成熟工艺。仿真数据显示,采用12nm工艺的A4帕拉丁在Llama与Mixtral等模型推理中,吞吐量是4nm工艺英伟达H200的1.26至2.19倍,单价低30%。

团队背景:从矿机到AI芯片的跨界突围
创始人汪福全拥有中科院声学所博士及计算所博士后背景,师从龙芯首席科学家胡伟武。其团队在中科声龙期间积累了近10年的产业化经验。
2019年底,团队针对以太坊抗ASIC算法对内存带宽的高要求,反向利用3D堆叠技术解决带宽瓶颈。2021年四季度发布的JASMINER X4矿机,使用40nm成熟工艺实现了优于英伟达7nm旗舰显卡的能效比,单品营收超8亿元。通过此业务,团队量产超万片3D混合键合晶圆,出货超80万颗芯片,收入超12亿元,积累了稀缺的混合键合良率控制经验。
2022年11月,随着ChatGPT上线,算苗科技成立。团队核心成员包括前龙芯研发专家刘明、前微软研究院首席研究员楼建光及MiniGUI创始人魏永明。目前公司研发人员占比超八成。
未来展望:2027年量产考验供应链与商业落地
按照规划,A4E将于2027年内启动规模化量产,第二代产品A4S计划于2027年一季度流片。3D堆叠面临对准偏差、散热及应力形变等工艺挑战,任何环节失误都可能影响性能表现。
在供应链方面,算苗路线绕开了对台积电CoWoS的依赖,依托国产成熟制程即可闭环。长电科技、通富微电等封测龙头近年来大幅扩产AI算力封装产能,为产业链提供了支撑。
商业层面,某头部大模型厂商已与算苗联合研发近一年。内部预估,A4E量产后出货量有望达1万片晶圆以上,对应收入规模达数十亿元级别。

结语
随着摩尔定律放缓,芯片行业竞争焦点正从线宽转向架构与互联路径。算苗科技以120亿元估值入场,其核心价值在于通过垂直堆叠技术突破内存瓶颈。能否在2027年实现规模化量产并在实际应用中验证能效优势,将是检验其商业价值的关键。
部分资料参考:中国基金报、投中网、每日经济新闻、Google Cloud、NVIDIA
本公众号所刊发稿件及图片来源于网络,仅用于交流使用,如有侵权请联系回复,我们收到信息后会在24小时内处理。