


衡宇 发自 凹非寺
量子位 | 公众号 QbitAI
具身智能的“ChatGPT时刻”与工程鸿沟
何时迎来具身智能的爆发点?当开发者仅需通过一行API即可指挥机器人执行复杂指令时,答案或许已现端倪。GPT-6 Astra等前沿模型展现了惊人的通用能力,证明AI潜力远未触及天花板。
然而,现状呈现出鲜明的反差:AI模型如同高性能超跑引擎,但将其指令转化为物理动作的工程底座(Infra)却仍如坑洼土路。模型能力越强,对完善、易用的具身Infra需求越迫切,以承接算法的每一次跃迁。
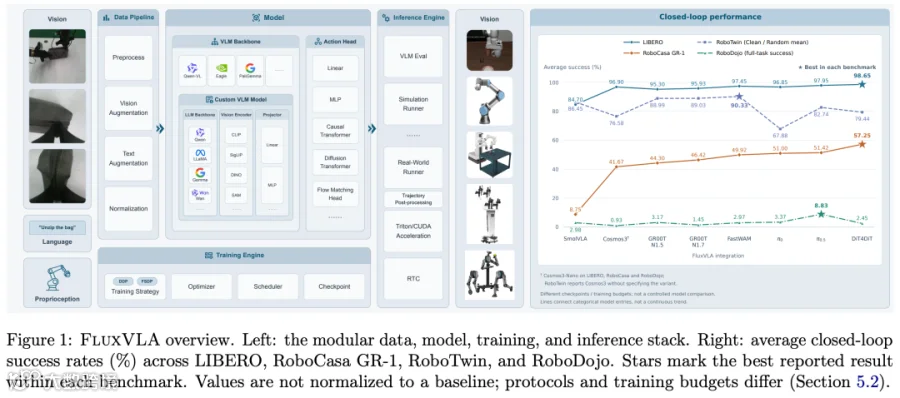
近期,逐际动力发布开源工程底座FluxVLA Engine的第二版技术报告。相较于首版,V2版本重点引入在线强化学习后训练实验,并大幅扩展了仿真评测与真机部署的覆盖范围。
报告显示,在仿真侧,14种策略接入同一套LIBERO闭环评测体系;在RoboCasa GR-1、RoboTwin与RoboDojo平台上,各有8种策略完成接入测试。在推理端,针对8组模型与设备组合的实测表明,优化后的模型推理路径频率提升2.31至9.64倍。此外,报告完整验证了从模型checkpoint直达ALOHA、Rebot、双臂Franka及全尺寸人形机器人LimX Oli等真机平台的闭环执行链路。
告别“作坊式”研发:构建标准化工业产线
具身智能研发长期面临高成本、高人力的困境,核心原因在于缺乏统一标准件,导致每个新实验往往沦为一次性工程。FluxVLA Engine旨在将这种“作坊式”重复搭建升级为标准化工业流水线。逐际动力创始人兼CEO张巍将其比喻为“模型的生产线”。
为实现这一目标,该底座围绕四项核心工程原则进行架构设计:
统一配置(All-in-one):通过一套配置单统管数据、模型、训练、评测与部署,摒弃分散脚本。
模块解耦:利用注册表和标准接口,将视觉语言骨干、动作头、数据集与训练策略模块化,支持自由组合。
面向部署的系统优化:在设计初期即集成推理加速、RTC(实时动作分块协调)和轨迹后处理,确保工程落地性。
实验可复现:完整封存实验配置、模型状态和执行轨迹,确保研发过程可追溯。
自今年4月开源以来,FluxVLA Engine保持高频迭代,从最初的“能训练、能评测”演进至“能上真机、能数据回流”。其迭代历程包括支持LimX Oli人形机器人全身移动操作、兼容GR00T N1.7、扩展RoboDojo评测等关键节点。
打通训、评、部署全链路的技术突破
面对技术路线的快速收敛与震荡,FluxVLA Engine通过底层工程基建与上层算法解耦,提供“以不变应万变”的工程底座,主要从数据模型、在线强化学习、细粒度评测三个切面实现突破。
数据与模型的标准化整合
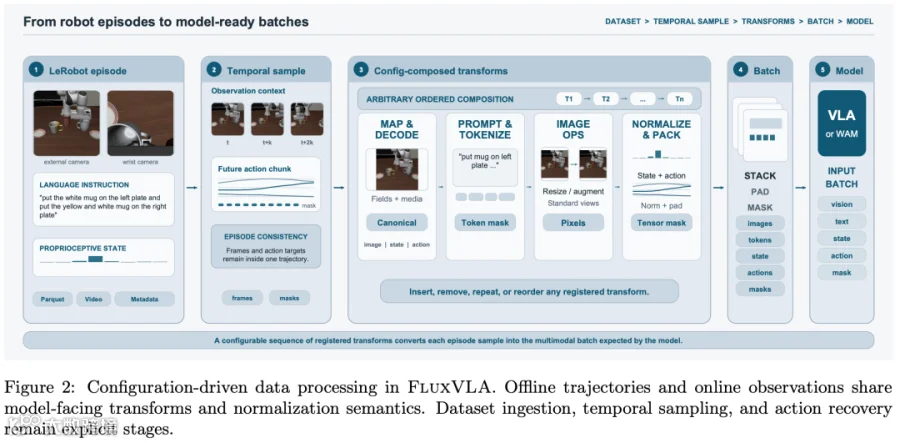
在数据层面,平台将不同来源的原始轨迹进行显式转换与标准化清洗,整理为兼容LeRobot规范的结构(含Parquet文件、视频及元数据),并对齐相机顺序、动作表达及归一化统计。此举显著降低了核心数据资产的贬值风险,提升了复用效率。
在模型层面,平台深度集成Qwen-VL、GR00T、π系列及DreamZero等主流架构。不同模型保留原生骨骼的同时,可通过统一接口无缝接入全流程。报告显示,14种主流策略(含紧凑型VLA、流匹配策略、世界动作模型及API调用的GPT-6 Astra等)同台评测,其中11个本地策略在LIBERO上的平均成功率超过95%。

在线强化学习(Online RL)的工程化落地
仅依赖模仿学习(SFT)的模型在面对突发状况时表现受限。FluxVLA Engine通过集成RLinf,解决了在线强化学习中环境交互、策略更新与分布式串联的工程复杂性难题。兼容的流匹配策略可直接进入在线交互训练流程。
实验数据显示,经过40个外层迭代的PPO后训练,SmolVLA在LIBERO-10任务上的平均成功率从66.2%提升至76.2%,在RoboTwin Clean十项任务上从45.9%提升至61.3%,分别增长10.0和15.4个百分点。这证明了小参数模型在闭环试错中具备巨大潜力。

显微镜式细粒度评测体系
V2报告扩展了仿真评测维度。RoboTwin新增8种策略接入,提供Clean与Random两种环境设置对比;RoboDojo对8种策略进行涵盖42个任务、单模型高达2100次试验的全面测试,并从泛化、记忆、精度、长程任务和开放指令五个维度生成“能力雷达图”。

这种可追溯的评测体系能够精准定位失败原因(如视觉感知、长程规划或精细控制问题),减少盲目增加数据或算力的无效返工,实质性地降低研发成本。
跨越仿真到真机的部署壁垒
为解决模型预测与机器人执行之间的时间不同步及动作不连续问题,FluxVLA Engine推出了一套系统工程组合拳。
极致推理优化:速度提升近10倍
在不改动模型权重的前提下,通过对GR00T、π0.5等模型进行底层推理重构,消除冗余计算。实测显示,在NVIDIA A100上,π0.5推理频率从2.20Hz提升至21.2Hz(提升9.64倍);在AGX Orin 64GB上,GR00T从3.20Hz提升至7.40Hz。数值对齐测试表明,加速后动作输出余弦相似度超过0.99999,几乎无精度损失。

实时动作分块协调(RTC):确保动作平滑
引入RTC机制,利用上一段动作剩余部分约束新预测动作起始点,消除突变。结合轨迹后处理模块的平滑滤波与运动学约束,确保下发指令满足物理边界,实现类人的丝滑操作。

双层解耦接口:实现跨本体迁移与数据回流
真机部署采用Runner(负责推理与调度)与Operator(负责传感器与控制)分离的双层接口设计。不同机器人只需适配Operator即可接入同一流程,大幅降低迁移成本。

实测数据显示,π0.5在ALOHA六项任务中成功率达72.22%;GR00T N1.7在双臂Franka五项任务中成功率达88.00%。在LimX Oli人形机器人箱体搬运任务中,π0.5完成全部四阶段的比例达33.33%,验证了全身移动操作链路的贯通。
此外,平台内置“人在环(Human-in-the-loop)”模块,支持人类实时接管纠偏并自动采集数据。相关研究表明,采用优势加权行为克隆后,任务成功率可从62.1%提升至99.4%,吞吐量显著提升,真正实现了数据飞轮的转动。
结语:重塑具身智能竞争逻辑
FluxVLA Engine提供了一套覆盖具身研发全生命周期的标准化工程方案。随着FluxBisim、FluxDAgger等后续生态组件的发布,逐际动力正致力于构建包含数据、仿真、交互、评测和部署五大关口的完整生态。
GPT-6 Astra等通用模型的出现警示行业,具身智能的竞争逻辑正在重构。除了深耕底层模型,具身基础设施的打磨同样关键。只有当底层工程能力像水电煤一样高度可复用,研发资源才能从重复造轮子中解放,投向真正的创新探索。
技术报告:https://arxiv.org/abs/2609.17210
GitHub主页:https://github.com/FluxVLA/FluxVLA
Hugging Face:https://huggingface.co/limxdynamics/FluxVLAEngine