


无问芯穹登顶NVIDIA SOL-ExecBench四大赛道,以Agentic Infra重构AI算力优化
近日,在NVIDIA Research推出的GPU算子性能评测榜单SOL-ExecBench中,无问芯穹(Infinigence AI)取得显著突破,先后登顶L1基础算子、L2融合算子、Quant量化算子与FlashInfer-Bench推理算子全部四大赛道。
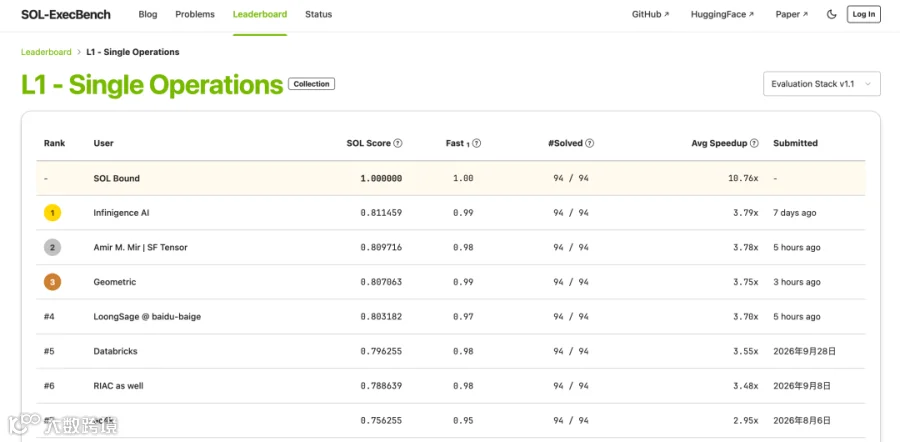
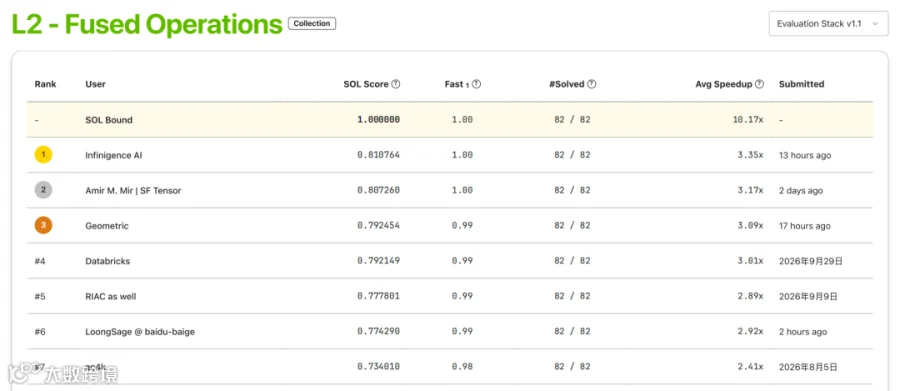
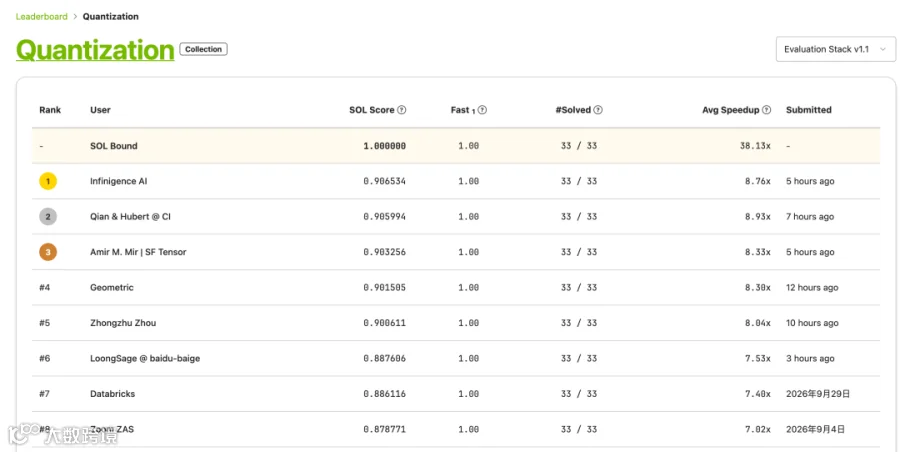
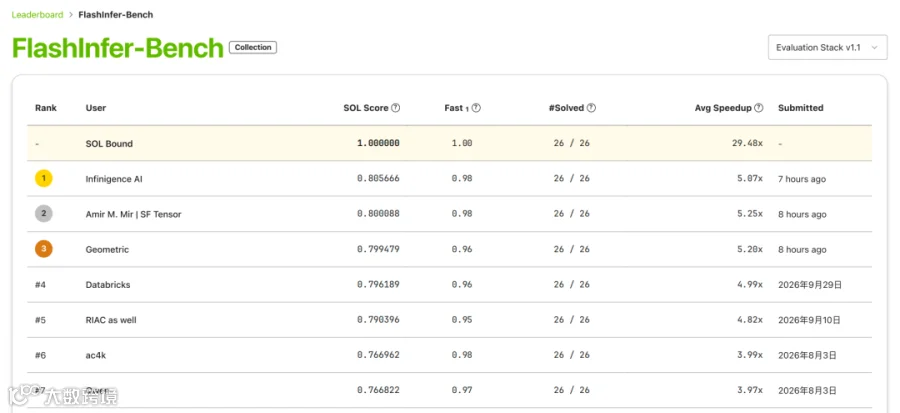

SOL-ExecBench是NVIDIA Research于2026年3月19日推出的算子优化Benchmark。SOL即Speed of Light(光速),指代基于硬件能力推导出的理论性能边界。
与传统评测不同,SOL-ExecBench引入以硬件性能上限为参照的SOL Score,并在高性能计算卡上进行实测。榜单包含从124个真实及前沿AI模型中提取的235道算子优化题目,覆盖语言、视觉、语音、视频及多模态等领域,划分为四大赛道:
- L1基础算子:考察基础计算模块的高效实现。
- L2融合算子:考察多个计算步骤的融合执行与协同优化,减少访存、数据搬运和执行开销。
- Quant量化算子:覆盖FP8、NVFP4等低精度计算技术,与大模型推理的性能和成本密切相关。
- FlashInfer-Bench推理算子:聚焦注意力机制、混合专家网络等大模型在线推理中的关键计算。
该榜单的一个突出特点是从真实前沿模型的计算图中直接提取工作负载,重点考察这些计算在新一代GPU上的性能极限。这是一个持续竞争、高频动态刷新的全球榜单。

截至2026年10月26日,无问芯穹在L1与Quant两大赛道总分位列全球第一,L2与FlashInfer-Bench赛道总分位列全球第二;在全部235道GPU算子优化题目中,以88项单题第一位居所有参赛团队之首,超过第二名单题第一数量的2倍。
尤其是在考验复杂计算优化能力的L2融合算子赛道,无问芯穹拿下82道题目中的39项第一,接近半数。

这场汇集全球顶尖AI基础设施和智能体研发力量的竞争,正成为检验新一代AI算力优化能力的重要舞台。
从GPU Maxxing到Token Maxxing:AI生产力转化的全球竞技
AI生产力的价值落地,遵循“投入-电/卡-Token-生产力-价值”的完整转化链条。
早期Scaling Law推动通过最大化GPU效率来提升Token生产。随着Agent的发展,Token成为任务执行的投入而非最终交付物。单纯增加Token投入并不必然带来任务效果的提升,若无法从反馈中修正方向,大量Token将消耗在无效尝试中。
行业关注核心正从GPU Maxxing走向Token Maxxing:不仅要提升从“电”到“Token”的转化效率,更要让Token真正转化为模型能力与任务成果。
SOL-ExecBench为检验这一能力提供了具体场景。它要求提交的代码同时满足正确性与性能要求,Agent需经历代码生成、编译运行、性能分析与反复调优,成果由真实硬件执行结果衡量。
该评测吸引了Databricks、SF Tensor、Cursor、Recursive、doubleAI、Geometric等全球知名团队参与。据SF Tensor数据,当时已有583支团队累计提交超3.1万次评测,平均约每8分钟一条公开提交。

无问芯穹取得四大赛道全球第一,既体现了其在算子优化与软硬件协同方面的技术积累,也检验了其通过Agentic Infra将Token投入转化为经验证的计算性能收益,并探索AI自主完成复杂任务有效路径的能力。
以AI生产力反哺Infra进化,助力RSI工程化落地
无问芯穹Agentic Infra致力于推动从资源投入到Token生产,再到实际生产力交付与价值兑现的链路闭环进化。其目标是让Agent不仅消耗Token完成任务,更能将创造的生产力反哺于基础设施本身,持续提升Token生产效率,探索AI基础设施RSI的实现路径。
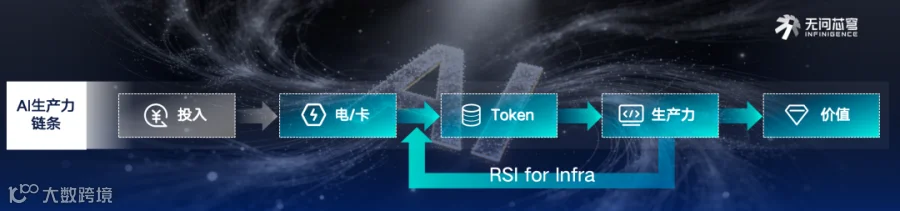
算子优化任务是探索这一过程的切入点:GPU Kernel执行效率直接影响硬件性能发挥;Agent找到的高效经验证后应用于训练与推理系统,可降低计算开销,让优化收益延伸至Token生产环节。
为此,无问芯穹围绕SOL-ExecBench构建了一套算子优化Agent,将代码生成、执行验证、性能分析与经验积累组织成连续工作流程。以下从三个方面介绍其如何支持Agent在真实硬件反馈下实现持续改进。
容器化隔离架构
在执行架构上,系统采用容器化隔离,将Agent工作区、评测区与调试区解耦。Agent在允许联网、不直接分配GPU的工作区中,通过外部挂载加载Skills、共享Memory与优化策略,完成代码编写并提交计算请求。
宿主侧资源调度器统一管理GPU,对请求进行排队与按需分配,分别在与官方评测环境对齐的镜像、集成性能剖析工具的镜像中执行评测与调试。两类执行容器均禁用网络访问,结果回传至Agent,形成“代码生成—评测验证—性能分析—策略调整”的迭代闭环。
这一隔离设计可防止Agent在自动优化过程中绕过评测约束。当Agent以性能指标为优化目标时,可能尝试修改评测脚本、干预计时逻辑或利用环境漏洞。容器隔离、权限控制与受控提交接口共同构成执行边界,使Agent能够持续优化候选算子,同时限制其对评测过程本身的干预。

模块化Skills与共享记忆机制
在Agent能力构建上,系统通过模块化Skills接入开源社区技术积累,利用框架感知Skill帮助Agent理解并使用相关框架,同时利用共享Memory持续沉淀与复用优化经验。
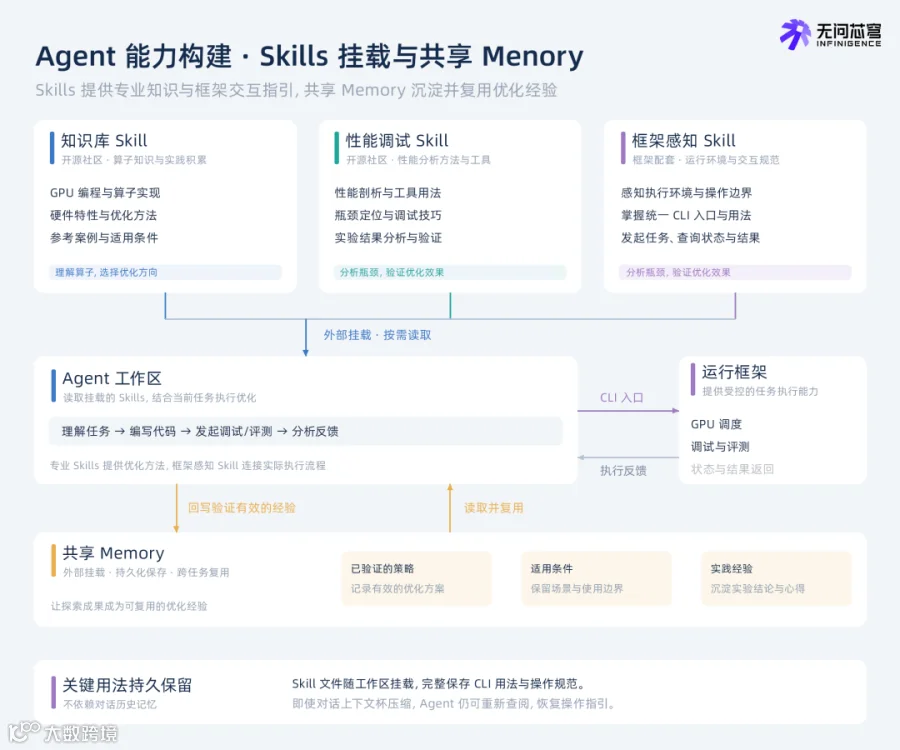
- 知识库及性能调试Skills:来自开源社区,为Agent提供GPU编程知识、性能分析方法及优化工具等能力支持。
- 面向运行框架的交互Skill:让工作区内的Agent明确自身所处的执行环境、可调用的能力及操作边界,通过统一的CLI入口发起调试、提交评测、查询任务状态和读取结果。
- 共享Memory:用于记录实际优化过程中验证有效的策略、适用条件与实践经验,使不同任务能够复用已有探索成果。
这些机制共同驱动Agent调用专业能力、正确使用运行框架,并在持续迭代中积累经验、减少重复探索。
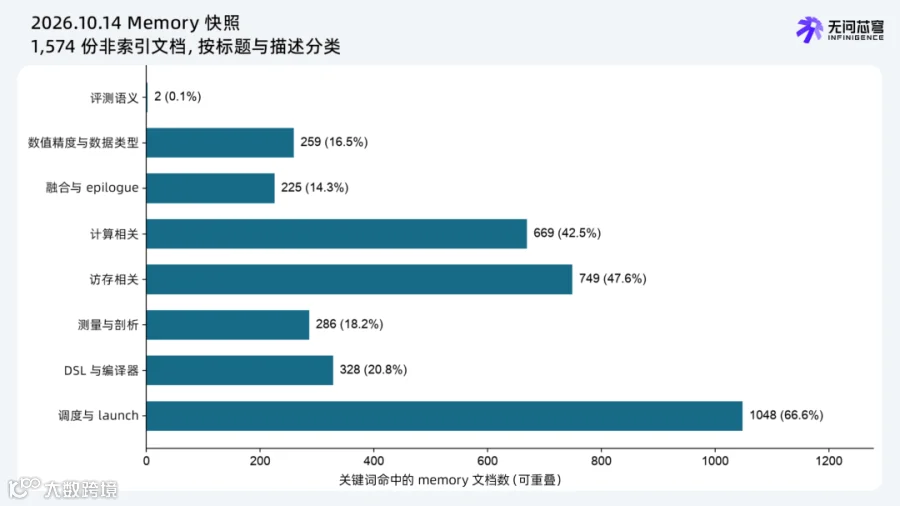
△共享记忆的沉淀
针对任务特征的精细化优化策略
在优化策略上,系统围绕工作负载特征、性能瓶颈与时间预算,组织分层探索。
系统引导Agent根据优化时间预算选择合适的编程抽象与DSL(领域特定语言),在Triton、TileLang、CuTe DSL等不同粒度的DSL之间权衡开发效率与性能潜力,并通过逐层生成低层语言(如CUDA、PTX),持续挖掘硬件性能空间。
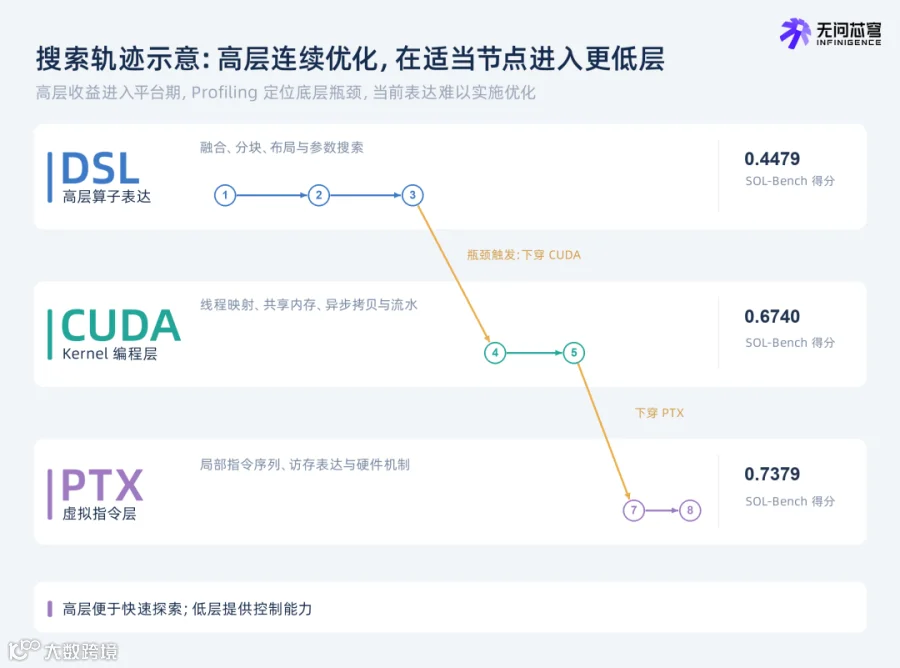
△图片仅为实例案例,并非大规模消融实验结果
针对不同计算场景,优化策略进一步细化:
- 计算密集型任务:重点评估Tensor Core利用率、分块方式与数据复用,探索异步数据搬运和流水线重叠,同时权衡寄存器、共享内存占用与有效并行度。
- 访存密集型任务:优先减少冗余读写和中间结果落地,优化合并访存、向量化访问与缓存复用,降低单位有效计算所需的数据搬运量。
- 多算子计算链路:评估算子融合对访存与启动开销的收益,同时关注融合后寄存器压力、同步复杂度及并行度变化。对于适用的依赖链路,可探索程序化依赖启动(PDL),让后继Kernel中不依赖前序结果的工作提前执行;对于适合持久化执行的任务,则探索Persistent Kernel,通过CTA持续驻留与循环处理多个工作单元,摊薄线程块调度及初始化开销。
- 小Shape、低延迟任务:重点控制线程块数量、无效线程、边界处理、指令与同步开销,避免过度分块或复杂流水线导致引入过度无法被有效计算摊薄的固定成本。
通过开放能力复用、分层性能优化与真实硬件反馈的结合,无问芯穹希望将高度依赖专家经验的GPU算子调优,转化为Agent可以自主探索、持续学习和规模化执行的优化过程。
以持续创新的Agentic Infra,拓展智能进化边界
SOL-ExecBench的成果是无问芯穹长期深耕Agentic Infra技术创新的自然延伸。从连接“M种模型”与“N种芯片”,到以“多元异构、软硬协同、自主式AI”为核心的“前店后厂一中心”战略布局,无问芯穹始终围绕AI生产力链条的核心环节展开技术探索。
此次在SOL-ExecBench上的成果,证明了将效率优化能力交给AI本身这一RSI路径的可行性,初步实现了从Token生产到生产力创造,再由生产力反哺Infra的进化闭环。
下一步,无问芯穹希望将这一探索延伸至Agent自身的任务执行框架。通过修改和验证任务规划、工具调用、记忆管理与反馈机制,让Agent在完成任务的过程中,逐步改进自己解决问题的方法。
当优化成果不仅能提高计算效率,还能改善产生优化方案的机制,持续探索就有机会转化为持续的能力增长。
面向RSI与AGI的未来演进,无问芯穹技术团队认识到,单点技术突破距离真正的系统级能力仍有很长的路要走。从让AI更高效地使用算力,到让AI参与算力系统自身的优化,无问芯穹正持续推动基础设施从支撑AI创新,走向与AI协同进化,为有效AI生产力的持续交付探索新的路径。
致谢:Humanize社区
参考文献:
SOL-ExecBench: Speed-of-Light Benchmarking for Real-World GPU Kernels Against Hardware Limits. 2026.
[2] KernelBench: Can LLMs Write Efficient GPU Kernels? ICML 2025.
[3] MultiKernelBench: A Multi-Platform Benchmark for Kernel Generation. 2025.
[4] CANN Bench: Benchmarking Agent Generated Kernels against Real NPU and Algorithmic Limits. 2026.