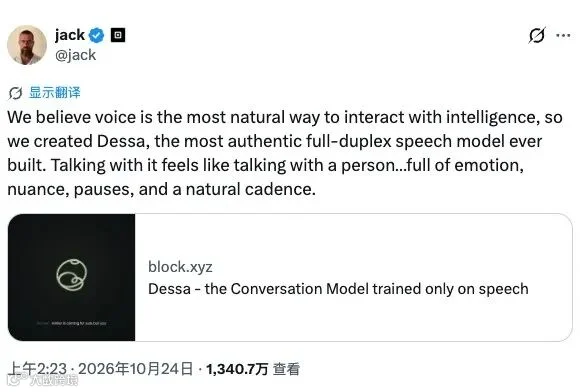
语音交互与 AI 的结合已非新鲜事,但市面上多数语音助手的底层逻辑仍停留在「念稿」阶段:将语音转为文字,交由文本大模型处理,再合成为语音输出。由推特联合创始人 Jack Dorsey 旗下 Block 公司推出的语音模型 Dessa,试图打破这一常规。该模型绕开文字媒介,直接基于声音构建知识与对话能力,旨在证明机器的智能可以从声音本身生长。
原生语音路线:Dessa 的「去文字化」探索
「既然人类婴儿在识字前已学会说话,机器为何不能遵循相同路径?」这是 Jack Dorsey 创立 AI 实验室 Dessa 的核心初衷。Dessa 作为 Block 旗下的独立研究团队,直接向创始人汇报,专注于纯 AI 研究。剔除文字训练环节的原因在于,文字会将动态的声音固化为静态字符,过滤掉大量信息。Block 团队表示,完全基于声音训练的 Dessa 能够实现边听边说、自然插话及即时附和(如「嗯」「是的」),甚至可在配备 M4 Max 芯片的 MacBook Pro 上本地运行。尽管训练细节与模型规模尚未公开,外界难以评估其技术上限,但 Dessa 指向了一条长期被文本大模型掩盖的「从语音到语音」(Speech-to-Speech)非主流技术路线。
务实应用路线:Grok Voice 与半秒延迟之战
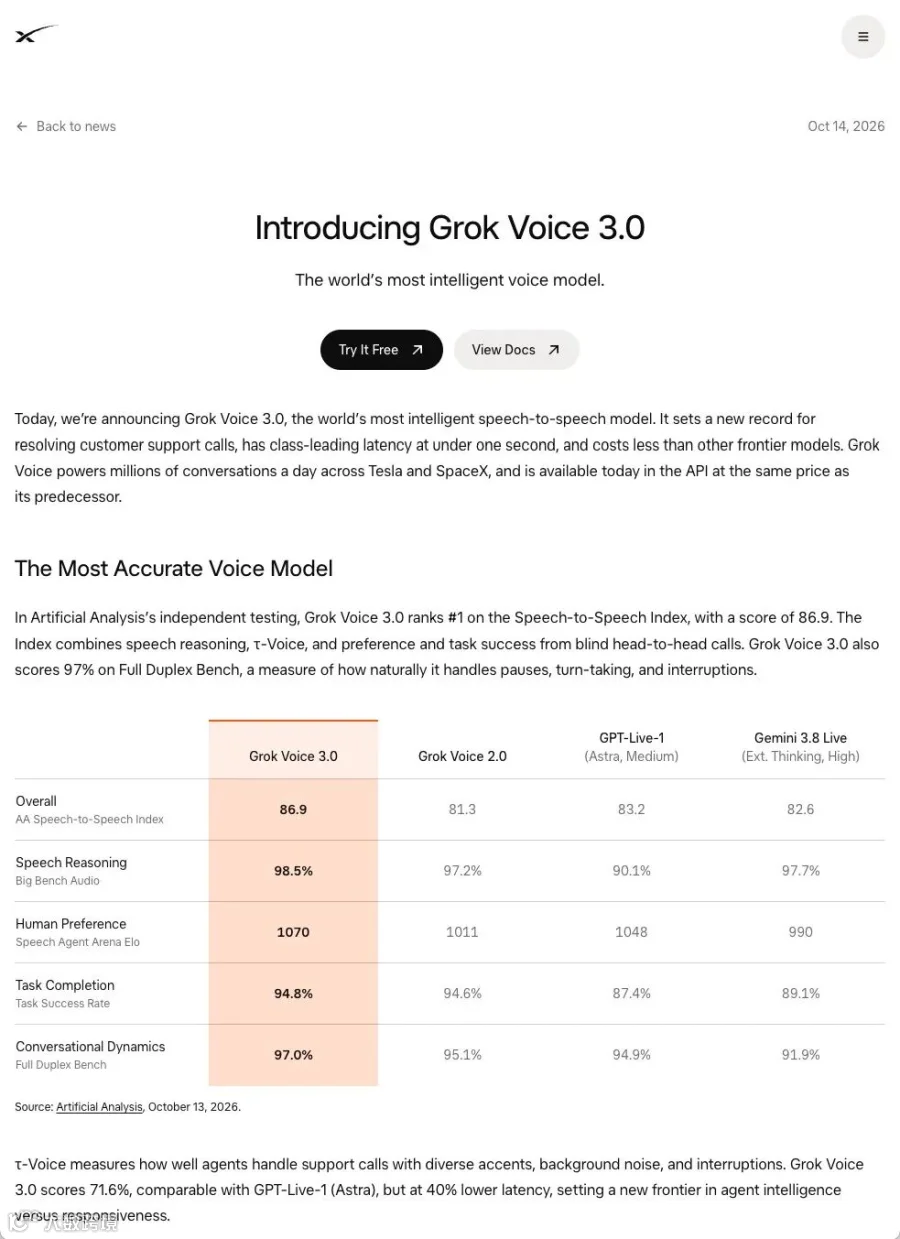
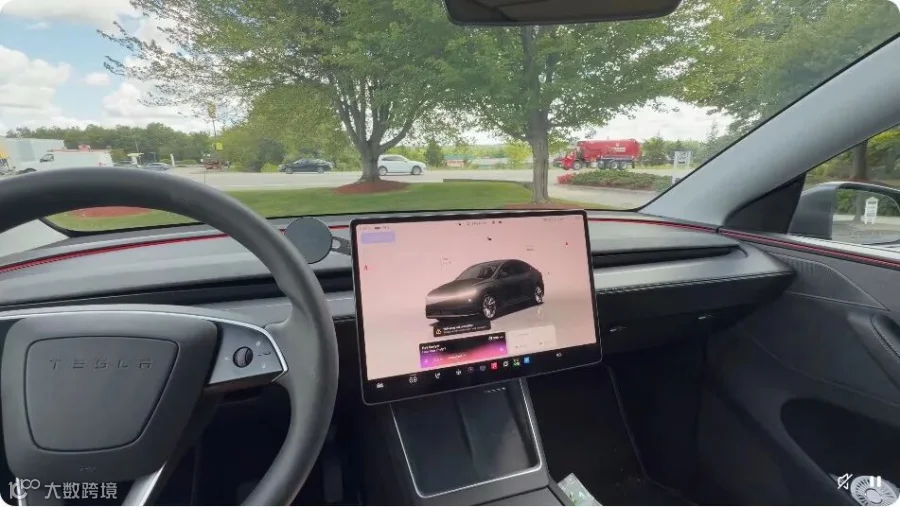
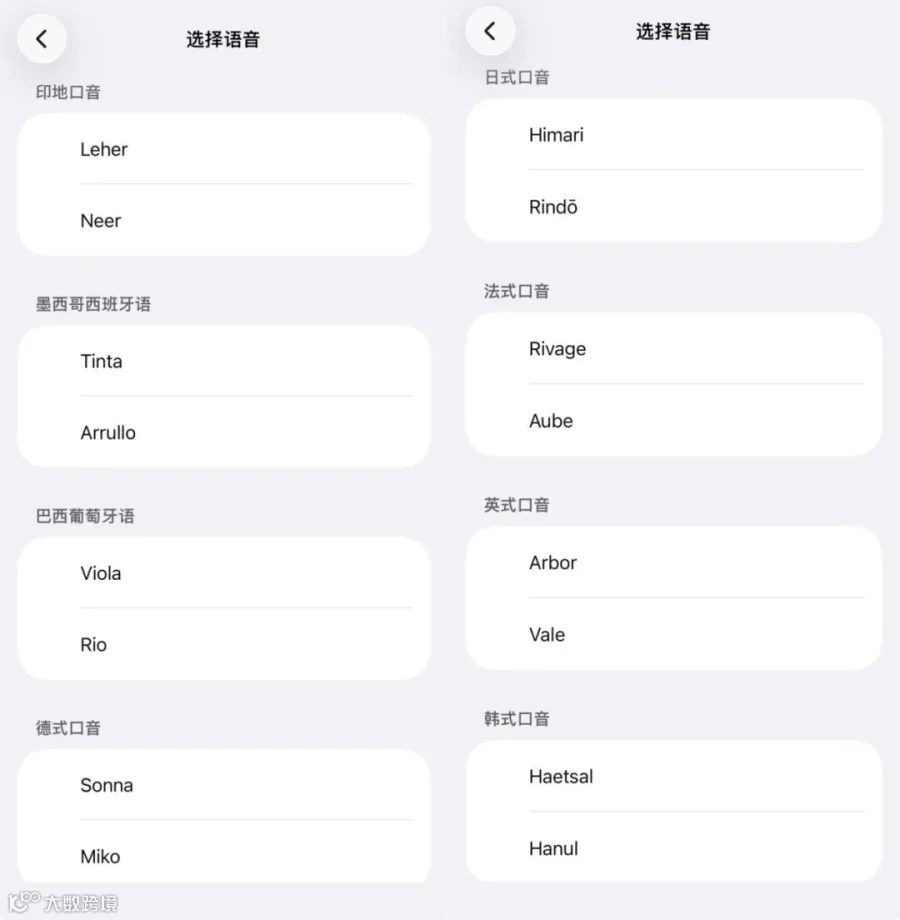
相较于 Dessa 对语音本质的纯粹探索,主流商业模型正加速将语音能力融入日常工作流。xAI 同期推出的 Grok Voice 3.0 同样主打实时端到端语音交互,但其策略更侧重结合大模型的文本推理底子与原生语音能力。以特斯拉为例,车主可直接通过车机与 Grok 对话,无需切换至手机 App。这类主流语音模型的进化核心聚焦于「半秒钟」的时间窗口。在电话交流中,半秒的沉默或不当的笑点足以破坏对话体验。Grok Voice 3.0 将优化响应延迟作为关键目标,以提升交互的自然度。毫秒级的差异直接影响商业价值。目前,车载空间与客服热线是语音 AI 的主要应用场景。据 xAI 披露,该系统不仅处理特斯拉车内对话,还承担了 Starlink 每天约 2 万通客服电话,其中约 70% 的问题无需人工介入即可解决。真正的「上岗」要求模型在口音、噪音及打断中准确识别诉求,并流畅完成资料检索、工具调用及故障处理。与此同时,OpenAI 也在 10 月中旬更新了 GPT-Live,提升了多语言口音自然度,并在 API 中新增包括日韩口音在内的九款音色,支持通过文字描述定制声音。



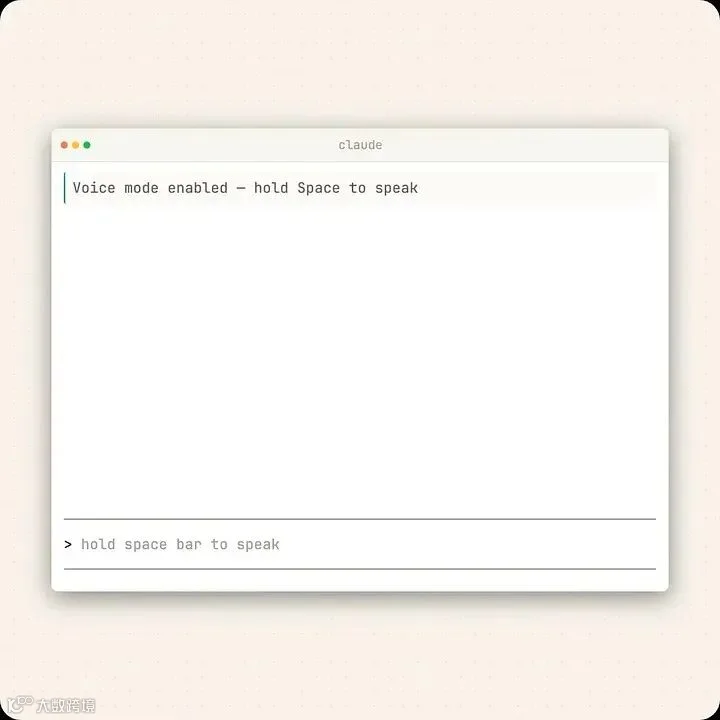 Claude Code 的语音模式

 APPSO