这是2026年的第 71 篇文章
( 本文阅读时间:约 20 分钟 )
2026 ACM SIGOPS Annual Technical Conference(ATC 2026)将于 2026 年 11 月 15 日至 18 日在中国香港召开。阿里巴巴集团共有 12 篇论文被主会录用,居全球企业首位。作为与顶尖高校同处第一梯队的中国产业界机构,阿里巴巴此次被录用的研究成果涵盖模型服务与 Agent 基础设施、云资源与可靠性、安全计算与容器等技术方向。
ATC 是计算机系统领域公认的顶级国际学术会议(CCF A 类),今年录取率低至 13.9%,尤为强调真实的系统实现与扎实的实验结果。
随着大模型与 Agent 相关服务规模化上线,瓶颈逐渐显现于系统层:如模型权重分发拖慢冷启动、长上下文请求挤占 KV Cache、工具规模受限于上下文窗口、多智能体系统故障难归因等。而在云基础设施层,资源调度、内存与网络成本、安全计算开销同样制约着上层服务的效率优化。此次入选的 12 篇论文正是从这些生产瓶颈出发,在系统架构、调度和软硬件协同层面给出了解法。
技术栈阅读地图
01|大模型服务与模型交付:xMaaS、CacheFS、Axon、Chorus
02|Agent 基础设施与系统可靠性:MCP Gateway、TraJudger、Dasheng
03|资源调度与内存效率:PAMOS、Zswap Boost
04|网络系统与虚拟化数据路径:Lean、Courier
05|可信硬件与隐私计算:SwiftMPC
以下论文解读按技术栈从上层模型服务逐步下沉到基础设施与安全边界
大模型服务与模型交付
沿着模型服务的运行链路,先用生产测量看清资源如何被使用,再依次解决权重分发、跨实例 KV 调度和长短请求混跑下的异构解码。
生产级 MaaS 集群,GPU 到底用在了哪里?
Model-as-a-Service in the Wild: Characterizing Production LLM Inference Clusters at Scale
大模型推理正成为云平台的核心负载,生产级模型即服务(MaaS)平台需要在异构 GPU 集群上同时承载大量模型与应用。然而,现有工作负载研究主要关注请求到达、流量突发和输入输出长度,难以回答集群资源如何分配、为何利用不足,以及现有推理优化技术在何种部署条件下能够发挥作用。这种系统级视角的缺失,制约了生产瓶颈诊断与资源管理策略的设计。
论文基于阿里巴巴生产级 MaaS 平台 xMaaS 连续六个月的运行数据,覆盖十万余张 GPU、56 个集群、30 种 GPU 类型、近 30 万个应用和约 7 万个模型变体,开展以资源为中心的跨层次分析。其核心思路是将部署元数据、硬件利用率与推理服务指标相结合,以 GPU 数量和占用时长共同衡量资源投入,贯通集群、应用和模型三个层次,系统刻画资源供给、分配、占用与实际利用之间的关系。
研究发现,生产集群中的资源供给与消耗高度不均衡,在线和离线负载呈现不同的部署与利用模式,应用需求的动态变化与相对稳定的资源配置之间存在明显错配,模型变体的多样性进一步增加了资源管理的复杂性。其中,约 60% 的在线 GPU 时长对应的计算单元利用率低于 15%,而显存仍普遍处于高占用状态,凸显了资源占用与有效利用之间的差距。跨层次分析表明,推理系统的资源效率受到硬件条件、负载需求和模型特征的共同影响,单一资源指标或统一配置策略难以充分反映真实生产需求。
基于这些发现,论文进一步梳理了显存利用效率、异构资源管理和弹性 Prefill–Decode(预填充与解码)分离部署面临的关键挑战,分析现有推理优化技术的生产适用条件,并提出后续研究方向。相关脱敏运行轨迹已公开,为推理系统的设计、评估与优化提供了真实生产数据和可复现的研究基础。
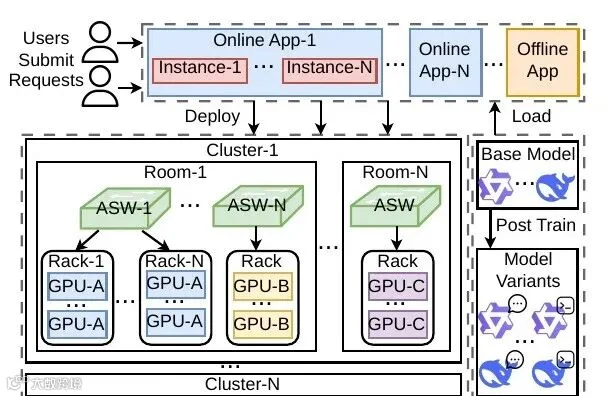 图|xMaaS 总体架构:在线与离线应用通过实例部署到异构 GPU 集群,并由基础模型生成不同模型变体。
论文下载地址:
https://inno-open.oss-accelerate.aliyuncs.com/open/paper/atc26-model-as-a-service.pdf
CacheFS:把推理节点组织成模型权重协作缓存
CacheFS: Peer-to-Peer Cooperative Caching for LLM Weight Distribution at Cloud Scale
降低大模型推理成本已成为推理服务面临的关键挑战。在弹性扩容过程中,GPU 节点需要先获取模型权重,才能提供推理服务。突发扩容时,大量实例同时从共享云存储拉取同一个模型,带宽竞争显著拉长模型分发与实例启动时间。在生产环境中,通过云 NFS 向 50 个实例分发 Qwen2.5-72B 需要约 28 分钟。在模型权重就位前,已分配的 GPU 只能等待,造成资源闲置。因此,加速模型权重分发是缩短扩容时间、提高 GPU 利用率和降低推理成本的重要环节。
CacheFS 利用模型权重不可变、全量读取、实例间内容相同的特点,将推理集群的主机内存与节点间带宽组织成点对点协作缓存,让实例之间共享模型数据,减少对上游存储的重复读取。其关键机制是哈希感知的协作淘汰策略。在内存压力下,各节点优先保留一致性哈希分配给自己的数据块;当集群总缓存容量足以容纳模型工作集时,各节点的部分缓存可共同保留完整模型,而不要求单个节点缓存全部权重,也无需逐块协调保留决策。配合协程数据面、主动预加载和区域级预热缓存层,CacheFS 通过 FUSE 提供透明文件访问,无需修改推理框架。
CacheFS 已在生产环境运行超过 18 个月,目前覆盖四个云地域的十万卡级推理集群。实验显示,向 50 个实例分发 Qwen2.5-72B 的时间从云 NFS 的约 28 分钟缩短至 30 秒,实现 56 倍加速;DeepSeek-R1 单节点加载时间从对象存储的约 19 分钟降至 200 秒,Qwen3-235B 则从 6 分钟降至 60 秒。CacheFS 与配套的快速启动运行时协同优化实例启动,整体每天节省超过 7,700 GPU 卡时。
 图|读取按本地缓存、P2P Peer、Seeder、CacheRoot、源存储逐级查找;控制、元数据和数据面分别由 Serf、gRPC 与 coro-rpc 支撑。来源:论文 Figure 3。
论文下载地址:
https://inno-open.oss-accelerate.aliyuncs.com/open/paper/atc26-cachefs-peer-to-peer.pdf
Axon:让计算去找 KV,而不是把 KV 搬到计算节点
Axon: Asynchronous Global KV-Aware Scheduling Across Distributed Instances for Agentic Workloads
Agent 工作流中,每轮调用轨迹都会追加进对话历史,使上下文迅速主导整个序列。生产环境的 Agent trace 显示,session 平均 24.3 轮,上下文平均 33.5K tokens、占序列总长的 84.1%,而新增 prompt 仅为 3.7K;65% 的 session 跨越 5 个以上实例,KV Cache 碎片散落在集群各处。现有系统要么重算 KV,要么假设 KV 可在本地恢复,要么遵循 data-to-computation 范式,把碎片先聚合到接纳请求的实例,每轮都要付出沉重的通信代价。
Axon 的破局点有两个。
其一,计算跟着存储走。Axon 提出 computation-to-data 范式的服务架构:不再把散落的 KV 聚合到某个计算节点,而是把 attention 分发到 KV 已经驻留的实例上就地运行。集群 GPU HBM 由此成为统一的 KV 缓存池,原本不可用的碎片直接变成可用的缓存资源。
其二,灵活的上下文切分带来细粒度的并行加速。核心机制非对称 Query 上下文并行(AQCP)把每层计算在模块边界上细粒度拆开:每个请求由一个 AxonMaster 完成全部线性计算,attention 则交给多个跨实例的 AxonLet,在各自的本地 KV 片段上并行计算。上下文如何切分完全灵活——同一 batch 内的不同请求可采用各自的分片方案,参与实例数按需增减。attention 开销随上下文长度增长,却能沿切分边界分摊到多个 AxonLet:切得越细,单实例负担越轻,Axon 由此具备随并行度加速长上下文的潜力。
这一设计在三个层面兑现收益。通信量与上下文长度解耦:跨实例只传输随新增 prompt 增长的 Query,而非随历史上下文累积的 KV 状态,通信负担不再随轮次膨胀。细粒度并行的开销可控:分组增多虽会抬高 merge 开销,但在典型并行度下可忽略不计,且集合宽度只取决于单请求并行度,不随集群规模增长。调度不阻塞推理:全异步调度器只为新请求做决策,不介入在飞推理的逐迭代调度;统一内存池让跨实例请求并发恢复上下文,用满聚合 PCIe 带宽。
Axon 基于 vLLM 实现,在 A100 集群上使用生产 trace 进行评测。相比 LoongServe、vLLM 与 HCache,prefill 延迟最高降低 4.14×、decode 延迟最高降低 1.87×、端到端延迟最高降低 2.27×,服务容量提升 2.25×,KV 命中率提升近 20%。集群级分布的 KV 状态,由此从一笔需要被降低的成本,转变为一种可被利用的局部性。
 图|异步调度器统一处理新请求、KV 与批次;请求在 AxonMaster 完成线性计算,在持有本地 KV 分片的 AxonLet 上完成 attention。来源:论文 Figure 4。
论文下载地址:
https://inno-open.oss-accelerate.aliyuncs.com/open/paper/atc26-axon-revised.pdf
Chorus:用 GPU 跑短请求,用 CPU 接住长尾解码
Chorus: GPU–CPU Cooperative LLM Serving for Length-Skewed Decode
在线大模型推理通常分为 prefill 与逐 Token decode 两个阶段。Prefill 以矩阵计算为主,而 decode 需要反复读取模型权重和持续增长的 KV Cache,因此容易受到显存容量与带宽限制。生产负载又呈现明显的长度偏斜:大多数请求较短,少量长请求却会在许多解码步骤中长期占用大量 KV Cache。实验发现,长请求主导时 GPU 的 KV Cache 使用率已接近 90%,但显存带宽利用率仅为 38%,说明系统首先遭遇的是容量瓶颈。长请求由此压缩批处理和新请求准入空间,导致短请求的首 Token 延迟和整体有效吞吐显著恶化。
论文提出 GPU–CPU 协同服务系统 Chorus,将配备 AMX 的空闲 CPU 资源作为第二条 decode 通道。系统仍在 GPU 上执行全部预填充和延迟敏感的短请求 decode,仅在 GPU 显存紧张且 CPU 具备足够 TPOT 余量时,将选定的长请求一次性迁移到分布式 AMX CPU 组,并释放相应的 GPU KV Cache。相比逐算子卸载,该设计避免了每个 Token 上的 CPU–GPU 同步。为保证 CPU decode 性能,Chorus 使用张量并行聚合多机计算与内存带宽,并通过自适应注意力任务划分、大小批次自适应的 MoE 专家融合,以及流水化 AllReduce,优化长上下文、小批量执行。
在 Qwen3-32B、GLM-4.5 和 DeepSeek-R1 及两类生产负载上,Chorus 均取得最高的 SLO 达标吞吐:峰值 goodput 较 SGLang 提升 1.07–1.26 倍,平均提升 1.17 倍;在相同请求负载下,当 GPU-only 系统发生 TTFT 崩溃时可提升 1.3–11.4 倍,并较现有 CPU-offload 方案最高提升约 4.3 倍。其注意力和 AllReduce 优化还分别带来最高 3.2 倍和 2.3 倍的局部加速。
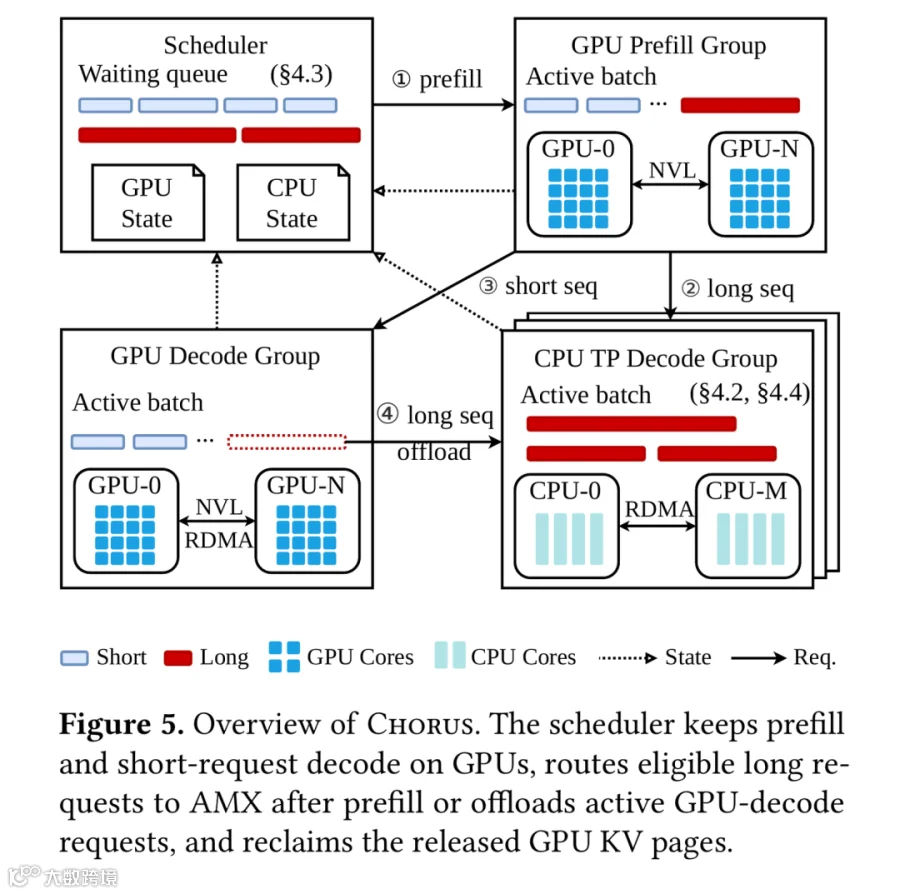 图|prefill 与短请求 decode 留在 GPU;长请求满足显存压力与 TPOT 条件后进入 AMX CPU 通道,并释放 GPU KV 页。来源:论文 Figure 5。
论文下载地址:
https://inno-open.oss-accelerate.aliyuncs.com/open/paper/atc26-chorus-gpu.pdf
Agent 基础设施与系统可靠性
这一组从工具控制面出发,进一步讨论多 Agent 执行失败后的结构化归因,以及 Agent 如何进入真实网络可靠性工程。
MCP Gateway:把海量 API 变成 Agent 可发现、可调用的工具
Scaling LLM Agent Tool Access: The MCP Gateway
LLM 应用正从对话机器人走向会调用工具的 Agent。MCP 统一了工具的调用与暴露方式,13 个月内公开的 MCP Server 已达万级,但它假定客户端与服务端直连,在规模化接入时难以支撑:存量百万级 OpenAPI 无法被 Agent 直接调用,工具开发者还要承担协议兼容与鉴权;Agent 能挂载的工具数受上下文窗口限制,全部挂载会导致 Token 成本与延迟上升、成功率下降;有状态后端部署多副本时,会话亲和性只能由客户端维护。
MCP Gateway 的关键思路是在数据面做一层桥接,把与工具功能正交的协议适配、访问控制、工具发现和会话路由统一收归网关。障碍在于 MCP 运行在 HTTP 上,路由信息却位于 Body 而非 Header,现有的 L7 负载均衡与 API Gateway 无法直接复用。转换模块把 MCP 调用翻译成存量 API 调用,并打通互不兼容的 Transport 变体,目前已支持云上 315 个 OpenAPI 服务;鉴权模块则建立身份到工具的细粒度映射。
在线请求到来时,网关先替 Agent 选择工具:工具 Schema 本身显式描述功能,因此采用语义与词频相结合的混合检索,比 LLM 推荐更确定、更快,也更容易扩展;通用匹配难以捕捉领域知识时,则通过 Query 改写和知识缓存进行补充,缓存还会沿依赖关系返回完整的前置工具链。随后,调用被翻译成后端 API 请求;对于有状态后端,网关维护 Session 到 Server 的映射,多实例之间通过集中存储同步映射,并通过 Pub/Sub 转发响应,以维持长连接。
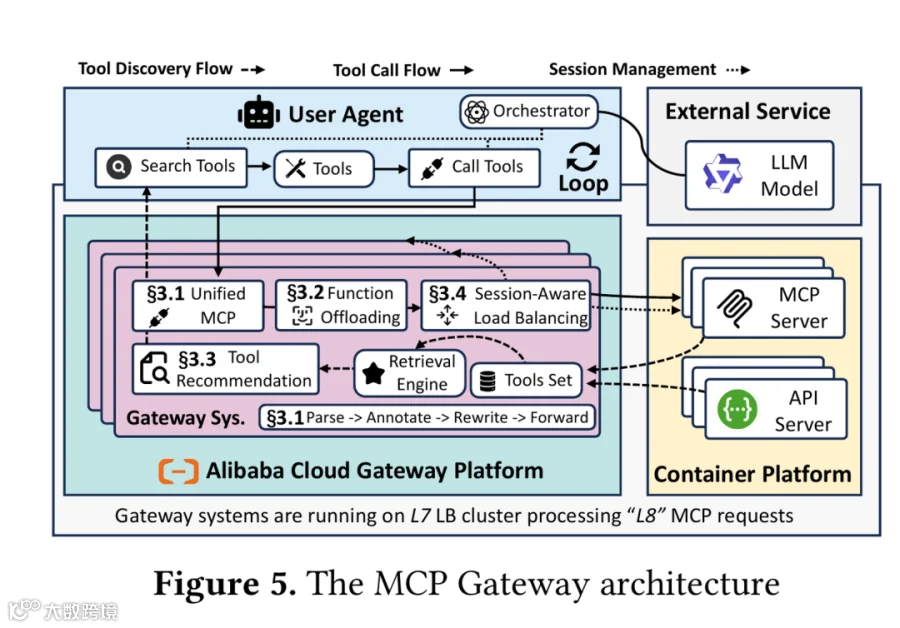 图|网关位于 Agent 与 MCP/API 服务之间,统一处理协议适配、功能卸载、工具发现和会话管理。来源:论文 Figure 5。
论文下载地址:
https://inno-open.oss-accelerate.aliyuncs.com/open/paper/atc26-final25.pdf
TraJudger:沿依赖图反向寻找多 Agent 故障根因
TraJudger: Structure-Guided Failure Attribution for LLM-Powered Multi-Agent Systems
在 LLM 多智能体系统中,故障证据隐藏在非结构化的自然语言交互里,上游错误可能经过多个正常执行的智能体传递,最终在下游暴露。现有 LLM-as-a-Judge 方法容易将传播症状误判为根因,混淆故障类型,并生成缺乏证据的解释,使生产排查仍依赖人工逐步分析。
TraJudger 的关键思路是先恢复依赖结构,再开展专门检测与受约束归因。系统将用户任务、角色规范、工具信息和执行轨迹构建为层次认知图,关联静态约束与动态“意图—动作”;随后由合规、逻辑、流程和上下文四类专家并行检测,以差异化验证策略识别故障,避免单一裁判造成类型混淆。
在归因阶段,TraJudger 抽取跨步骤依赖,通过确定性图遍历从最终失败反向追溯。其核心亮点是保留自身执行正确、却传递了上游错误的传播步骤,避免传播链断裂或错误归责于下游,最终输出带有证据路径的根因排序与修复建议。整个过程无需专门训练或重新执行任务。
在阿里巴巴轨迹数据集与基准轨迹数据集上,TraJudger 持续优于对比方法,评测的智能体级、步骤级准确率最高分别达到 88.4% 和 84.3%,平均归因时间不足 1 分钟。实践表明,显式依赖与可核验的传播链,是提升多智能体故障诊断可靠性的关键。
 图|先恢复 HCG,再由四类专家识别故障,最后根据依赖关系反向追踪根因并输出证据链。来源:论文 Figure 3。
论文下载地址:
https://inno-open.oss-accelerate.aliyuncs.com/open/paper/atc26-trajudger.pdf
Dasheng:让大模型沿真实拓扑和工具链排查云网络故障
Dasheng: LLM-powered Reliability Engineering Assistant for Cloud Overlay Networks
云网络的可靠性关系到云上业务的连续运行。随着网络规模扩大、组件持续演进,运维工程师面对的问题越来越复杂:一条告警背后可能关联多个服务,一次配置变更可能沿着控制链路影响转发,一处底层故障也可能引发跨层异常。如何把分散在不同团队中的工具、数据和专家经验组织起来,帮助工程师更快地理解问题、定位原因并制定处置方案,成为云网络智能运维的重要课题。
阿里云网络齐天团队为此研发了 LLM 驱动的可靠性工程助手 Dasheng,让 AI 像工程师一样逐步排查:先结合用户团队和历史任务理解意图,再识别实例所属组件,按需展开动态网络拓扑,并通过状态机持续选择工具、分析结果和补充上下文。面对海量异常,Dasheng 聚合关键线索,并将专家经验沉淀为“异常项—网络现象—根因—处置方案”四元组。它把诊断工具、实时拓扑、SOP 和专家经验组织成可动态探索的排障流程,能够根据现场证据调整下一步动作,并通过真实工具核验网络状态和判断结果。
Dasheng 已在生产云环境运行两年,服务 1000+ 名工程师,累计处理约 7 万次可靠性任务,并接入工单与故障处理流程。在生产案例中,92% 的输出能够有效帮助工程师,辅助故障处理使整体耗时缩短约 80%。后续,Dasheng 将进一步完善租户应用拓扑关联,探索跨云服务依赖协作,优化多轮工具调用与信息补全机制,并完善人工介入策略,持续提升复杂场景下的排障效率和操作可控性。

论文下载地址:
https://inno-open.oss-accelerate.aliyuncs.com/open/paper/atc26-dasheng-llm-camera.pdf
资源调度与内存效率
从数据中心级虚拟机迁移路径下沉到单机级透明内存压缩,目标都是在既有硬件上释放更多有效承载能力。
PAMOS:虚拟机调度不能只算终点,还要算出走得通的路径
Beyond Target Placement: Unified Multi-Objective Path-Aware Offline VM Scheduling at Scale
在大规模云集群中,在线调度要在毫秒级为新建虚拟机(VM)选定物理机(PM),只能做出快速但局部的决策。随着次优放置累积及集群环境变化,集群会逐渐积累碎片资源、负载热点、打散违规等“放置债务”。因此,需要依赖离线调度,定期通过热迁移批量调整 VM 位置,以偿还这笔债务,达到更优的集群放置状态。然而,构建生产级离线调度系统并不容易。首先,一个庞大的业务团队需要处理数十种来自不同场景、可能相互冲突的业务需求,并实现集群的综合最优。其次,单个任务最多可能涉及数万台 PM、数十万台 VM,却必须在分钟级 SLO 下完成规划求解。更关键的是,离线调度的产出不只是一个目标布局,而是一条能够切实执行的热迁移序列,现有工作恰恰忽视了这道鸿沟。
论文提出了 PAMOS 离线调度系统。其核心洞察是:合法的目标布局未必能通过可执行的迁移路径到达。因此,PAMOS 摒弃“先求目标布局、再构造路径”的两阶段范式,直接以迁移路径为求解目标,通过“建模—求解—评估”三阶段流水线,在分钟级时延内生成满足生产稳定性约束的迁移序列。
在建模层面,PAMOS 把各类业务需求统一抽象为五种可组合的代价形式,将多目标优化转化为单一的可加代价最小化问题,并用“引力/斥力”的力学类比降低建模门槛。配套的领域专用语言(DSL)让用户只需通过不超过十行代码,即可定义大量复杂业务规则。在求解层面,PAMOS 不预设目标布局,而是以单步迁移为搜索单位增量构建路径,端到端地产出可执行的迁移路径。为满足分钟级规划时延,系统还设计了多种加速机制,通过早停、向量化计算和层级缓存等方式,实现数十倍的求解加速。
在 631 个真实生产问题上,三种“先求目标布局、再构造路径”的两阶段基线方法,在路径构造后损失了超过 80% 的计划迁移,实际优化效果只有 PAMOS 的 14.7%–20.3%。在可精确求解的小规模问题上,PAMOS 的优化效果达到 MIP 最优解的 97.0%,求解速度快四个数量级。PAMOS 已在阿里云稳定运行八年以上,覆盖数百个调度域,每天处理数千个任务;在三个典型业务场景上,平均每次任务将装箱率、打散合规率及生命周期聚集度分别提升 1.41、0.12 和 0.97 个百分点,体现了本系统对集群状态进行多目标综合持续优化的能力。
 图|规则先编译成统一问题,再由主动/被动迁移与路径修复生成候选解,最后验证可行性和收益后执行。来源:论文 Figure 3。
论文下载地址:
https://inno-open.oss-accelerate.aliyuncs.com/open/paper/atc26-beyond-target-placement.pdf
Zswap Boost:为透明内存压缩移除磁盘时代的记账路径
Zswap Boost: Accelerating Transparent Memory Compression in the Cloud
内存是云数据中心最昂贵、也最容易被闲置的资源。Linux zswap 提供了一种无需额外硬件、无需修改应用的透明内存压缩方案,但我们在生产部署中发现,它对延迟敏感型负载存在明显开销。压缩后的内存页明明留在内存中,内核却仍沿用为磁盘设计的换页框架:换页索引、红黑树查找、swap-cache 管理与槽位分配。约 40% 的换入关键路径 CPU 周期消耗在索引结构上,而非解压本身。
Zswap Boost 的核心思路是把压缩页元数据的位置直接编码进页表项:三级查找降为两级,swap-slot、红黑树与 swap-cache 操作整体移出关键路径,从根本上消除这套沿用自磁盘换页框架的额外开销。在此基础上,Zswap Boost 进一步与 Intel IAA 加速器协同,实现批量压缩与异步解压。
实验显示,换入延迟从 6.6–19.9 μs 降至 2.5–4.3 μs,Flink 内核态 CPU 占比从 54.3% 降至 19.0%,节省 12.5% 内存仅付出 2.13% 的性能代价,Redis P99 延迟最多下降 18.5%。包括该技术在内的操作系统内存超卖技术体系,在 Flink 集群中节省了 130 台物理机的资源。
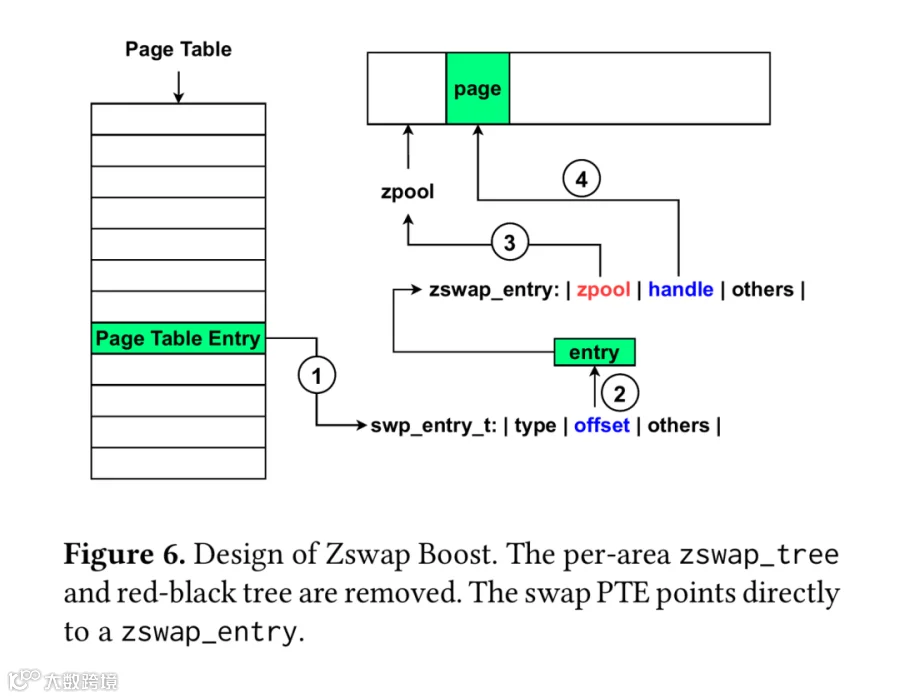 图|swap PTE 直接指向 zswap_entry,移除了每个 swap area 的红黑树索引,缩短换入关键路径。来源:论文 Figure 6。
论文下载地址:
https://inno-open.oss-accelerate.aliyuncs.com/open/paper/atc26-zswap-boost.pdf
网络系统与虚拟化数据路径
一项研究从对象存储与网络基础设施协同优化全局流量成本,另一项则深入虚拟机内部,为安全容器缩短直接网络 I/O 路径。
Lean:让对象存储参与网络路径和带宽成本决策
Lean: Saving OSS Network Cost by Application-Infrastructure Coordination
在超大规模对象存储服务(OSS)中,网络是最大的单项成本,约占每年数亿美元基础设施账单的 40%。其中两层网络开销最大:一是接入网络,客户端流量被锁定在价格高昂的本 Region EdgePoP 上,而带宽价格低 2–5 倍的非本 Region 接入资源早已普遍存在,却无法被利用;二是 Region 内网络,3AZ 冗余存储把每次写入放大为大量跨 AZ 流量,占据网络账单的相当一部分。问题的根源在于,便宜的带宽其实已经就位,但传统分层抽象把网络当作黑盒提供给应用,OSS 无法自行选择接入点、固定转发路径或使用物理隔离的容量,大量已付费的带宽因此闲置。
论文提出 Lean,通过应用与基础设施的协同设计打破这一限制。Lean 以 SRv6 作为统一的底层机制,利用现网设备已有的能力实现三项功能:可部署在任意 EdgePoP 的轻量化接入单元,让只有两台路由器、无人值守的小型站点也能承接 OSS 流量;任意流量调度,使请求的去程和回程都固定经过选定的 EdgePoP;以及 OSS 流量的物理隔离,在共享设备上为 OSS 分配专用端口、OTU 板卡和波长,即“共享设施、专用通道”。Lean 已在阿里云生产环境运行 4 年,服务 O(1B) 级对象和 O(10K) 级企业客户,使 OSS 网络账单下降 55.6%。
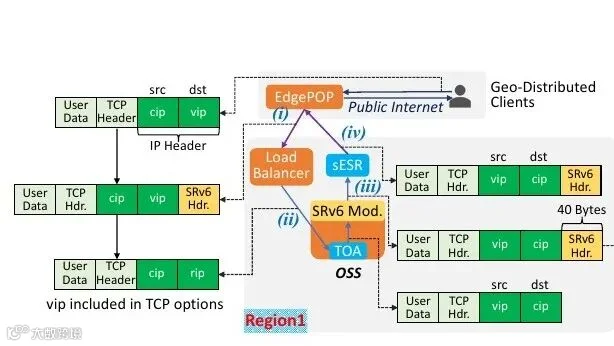 图|Lean 通过 ALB、OSS 侧 SRv6 模块与 EdgePoP 协同固定请求的去程和回程路径。来源:论文 Figure 9。
论文下载地址:
https://inno-open.oss-accelerate.aliyuncs.com/open/paper/atc26-lean.pdf
Courier:不改云 Host,也让安全容器直接访问网络设备
Courier: Host-Transparent Direct Network I/O for Secure Containers in Cloud VMs
安全容器(Kata Containers、RunD)部署在公有云 VM 内部时,形成 Host(L0)→ VM(L1)→ 安全容器(L2)的三层嵌套虚拟化栈。嵌套 CPU/内存虚拟化已有成熟方案,但网络 I/O 仍是瓶颈——para-virtualized 方案(virtio-net/vhost-net)每个包需多次 VM exit 和数据拷贝,吞吐量最高损失 91.7%;VFIO+IOMMU 设备直通需要两级 DMA 地址转换,Intel/AMD 主流 CPU 不支持,公有云也不向租户暴露该力。
Courier 的核心思路是将 DMA 隔离的执行点从 Host 的 IOMMU 层上移到云 VM 的 virtio 协议边界。L2 的 virtio descriptor 显式携带 DMA 缓冲区的 GPAL2 地址,Courier 在 L1 构建 Shadow IOMMU——拦截 L2 的 virtqueue kick,对 descriptor 做快照并校验合法性,再将 buffer 地址从 GPAL2 翻译为 NIC 可消费的 GPAL1,写入 L1 侧的 shadow virtqueue。NIC 的 DMA 仅触及 L1 内存,数据通过 GPAL1 零拷贝直达 L2 buffer,全程无需 L0。
三项数据面优化:(1)Direct Kick——kick 通知从 L1 hypervisor 直接写入 PCI BAR,绕过 QEMU/VFIO;(2)Used-ring Passthrough——shadow used ring 以只读映射暴露给 L2,消除完成通知拷贝;(3)Efficient Interrupt Handling——通过 shadow-flag passthrough 感知队列空满状态、按需抑制中断,消除冗余 VM exit。此外,Courier 在 L1 内实现软件 IOTLB flush 机制,安全支持内存弹性回收。
Courier 已在阿里云生产环境中实现并完成原型验证,约 1700 行客户机内代码,无需 Host 改动。TCP 吞吐较 virtio-net 提升 9.36×,较 vhost-net 提升 96.7%;UDP 延迟分别降低 28.5% 和 20.7%;CloudSuite Data Caching 四节点部署中,P99 尾延迟优于 RunC 原生容器 31.7%。实践表明——将 DMA 隔离上移到协议边界,不用 Host 硬件能力也能实现近原生性能。

图|L1 内的 shadow IOMMU 完成地址重映射与 DMA 隔离,L2 的队列和 buffer 得以绕过 Host 软件数据面直达设备。来源:Courier architecture。
论文下载地址:
https://inno-open.oss-accelerate.aliyuncs.com/open/paper/atc26-courier.pdf
可信硬件与隐私计算
当数据不能离开各参与方时,系统如何利用安全芯片重构 MPC 通信路径,在维持隐私边界的同时降低跨地域机器学习时延。
SwiftMPC:用安全芯片把 MPC 双向通信改成单向流水线
SwiftMPC: Accelerating ML under MPC with Secure-Chip-Assisted One-Way Communication
大模型时代,AI 能力正在向医疗诊断、金融风控、工业智能等关键领域深度渗透。这些场景往往涉及多方敏感数据的联合计算,在数据隐私合规要求日益严格的今天,我们需要安全的技术手段。多方安全计算(MPC)允许多个参与方在不泄露各自数据的前提下联合训练或推理模型。现实计算中,基于 Beaver 三元组的传统 MPC 在每一次安全乘法中使用三元组掩藏秘密,但需要双方交换掩码差值,这种双向通信在完成前会阻塞后续的乘法步骤,从而显著拖慢安全计算。如下图 a 所示。
SwiftMPC 从协议结构的根本上颠覆了这一困局。我们提出了一个关键洞察:如果让一方持有的 Beaver 三元组的前两个分量恰好等于其已有的输入份额,该方的掩码差值将恒为零——这意味着安全乘法所需的双向通信可以被彻底消除,降级为单向通信。通信与计算得以流水线化执行,从根源上解耦了计算执行时间与网络延迟的绑定关系。如下图 b 所示。
SwiftMPC 仅需在 MPC 的其中一个参与方放置一枚功能受限的安全芯片。该芯片不接触任何业务逻辑,只负责根据已有输入份额和与远端同步的随机性生成 Beaver 三元组,并通过受控接口输出所需的三元组份额。芯片内部的硬件根信任用于安全地证明身份并同步种子。芯片功能固定、逻辑极简,便于安全验证,攻击面极小,不会引入对外部可信第三方的信任依赖,也省去了昂贵的密码学三元组生成过程。
围绕这一协议,SwiftMPC 实现了软件与硬件协同设计。在算法层,我们重新设计了算术乘法、布尔 AND、矩阵乘法和卷积四类算子的安全计算流程,全部仅需单向通信并支持流水线执行。在硬件层,我们基于 FPGA 实现了安全芯片原型,将 Beaver 三元组的生成从标量粒度提升到矩阵粒度,与机器学习算子的实际需求精准匹配,单周期可并行处理大量运算。在软件层,我们提供了与 PyTorch 兼容的运行时接口,用户约需修改十行代码,即可将现有模型迁移到 SwiftMPC 上运行。
在 ResNet-18 推理任务中,SwiftMPC 在 65 毫秒网络往返时延下仅需 2.22 秒完成,相比软件方案 CrypTen 加速 28.5 倍,相比此前 SOTA 的硬件辅助 MPC 系统 PPMLAC 加速 1.64 倍。同一时延下,在 Transformer 模型测试中对 CrypTen 的加速比可达 125 倍。即使在 200 毫秒的洲际网络时延下,SwiftMPC 的性能依然几乎不衰减,而传统方案的性能会随延迟线性恶化,此时对 CrypTen 的加速比最高达到 366 倍。在多层感知机、Transformer 等多种模型计算上,SwiftMPC 均展现出一致的性能优势。
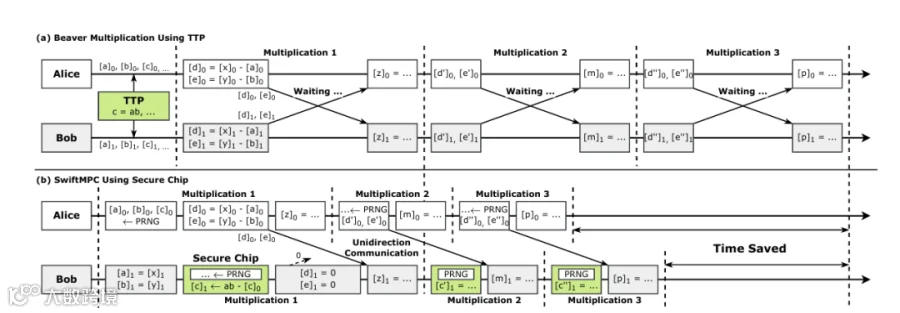 图|传统 Beaver 乘法需要双方交换差值并等待;SwiftMPC 由安全芯片生成对齐三元组,将关键路径改造成单向通信和流水线执行。来源:论文 Figure 1。
论文下载地址:
https://inno-open.oss-accelerate.aliyuncs.com/open/paper/atc26-swiftmpc.pdf
写在最后
这 12 篇论文从工作负载观测一路延伸到模型分发、推理调度、Agent 控制面、操作系统、网络与安全计算,覆盖 AI 进入云上生产环境后的一整条系统链路。
它们呈现出系统研究的共同方法:先从真实瓶颈中找出资源为何浪费、路径为何不可执行、故障为何难解释,再通过架构重组、软硬件协同和可验证实验给出答案。当 AI 的竞争从模型能力走向规模化交付,真正决定服务质量与成本的,往往正是这些藏在模型之下的系统问题。