

阿里妹导读
文章内容基于作者个人技术实践与独立思考,旨在分享经验,仅代表个人观点。
一、业务背景:策略效果类 Agent 的评测难题
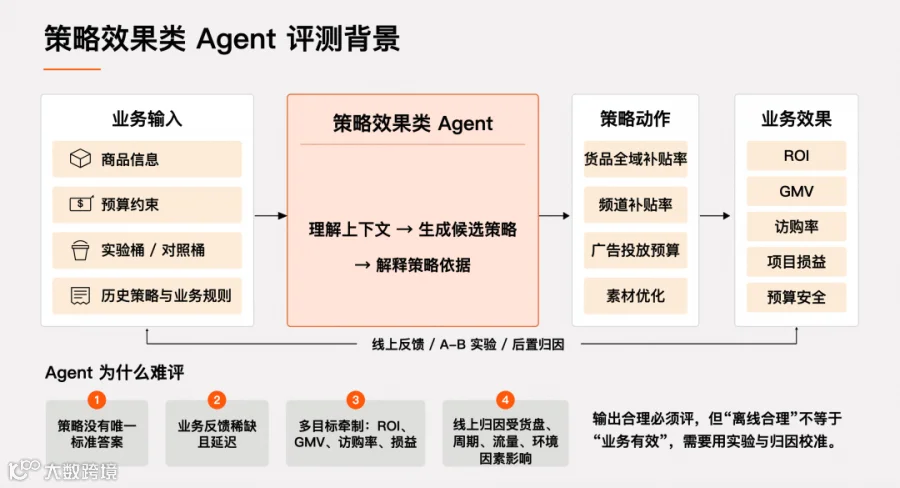
策略效果类 Agent 的核心挑战并非“能否生成策略”,而是规模化生产后的质量持续保证。与问答或代码生成等任务不同,其输出是直接影响大盘指标(如 ROI、GMV)的业务策略,且缺乏唯一的标准答案。商品营销场景中,输入数据动态变化,线上效果受环境、货盘等多因素干扰,导致离线评估与线上表现往往脱钩。
主要难点体现在三个方面:
- 反馈信号稀缺且延迟:线上 A/B 实验资源有限,积累的偏好对数量不足以支撑稳定的评估体系构建。
- 多维权衡的动态评估:策略优劣需在 ROI、GMV、预算安全等多指标间权衡,且“好”的定义随业务阶段动态变化。
- 离线与线上的鸿沟:离线合理的策略在线上可能因环境噪声失效,单纯依赖离线 Judge 打分易与真实业务效果脱节。
因此,需构建一套连接离线判断与线上效果的方法论,解决“评什么、怎么评、如何建立连接”的问题。
二、评测方法论:五层、四步、三阶段
构建从业务目标出发,经多层质量判断,最终驱动 Agent 优化的闭环链路。

1. 五层评测对象:回答“评什么”
将策略类 Agent 的评测拆解为五个层级,覆盖从输入约束到持续监控的全链路,避免问题混同诊断。
| 层级 | 核心问题 | 关键指标 | 评测方式 |
| L1 Prompt 约束层 | 提示词目标与规则是否清晰自洽 | Prompt 内在矛盾数 | LLM Prompt 静态审查 |
| L2 知识与经验层 | 运营经验及决策依据是否正确召回 | 上下文召回覆盖率/正确率、引用准确度 | Rule 引用统计/回放/核验、LLM 一致性评测 |
| L3 任务执行层 | 模型推理和工具使用是否稳定正确 | 字段合法性、工具执行准确率、硬约束通过率 | Rule Schema/参数校验、Pass@N、LLM 格式/事实性校验 |
| L4 业务效果层 | 策略是否带来可验证的业务增量 | ROI/GMV 提升、访购率、预算消耗 | LLM Pairwise 对比、A/B 实验、DT 归因/灰度 |
| L5 自动化 Benchmark | 版本可持续回归与准入 | 版本退化率、Bad Case 回归 | 自动化回归跑批、版本对比 |
五层逐层递进:L1 不稳定则后续评测不可信;L2 错误导致 L3 执行正确但策略方向偏差;L3 通过但 L4 不达标说明评估器未对齐业务目标。
2. 三层评测方法:回答“怎么评”
根据问题的确定性程度,采用三层递进的评测方法:
| 层级 | 方法 | 解决的问题 | 优势 |
| 规则层 | Rule-based Judge | 字段缺失、预算超限等硬错误 | 边界清晰,可 100% 自动化低成本覆盖 |
| 模型层 | LLM-as-a-Judge | 策略合理性、上下文忠实性、推理质量 | 具备推理判断能力,覆盖规则无法处理的复杂逻辑 |
| 实验层 | A/B 实验 | ROI/GMV 等真实业务效果 | 唯一能反映真实业务价值的验证手段 |
3. 评测数据集构建原则
数据集设计核心在于“失败模式的覆盖广度”,分为三批建设:
- 基础能力验证:常规测试集(主流程)、回归测试集(防退化)、Bad Case 集(问题沉淀)。
- 边界与风险探测:线上回流集、对抗样本集(极端输入)、红队样本集(诱导攻击)、安全样本集(资金/合规风险)。
- 评估器能力验证:Judge 验证集,用于监控评估器自身的准确性与泛化性。
建设原则:比例由风险决定而非频率;数据集需持续保鲜;评估器本身需进行能力验证以防过拟合。
4. 四步质量归因:回答“评完怎么办”
建立从发现问题到优化动作的闭环:
- 分层诊断:对各层级独立评分,定位异常层。
- 根因定位:在异常层内下钻,区分是 Prompt 冲突、召回错误还是评估器过拟合。
- 路由优化:根据根因进入不同优化通道(如优化 Prompt、DPO/SFT 训练、重校准 Rubric)。
- 回归验证:所有优化必须回到评测体系中闭环验证,确保无退化。
5. 三阶段上线治理:回答“能不能上”
| 阶段 | 核心动作 | 准入/通过条件 | 熔断/降级红线 |
| 第一阶段 上线前准入 |
变更绑定回归测试 | 规则硬约束 100% 通过;关键 LLM Judge 无退化 | 任一指标未达标,直接阻断 |
| 第二阶段 灰度放量 |
梯度放量与多桶比对 | ROI 达标、GMV 不跌、异常率低 | 连续 2 天 ROI 跌破对照或异常率超基线 2 倍 |
| 第三阶段 线上监控 |
归因与数据回流 | 线上指标持续处于安全区间 | 硬约束违反率超基线 3 倍、ROI 连续 3 天跌破对照等 |
技术细节要点:
- 变更绑定回归:回归范围应与变更影响域对齐,平衡风险与成本。
- 灰度分桶:引入稳定性验证桶(跑上一版本策略),区分策略问题与环境噪声。
- 归因分流:首先判断是 Agent 问题还是结构性问题(如外部环境变化),避免误判。
三、落地实践经验:解决离线与线上的对齐难题
1. 核心思路:Auto Rubrics 替代黑盒 Reward Model
传统神经网络 Reward Model 存在黑盒、冷启动难、解释性差等局限。我们采用结构化的 Rubrics(自然语言规则)结合 LLM-as-Jude 方案。Rubrics 具备可解释性,且可通过 Auto Rubrics 方法从历史数据中自动挖掘生成,降低冷启成本并支持动态演化。
2. LLM-as-Judge 的三个系统性陷阱

- 位置偏差:LLM 倾向于判定后出现的 Response 更优。需通过 A/B 位置随机化消除,否则训练集高准确率可能是虚假信号。
- 选择过拟合:贪心算法选出的 Rubric 子集可能仅对当前样本有效。需通过 Stability Selection(稳定性选择)和交叉验证来确保泛化能力。
- 一致性 ≠ 正确性:模型可能稳定地判错。需同时关注一致性和正确性,利用多轮独立验证 + 一致性过滤作为置信度机制。
3. Auto Rubrics 全流程

Pipeline 包含 7 步:数据模式分析 → Rubric 生成 → 语义去重 → 交叉验证 → 端到端验证 → Memory 增量更新 → 运行报告。核心是从偏好对中自动提取、验证并沉淀可解释的评估标准。
4. 基于 Rubrics 的可信评测体系构建
(1) 从“打分”到“比较”
人工打分存在天花板、目标变更失效及难以对齐等问题。我们将问题转化为二元偏好判断(Chosen vs Rejected),构建 DPO 偏好数据集,关注策略相对于基准的增量贡献。
(2) 三层 Rubric Judge 架构

- Layer 1 供给层:通过“对比挖掘隐性规则”和“数据模式分析+多轮采样”两条路线,从数据中自动挖掘候选 Rubric。
- Layer 2 筛选层:
- 双侧验证:统计好坏 Case 的违反率,筛选出在 Bad Case 中高违反、Good Case 中低违反的强规则。
- 比较评估 + 位置交换:将绝对判断改为对比判断,并随机化位置,提升判断稳定性。
- 稳定性筛选 + 交叉验证:通过 Bootstrap 采样和 5-Fold 交叉验证,排除过拟合噪声的规则,确保泛化性。
- Layer 3 验证层:用筛选出的 Rubrics 对偏好对进行多次独立判断,仅保留结论一致且方向正确的数据作为 Golden Set,用于最终 DPO 训练。
(3) 与传统 Reward Model 对比
| 维度 | 传统神经网络 RM | Rubric-based 评测体系 |
| 可解释性 | 黑盒打分 | 自然语言规则,可审查修改 |
| 数据需求 | 大量标注数据 | 少量偏好对即可提取 |
| 迭代速度 | 重新训练模型 | 重跑 Pipeline 即可 |
| 调试能力 | 难以定位 | 逐条 Rubric 定位失误 |
5. 延伸应用:最优策略收敛判断
判断策略是否收敛需过滤数据噪声,采用四层漏斗机制:
- 量级过滤:排除低成交量、数据缺失样本。
- 时间一致性:要求连续多天指标方向一致。
- 稳定性评分:利用贝叶斯收缩量化可信度,综合达标天数、波动等打分。
- 组合口径验证:将多个商品组合验证,抵消个体随机噪声,输出最终收敛集合。
此方法与 Rubric 筛选复用同一核心思路:高精度优于高覆盖,通过稳定性筛选和组合验证确保结论可信。
四、结语
Agent 评测是驱动系统持续进化的基础设施,核心在于实现可评(分层指标、可信数据集)、可控(准入护栏、灰度回滚)和可迭代(结果回流优化)。关键在于认识到“评估器本身也需要被评估”,需持续校准 Judge 的一致性、稳定性和泛化能力,避免虚假信心带来的风险。