

直观反应通常是设置最大步数。这虽能防止无限运行,但并未触及核心:若 Agent 反复调用同一工具并收到相似报错,即便未达步数上限,时间和 Token 消耗已不可忽视。强制停止后,仍需复盘其“原地打转”的根本原因。
看似简单的题目,经层层追问,方能检验对技术细节的掌握程度。
01超越“限制步数”的多维管控
仅设置最大执行步数存在局限,因为每一步的耗时与 Token 消耗并不均等。因此,完善的管控机制应包含三项阈值:最大步数、总耗时和 Token 消耗。任意一项触顶,系统即应终止执行。

此外,需提前识别无效循环:若多次工具调用的参数、报错及任务状态无实质变化,继续执行已无意义。系统应具备检测重复调用和评估任务进展的能力,明确完成标准与退出条件。
注意:这些限制必须由代码逻辑强制执行,而非仅依赖 Prompt 中提醒模型“适时停止”。
面试官常进一步追问:“如何判断无进展?”“停止后返回何种信息?”“任务是否可恢复?”。这些问题将理论概念拉回具体工程实践,极具考察价值。
02RAG 效果不佳的排查逻辑
另一道典型自测题为:RAG 系统上线后效果不好,如何排查?若直接回答“更换更优模型”,往往会被追问依据。
需区分两类问题:
- 检索失败:正确资料未被召回。需检查文档分块合理性、查询表达清晰度及检索相关性。
- 生成失败:资料已找到,但回答未基于资料。需检查模型对上下文材料的忠实度。

优化时切忌同时调整分块、Embedding 和 Prompt。建议固定一组代表性问题,采用控制变量法,每次仅调整一个因素并对比结果。清晰阐述“排查顺序、依据及验证方法”,比罗列技术名词更能体现专业深度。
03150 道题:构建系统化自测清单
上述题目源自《150 道 AI 面试题知识库》。该内容涵盖 14 个主题,包括大模型基础、API 与结构化输出、Prompt 工程、RAG、Agent 架构,以及部署、评估、生产可靠性、安全和成本管控。

该题库适用于准备 AI 应用开发岗位面试者,或希望查漏补缺的项目开发者。建议根据当前项目阶段针对性复习:
- 知识库问答项目:重点关注 RAG、数据工程及应用侧评估。
- Agent 开发项目:聚焦工具调用、上下文管理、中断恢复及权限边界。
- 即将上线项目:梳理重试机制、限流降级、成本监控等生产级问题。
无需线性刷题,优先攻克与自身项目最相关的模块,结合实战案例深化理解。
04从单点知识到系统设计思维
掌握单点知识后,需进一步应对连续追问。配套资料《AI Agent 系统设计面试现场面试题答案》以思维导图形式,串联检索、意图识别、上下文管理、执行核心、评估反馈等关键环节,并提供模拟面试题。
例如,针对 RAG 的追问链路可能为:文档入库类型 -> 切分后的 Metadata 保存 -> 召回结果如何交付模型。针对评估环节,则涉及 LLM-as-a-Judge 的原理、输入构成、错误发现机制(如人工标注样本一致性校验)。

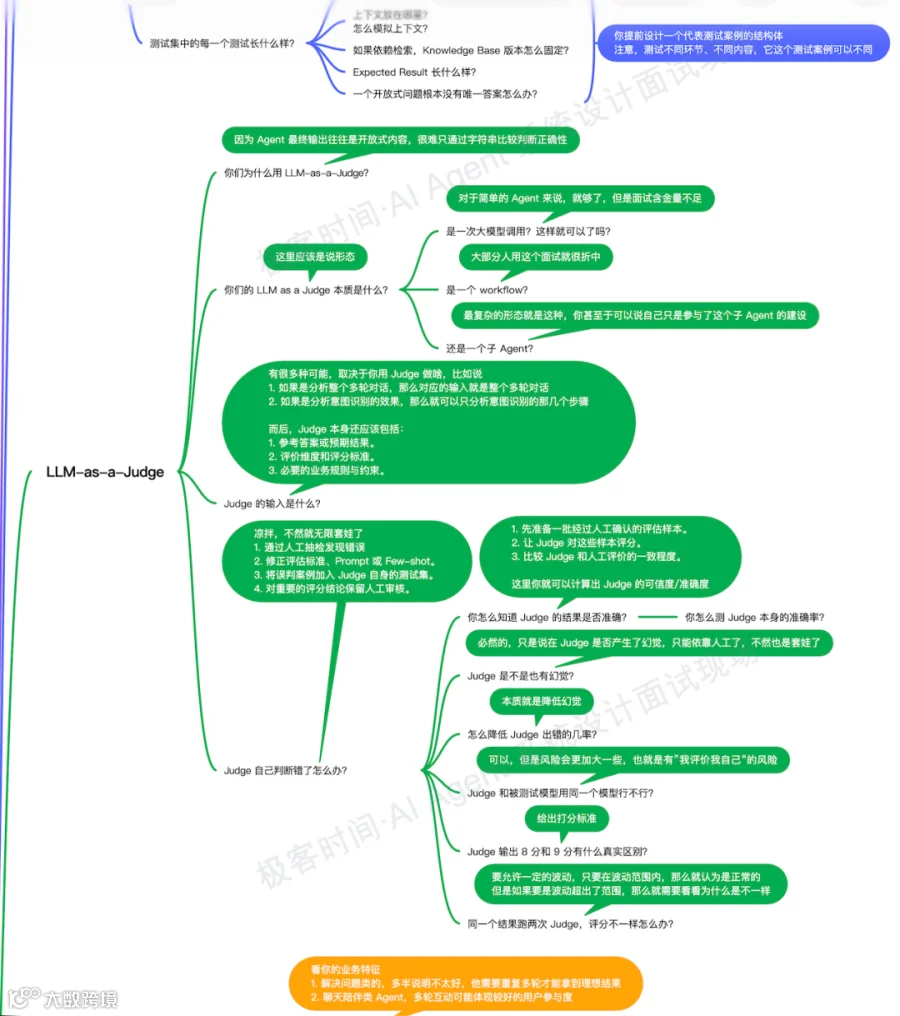
意图识别部分则延伸至上下文加载、工具调用、输出格式校验及权限控制的衔接。

150 道题用于查漏补缺,配套资料用于训练系统设计与连贯应答能力。建议结合导图中的追问清单,基于自身项目背景进行预演,并在技术选型、阈值设定等方面提供具体业务依据。
05实战演练:遮住答案,独立复述
阅读答案时的“懂”与独立表达的“通”存在差距。建议在复习时,选取若干题目,遮住答案并尝试回答以下三个核心问题:
① 如何定位问题根源?
② 为何选择该方案?其适用边界何在?
③ 如何通过结果验证方案有效性?
若在表述中出现卡顿,再回顾答案并补充项目实例。这种训练方式有助于将零散知识串联成体系,提升面对变种问题时灵活应对的能力。
下次遇到看似熟悉的题目,不妨先遮挡答案,尝试独立推导与陈述。