

许多初次尝试本地部署大模型的用户常陷入显存估算误区。常见情况是:依据“7B 模型 FP16 约需 14 GB”的理论值,认为 16 GB 显存显卡绰绰有余,但实际加载时却遭遇 OOM(显存溢出)。
问题核心在于,仅计算了模型权重,忽略了 KV Cache、推理框架开销及显存碎片。在长上下文或高并发场景下,KV Cache 的占用甚至可能超过权重本身。
一、先算对权重:一个公式,三条口诀
核心计算公式如下:
显存(GB) = 参数量 × 单参数字节数 ÷ 1024³
其中 1 GB = 1024³ = 1,073,741,824 Byte
不同精度对应的单参数字节数:
|
|
|
|
|---|---|---|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
速记口诀:
- FP16:每 1B 参数 ≈ 2 GB
- INT8:每 1B 参数 ≈ 1 GB
- INT4:每 1B 参数 ≈ 0.5 GB
常用规模模型权重的理论显存参考:
|
|
|
|
|
|
|
|---|---|---|---|---|---|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
二、为什么实际总比理论值大
上述为理想状态下的数值,实际运行中还需考虑以下两部分额外开销。
量化元数据
INT4 / INT8 量化(如 GPTQ、AWQ)需要额外存储缩放系数和零点。经验数据显示:
-
INT8:比理论值多 1%~5%,影响较小; -
INT4:通常在理论值基础上增加 5%~15%。例如 7B INT4 理论值为 3.26 GB,实际加载常见 3.5~3.7 GB。
框架与碎片
CUDA context、推理框架(如 vLLM / Transformers)的常驻占用以及显存碎片,通常需预留 1~2 GB,且并发越高占用越多。
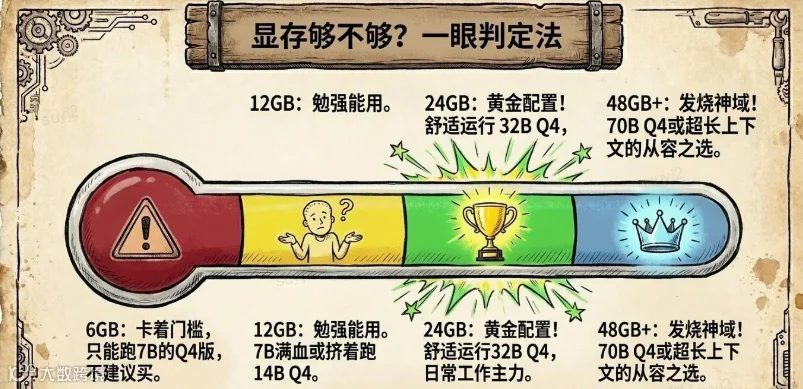
选卡建议:计算出总需求后,建议乘以 1.1 作为余量。若配置刚好卡在显存上限,极易因碎片问题导致运行失败。
三、真正的大头:KV Cache
KV Cache 是最易被忽略且容易计算错误的项目。它是注意力机制为避免重复计算而缓存的历史 K、V 矩阵,其大小随上下文长度和并发数线性增长。
完整计算公式:
KV(GB) = 2 × 层数 × KV 头数 × 头维度 × 上下文长度 × batch × KV字节数 ÷ 1024³
注:系数 2 表示 K 和 V 两份;KV 通常按 FP16 存储,故字节数取 2。
常见错误:网上部分公式遗漏了 KV 头数。以 Llama2-7B 为例,遗漏此项会导致计算结果相差 32 倍——4k 上下文下错误结果为 0.06 GB,而正确值为 2.00 GB。
此外,不同架构的 KV 头数差异巨大。采用 GQA(分组查询注意力)的模型能大幅压缩 KV 头数:
以 7B 模型、32k 上下文、batch=1 为例:Llama2-7B 的 KV 占用为 16 GB,而 Qwen2-7B 仅为 1.75 GB。因此,选择模型时不能仅看参数量,KV 头数直接决定长上下文成本。
Batch size 是另一个关键乘数。对于 Llama2-7B,在 32k 上下文、batch=4 时,仅 KV 一项就高达 64 GB,接近权重的 5 倍。这也是生产环境中显存瓶颈通常出现在 KV 而非权重的原因。
四、训练显存:不是一回事
训练与推理的显存构成截然不同,不可混用同一套算法。以下是混合精度 + AdamW 优化器的典型构成(每参数字节数):
|
|
|
|
|---|---|---|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
| 合计 | 16 |
|
7B 全参数训练约需 104 GB 显存(未包含激活值)。开启 gradient checkpointing 可显著降低激活值占用,但会增加一次前向计算的成本。
五、一个脚本,输入三个数就出结果
为方便快速估算,可将以下公式固化为 Python 脚本 vram_calc.py:
#!/usr/bin/env python3# -*- coding: utf-8 -*-"""大模型显存估算器 —— 权重 + KV Cache + 训练,一次算清。用法:python vram_calc.py --params 7 --dtype fp16 # 只算权重python vram_calc.py --preset llama2-7b --ctx 8192 --batch 8python vram_calc.py --preset qwen2-7b --ctx 32768 --batch 1 --dtype int4python vram_calc.py --params 7 --train # 训练显存python vram_calc.py --list # 查看内置预设"""import argparseGB = 1024 ** 3 # 1 GB = 1,073,741,824 ByteBYTES_PER_PARAM = {"fp32": 4.0, "fp16": 2.0, "bf16": 2.0, "int8": 1.0, "int4": 0.5}# 量化额外开销系数(缩放系数、zero-point 等元数据)QUANT_OVERHEAD = {"fp32": 1.00, "fp16": 1.00, "bf16": 1.00, "int8": 1.03, "int4": 1.10}# params(B), layers, kv_heads(GQA 时小于 Q 头数), head_dimPRESETS = {"llama2-7b": {"params": 7, "layers": 32, "kv_heads": 32, "head_dim": 128},"llama2-13b": {"params": 13, "layers": 40, "kv_heads": 40, "head_dim": 128},"llama2-70b": {"params": 70, "layers": 80, "kv_heads": 8, "head_dim": 128},"qwen2-7b": {"params": 7, "layers": 28, "kv_heads": 4, "head_dim": 128},"qwen2-72b": {"params": 72, "layers": 80, "kv_heads": 8, "head_dim": 128},"baichuan2-13b": {"params": 13, "layers": 40, "kv_heads": 40, "head_dim": 128},}def weight_gb(params_b, dtype="fp16", with_overhead=True):"""权重显存(GB)。params_b 单位为 B(十亿)参数。"""dtype = dtype.lower()raw = params_b * 1e9 * BYTES_PER_PARAM[dtype] / GBreturn raw * QUANT_OVERHEAD[dtype] if with_overhead else rawdef kv_gb(layers, kv_heads, head_dim, ctx, batch=1, dtype="fp16"):"""KV Cache 显存(GB)。2 表示 K 和 V 两份。"""bpe = BYTES_PER_PARAM.get(dtype.lower(), 2.0)return 2 * layers * kv_heads * head_dim * ctx * batch * bpe / GBdef train_gb(params_b, master_weights=True):"""训练显存粗估(GB),AdamW:权重2 + 梯度2 + m4 + v4 (+ 主副本4)。"""per_param = 2 + 2 + 4 + 4 + (4 if master_weights else 0)return params_b * 1e9 * per_param / GBdef suggest_card(total):for card in (8, 12, 16, 24, 32, 40, 48, 80, 141):if total <= card * 0.92:return f"建议 ≥ {card} GB 显存(已含 8% 余量)"return "单卡装不下,考虑多卡张量并行或 Offload 到内存"def report_infer(cfg, ctx, batch, dtype):w = weight_gb(cfg["params"], dtype)k = kv_gb(cfg["layers"], cfg["kv_heads"], cfg["head_dim"], ctx, batch)runtime = 1.0 + 0.05 * batch # 框架、CUDA context、碎片total = w + k + runtimeprint(f"\n模型:{cfg['params']}B 精度:{dtype.upper()} "f"上下文:{ctx} batch:{batch}")print("-" * 58)print(f" 权重显存 {w:8.2f} GB")print(f" KV Cache {k:8.2f} GB (layers={cfg['layers']}, "f"kv_heads={cfg['kv_heads']}, head_dim={cfg['head_dim']})")print(f" 框架/碎片预留 {runtime:8.2f} GB")print(f" {'-' * 40}")print(f" 合计估算 {total:8.2f} GB")print(f" {suggest_card(total)}")print("\n 同一 batch 下,KV Cache 随上下文长度变化:")for c in (2048, 4096, 8192, 16384, 32768):kc = kv_gb(cfg["layers"], cfg["kv_heads"], cfg["head_dim"], c, batch)print(f" ctx={c:<7} KV {kc:7.2f} GB 合计 {w + kc + runtime:7.2f} GB")if __name__ == "__main__":ap = argparse.ArgumentParser(description="大模型显存估算器")ap.add_argument("--params", type=float, help="参数量,单位 B")ap.add_argument("--dtype", default="fp16", help="fp16/bf16/int8/int4/fp32")ap.add_argument("--preset", help="内置模型预设")ap.add_argument("--ctx", type=int, default=4096)ap.add_argument("--batch", type=int, default=1)ap.add_argument("--train", action="store_true")ap.add_argument("--list", action="store_true")args = ap.parse_args()if args.list:for name, c in PRESETS.items():print(f"{name:<16}{c['params']:>4}B layers={c['layers']:<3} "f"kv_heads={c['kv_heads']:<3} head_dim={c['head_dim']}")elif args.train:print(f"\n训练显存粗估({args.params}B, AdamW 混合精度)")print(f" 含 fp32 主副本 {train_gb(args.params):8.2f} GB")print(f" 不含主副本/8bit {train_gb(args.params, False):8.2f} GB")elif args.preset:report_infer(PRESETS[args.preset], args.ctx, args.batch, args.dtype)elif args.params:print(f"\n{args.params}B 权重显存:")for d in ("fp16", "int8", "int4"):print(f" {d.upper():<5} 理论 {weight_gb(args.params, d, False):7.2f} GB"f" 含量化开销 {weight_gb(args.params, d):7.2f} GB")else:ap.error("需要 --params 或 --preset(或 --list)")
以 Llama2-7B、4k 上下文、batch=1 为例运行:
$ python vram_calc.py --preset llama2-7b --ctx 4096 --batch 1

模型:7B    精度:FP16    上下文:4096    batch:1
----------------------------------------------------------
  权重显存             13.04 GB
  KV Cache              2.00 GB   (layers=32, kv_heads=32, head_dim=128)
  框架/碎片预留          1.05 GB
  ----------------------------------------
  合计估算             16.09 GB
  建议 ≥ 24 GB 显存(已含 8% 余量)

  同一 batch 下,KV Cache 随上下文长度变化:
    ctx=2048    KV    1.00 GB   合计   15.09 GB
    ctx=4096    KV    2.00 GB   合计   16.09 GB
    ctx=8192    KV    4.00 GB   合计   18.09 GB
    ctx=16384   KV    8.00 GB   合计   22.09 GB
    ctx=32768   KV   16.00 GB   合计   30.09 GB
由此可见,13.04 GB 的权重加上 2 GB 的 KV Cache 和 1 GB 的框架开销,总需求达到 16.09 GB,16 GB 显存确实无法承载。
六、三个常见误区
- 把模型文件大小当成显存。
HuggingFace 上 safetensors 文件的大小约等于理论权重显存,但加载进 GPU 还需额外计入 KV Cache、框架开销和碎片。 - 认为 INT4 严格等于 0.5 字节。
GPTQ / AWQ 等量化方法包含元数据,实际占用会多出 5%~15%。 - 忽略 KV Cache。
在短上下文、单并发场景下其占用较小;但在长文本或多并发场景下,瓶颈几乎一定在 KV Cache,而非权重。
写在最后
掌握以下核心原则,可有效避免显存估算错误:
权重取决于参数量和精度,KV Cache 取决于层数、KV 头数和并发,训练显存则需单独计算。
权重是一次性固定成本,而 KV Cache 是随用量线性增长的可变成本。仅按参数量估算显存,如同仅按车重估算油耗,忽略了行驶距离和载人数这两个关键变量。
未来在评估模型显存需求时,请先确认两个关键指标:计划运行的上下文长度是多少?并发数是多少?