

摘要 1. 开源 Apache Flink 是业界流计算事实标准,但在极端重负载场景下存在性能瓶颈。 2. 华为大数据 Flink 通过自研深度优化,在执行计划、算子执行、状态存储三个层面构建协同优化体系。 3. Nexmark Benchmark 测试显示:整体性能提升 5.74 倍,极端重负载场景性能领先最高达 18.3 倍。 4. 100% 兼容 Apache Flink 1.20,业务代码零改造,支持无缝迁移。 |
背景与挑战
Apache Flink 作为业界流计算的事实标准,原生支持低延迟流处理与有状态计算,已广泛应用于电商、金融、物流及车联网等行业的实时数据场景。然而,开源 Apache Flink 在极端重负载场景下面临显著的性能瓶颈:双流 Join 状态访问导致 IO 放大、TopN 算子需进行全 Key 范围扫描、链式 Join 引发状态几何级数膨胀、以及算子间对象拷贝导致的 GC 抖动。这些问题迫使企业通过堆叠计算资源来应对高吞吐需求,推高了运营成本。
基于多年生产实践,华为大数据 Flink 团队针对上述瓶颈进行了多项自研深度优化,从根源上提升引擎的执行效率与状态访问能力。本次测试以业界通用的 Nexmark Benchmark 为基准,在同等计算资源下对比华为大数据 Flink 1.20 与开源 Apache Flink 1.20 的性能表现,以验证优化效果。
核心技术:多项自研深度优化
开源 Apache Flink 的性能瓶颈具有传导性,从执行计划、算子执行到状态存储层层影响:链式 Join 导致中间状态膨胀,算子间频繁新建对象触发 GC 抖动,状态读写放大增加磁盘 IO。单点优化往往只能暂时缓解某一环节的瓶颈,问题很快会在其他环节重现。
华为大数据 Flink 摒弃零散修补路线,基于 Flink 引擎的层次化架构,沿三条主线进行系统性优化:
执行计划层:大幅压缩状态规模
在多表关联场景下,开源实现通常将一条 SQL 拆解为多个串联的两两关联算子,每经过一层关联便落地一份中间结果,导致状态规模随表数量成倍放大,成为高负载场景下内存与磁盘 IO 压力的主要来源。华为大数据 Flink 在执行计划层通过合并多路关联、剪枝无结果分支,从源头减少中间状态,使后续算子执行层和状态存储层基于更小的状态规模进行处理。
算子执行层:消除冗余计算
开源实现中,算子间逐条记录传递数据,伴随新建对象与序列化开销,高频函数的重复解析进一步加剧 CPU 浪费并引发频繁 GC 抖动。华为大数据 Flink 在算子执行层通过复用传递对象、共享函数计算结果,消除冗余计算与重复分配,让 CPU 与内存资源更高效地服务于业务逻辑,而非消耗在框架开销上。
状态存储层:加速状态读写
有状态流计算的性能高度依赖状态读写效率。开源实现的状态更新遵循“读-改-写”循环,每次更新需两次访问磁盘;状态查询则需扫描全部底层文件,无效 IO 占用大量带宽。华为大数据 Flink 在状态存储层将更新改为增量合并写入,查询采用前缀索引快速定位,使状态读写 IO 减半、无效 IO 大幅降低。节省的带宽反哺算子执行,形成性能优化的正向循环。
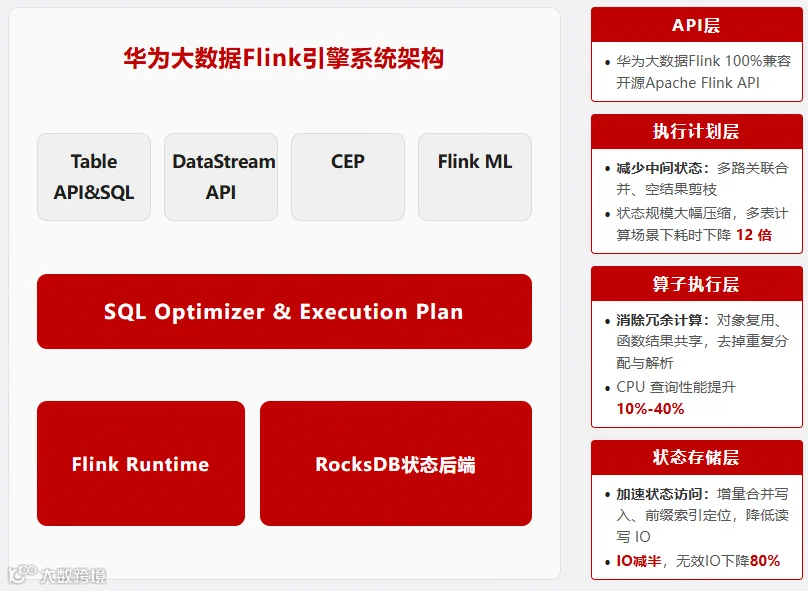
上述三条主线相互衔接、层层递进:状态规模的缩减降低了算子执行与状态存储的处理负担,状态读写性能的提升进一步释放了算子执行的瓶颈。所有优化均在引擎内部完成,对外 API 与语义 100% 兼容开源版本,实现业务代码零改造。这套体系最终使整体性能达到开源版本的 5.74 倍,极端重负载场景领先最高达 18.3 倍。
性能测试结论
测试结果显示,华为大数据 Flink 1.20 在处理全部 Query 时的总耗时仅为 12,854 秒,而开源 Apache Flink 1.20 需要 73,738 秒,整体性能提升 5.74 倍。以下为 Nexmark 各 Query 耗时对比。
