上一篇讲 rubric:《没有标准答案的题,怎么打分?| 模型评测 Rubric 入门》今天往上搭一层:一条条 rubric、一道道题,怎么组成一张考卷。
很多人以为 benchmark 就是「一堆题 + 一个排行榜」。但真正做过 benchmark 的人都知道,题目本身往往是最容易的部分。难的是另外几个问题:
今年 2 月,OpenAI 宣布不再报告 SWE-bench Verified 的分数。这张曾经最权威的代码考卷在这几个问题上全都出了状况,所以今天就从它的「退役报告」讲起。
一、一张考卷由什么组成
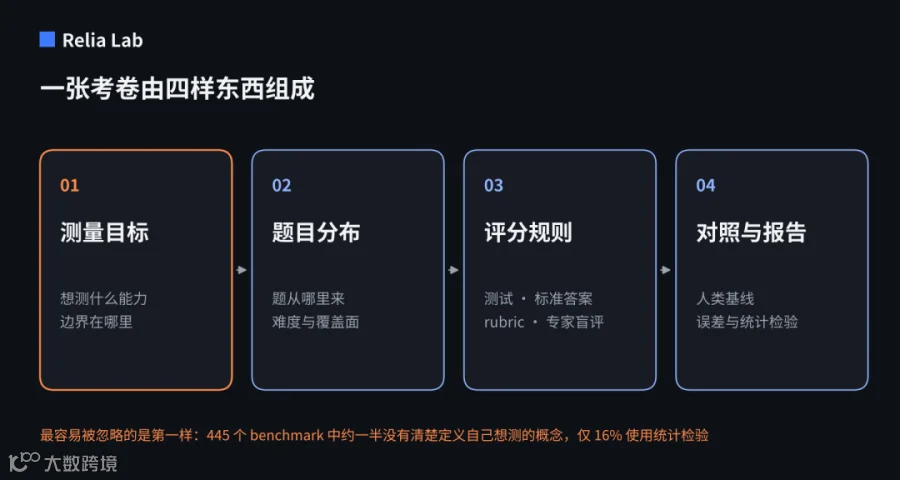
rubric 回答的是「这道题答得好不好」,benchmark 回答的是「这个模型在某种能力上处于什么位置」。后者需要四样东西:
-
-
题目分布:用哪些题来代表这种能力,题的来源、难度和覆盖范围
-
评分规则:单元测试、标准答案、rubric,或者专家盲评
-
对照与报告:和谁比(人类专家、上一代模型),分数怎么汇总,误差有多大
四样里最容易被忽略的是第一样。牛津大学互联网研究所等机构在 NeurIPS 2025 发表的研究 Measuring what Matters,系统审查了 445 个 LLM benchmark,发现:
-
大约一半的 benchmark 想测「推理」「无害性」这类抽象概念,却没有给出清晰定义
-
如果连「推理」指的是什么都没说清楚,那么在这张考卷上从 70 分涨到 75 分,没有人能说清楚到底什么变强了。测量目标模糊,后面题出得再多也只是在堆数据。这在心理学和医学里叫「构念效度」,AI 评测领域直到最近才开始认真对待它。
明确了要测什么,接下来是出题。过去几年,主流 benchmark 的题目来源大致可以分成三条路线,每条都有代表作,也有各自的问题。
路线一:从现成数据里采,以 SWE-bench 为代表
SWE-bench 的题来自真实的 GitHub 仓库:找一个已经被修复的 issue,把代码回退到修复前,让模型去修,再用原仓库里的单元测试判断修得对不对。后来又由人工筛出 500 道质量更好的题,即 SWE-bench Verified。
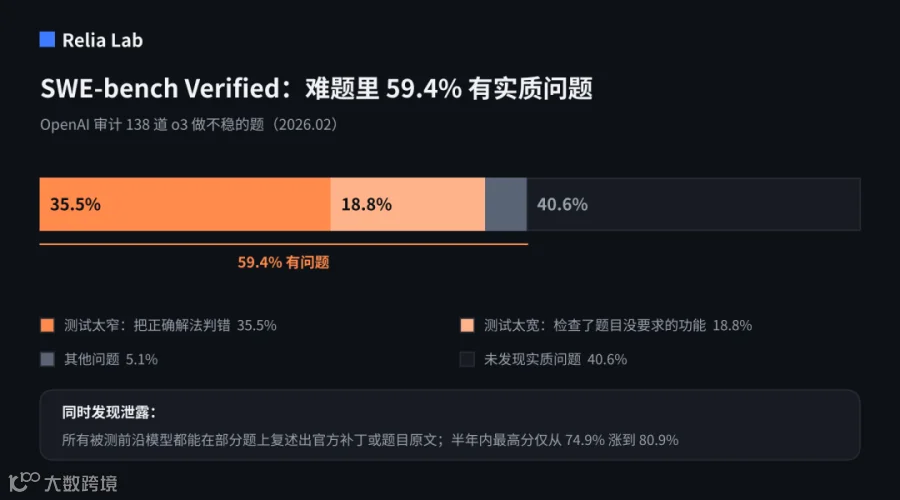
这条路线的好处是真实、便宜、规模大。问题在今年 OpenAI 的审计里暴露得很清楚:
-
他们抽查了 138 道连 o3 都做不稳的难题,其中 59.4% 的题目或测试存在实质性问题
-
-
18.8% 的测试太宽,检查了题目根本没要求的功能
-
所有被测的前沿模型都能在部分题上复述出官方补丁或题目原文,说明这些题已经进了训练数据
-
过去六个月,最高分只从 74.9% 涨到 80.9%,剩下的分数越来越像在测「谁见过答案」
我们的观察: 从公开数据里采题,等于把考题放在了所有考生的复习资料里。题目来自 GitHub,模型也在 GitHub 上训练,泄露几乎是迟早的事。而且原仓库的单元测试是给工程师用的,不是为「判断一个解法对不对」设计的,这正是上一篇说的「评分器到底靠不靠谱」的问题。
路线二:专家对抗出题,以 HLE 为代表
「人类最后的考试」(Humanity's Last Exam,HLE)走的是另一条路:向全球各领域专家众包题目,并且先让前沿模型做一遍,模型做得出来的题直接淘汰,做不出来的才进入两轮专家审核。
-
-
设置了 50 万美元奖金池,最好的 50 道题每道奖励 5000 美元
-
另外保留了一份私有题集,用来检测模型是否对公开题过拟合
这种「对抗筛选」让 HLE 在发布时极难,最强模型的正确率都不到 10%。到今天,前沿模型在纯文本子集上的最高分已经接近 60%。
但对抗筛选有一个副作用:被留下来的题,有一部分不是因为难,而是因为错。 独立研究机构 FutureHouse 检查后认为,HLE 纯文本化学和生物题里大约 30% 的标准答案可能有误。原因不难理解,模型答不出、专家审核又没细查的题,本身就更可能有问题。HLE 团队部分复现了这个结论,后来推出了持续修订的 HLE-Rolling。
对抗筛选解决了「太简单」的问题,却引入了「题目本身错了」的风险。越难的题越需要更多专家交叉验证,而这恰恰是最贵的部分。
路线三:从真实工作里采,以 GDPval 为代表
OpenAI 在 2025 年发布的 GDPval 换了一个问题:不问模型会不会做难题,而是问它能不能完成真实工作里有经济价值的任务。
-
覆盖美国 GDP 前 9 大行业的 44 种职业,共 1320 个任务
-
出题的是平均从业 14 年的行业专家,每道题都来自他们真实的工作产出
-
专家完成一道题平均需要约 7 小时,有些任务长达数周
-
评分方式是专家盲评:把模型的交付物和人类专家的交付物放在一起,让另一位同行业专家判断哪个更好
-
在 220 道公开题上,表现最好的模型被判「优于或持平人类专家」的比例是 47.6%
GDPval 还给出了一个很有意思的数据:用模型自动评分,和人类专家的一致率是 66%,而两位人类专家之间的一致率也只有 71%。
这条路线最接近「真实世界」,但代价也最高:每道题都要请资深从业者花一整天来出、再请同行来评。71% 这个数字也提醒我们,在开放式任务上,就连专家之间也只有七成共识。好的 benchmark 不是要消灭分歧,而是要让分歧可以被测量。
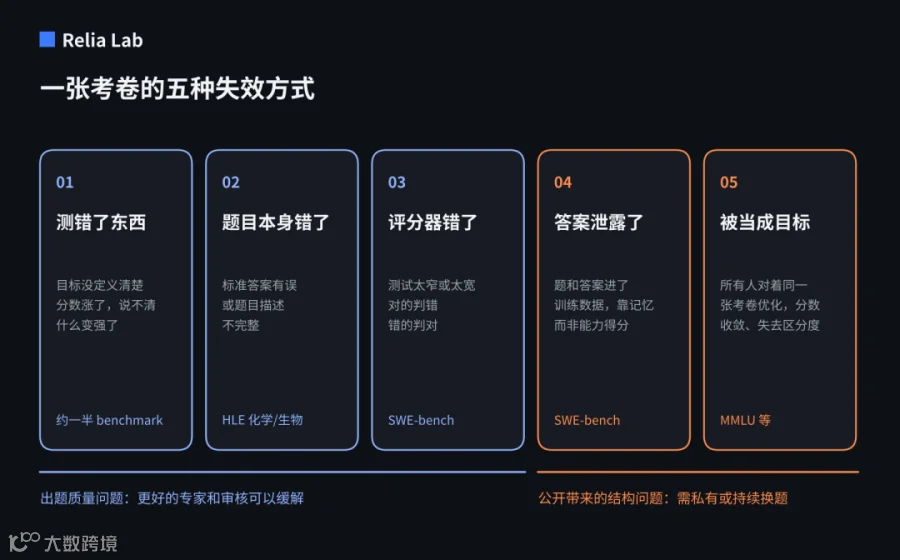
把这三个案例放在一起,可以总结出 benchmark 失效的五种常见方式:
-
测错了东西:测量目标没定义清楚,分数涨了,但说不清什么变强了
-
题目本身错了:标准答案有误,或者题目描述不完整,比如 HLE 的化学和生物题
-
评分器错了:测试太窄或太宽,把对的判错、把错的判对,比如 SWE-bench 的测试
-
答案泄露了:题目和答案进入训练数据,模型靠记忆而不是能力得分
-
被当成了目标:所有实验室对着同一张考卷优化,分数收敛,失去区分度
前三种是出题质量问题,靠更好的专家和更严格的审核可以缓解。后两种是考卷公开带来的结构性问题,任何公开的静态考卷都躲不开。
-
私有题集:OpenAI 在 SWE-bench 退役报告里明确表示,正在投入私下编写的 benchmark,GDPval 就是一例
-
持续更新:用比训练数据更新的题,比如 LiveCodeBench 只用模型训练截止日期之后出现的编程题,HLE 也推出了滚动版本
-
退役机制:一张考卷分不出模型了就主动换掉,而不是继续在上面卷小数点
综合这些经验,我们给自己定了一份 benchmark 设计清单:
-
先写测量目标,再出题:用一两句话说清这张考卷测什么、不测什么
-
题目分布要有代表性:题的来源要能代表真实场景,而不是哪里方便就从哪里采
-
每道题至少经过一次独立盲做:另一位专家能独立做出来,才能排除「题目本身错了」
-
评分器要单独验证:抽样检查评分器的判断和专家判断是否一致,并报告一致率
-
报告误差,而不只是均分:两个模型差 1 分,是否在误差范围内
-
-
-
提前设计退役条件:比如头部模型的分差小于某个阈值时,就换新题
Relia 正在做的作品评估 benchmark,要回答的问题是:给定一个研究作品,比如一篇 arXiv 论文或一个 GitHub 仓库,它的质量怎么样?
对照上面的清单,这张考卷有一个特殊之处:在出题的时候,标准答案还不存在。
一个作品到底好不好,真正的答案往往要过一两年才出现:它有没有被后续工作引用和跟进,开源项目有没有被真实使用,作者后来做出了什么。这让我们的设计思路和前面三条路线都不太一样:
-
今天打分,明天对答案:专家和模型今天根据 rubric 给作品打分,一段时间后再用真实结果去检验,看哪些判断对了、哪些错了
-
天然防泄露:答案在未来,今天的任何模型都不可能在训练数据里见过
-
评分标准本身被检验:如果某条 rubric 打出的高分作品后来普遍表现平平,这条 rubric 就该改写或降权
-
用两两比较处理品味:「这个问题选得好不好」很难打绝对分,但让专家比较两个作品哪个更好,一致性会高得多,GDPval 用的也是这个办法
这种「先预测、后验证」的结构,也是我们理解的 benchmark 自进化的起点:考卷不是写完就固定的,它会被真实结果持续校准。这部分会在系列最后一篇展开。
一张好考卷,本质上是一组被反复验证过的专业判断:测什么、出什么题、怎么评分、什么时候该换。
SWE-bench 的退役不是失败,它恰恰说明这张考卷完成了自己的使命:它曾经准确地衡量了一段时间里 AI 写代码的能力,直到模型超过了它。每一张考卷都会过期,真正稀缺的是持续出好考卷的能力。
Relia|Where frontier AI teams meet researchers and builders.
Relia 是面向 AI 研究型人才的招聘平台,连接前沿 AI 团队和 AI 硕博研究者、builder,我们覆盖的方向:
AI4Science:药物发现、蛋白质、科学智能体
🙋 求职者:在 Relia 浏览前沿岗位,一键直投
🌐 https://www.relia.ai/(阅读原文)