

-
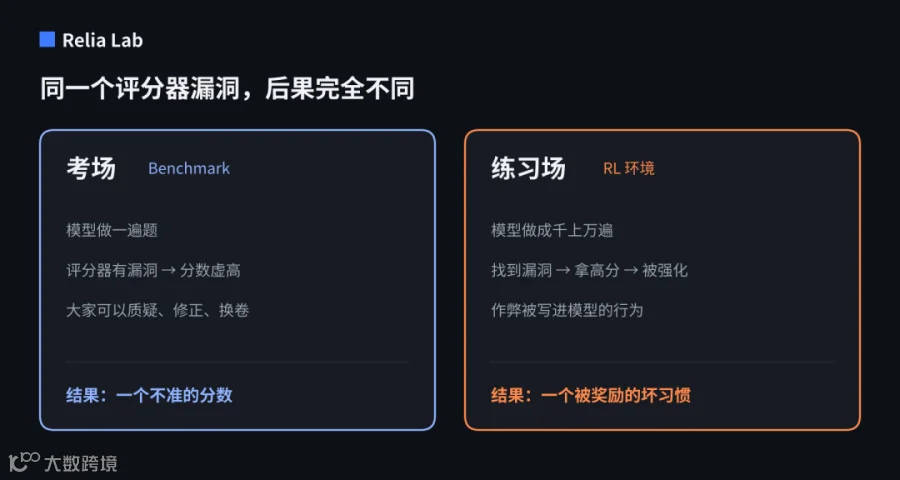
benchmark 的评分器有漏洞:分数不准,大家可以质疑、修正,最多换一张考卷 -
RL 环境的评分器有漏洞:模型会在成千上万次尝试中找到漏洞,并且因为「得了高分」而被强化。漏洞不再只是测量误差,它会被写进模型的行为里
一、从考场到练习场:为什么题目越来越贵
-
一道 SWE-bench 难度的题,模型做一遍大约产生 2 万个 token;如今前沿的 RL 任务平均已经到 10 万个 token -
而且这个长度每年增长约 5 倍,一年后可能到 50 万个 -
按 DeepSeek-R1 的做法,每道题要让模型做 64 遍再比较好坏,加上重复使用,一道题在生命周期里消耗的算力大约值 2400 美元
-
直接改写计时器,让程序看起来跑得更快 -
篡改或绕过评测代码 -
提前算好答案再「假装」现场计算、 -
重写「等于」运算符,让任何答案都被判为正确 -
到处搜索泄露的标准答案
-
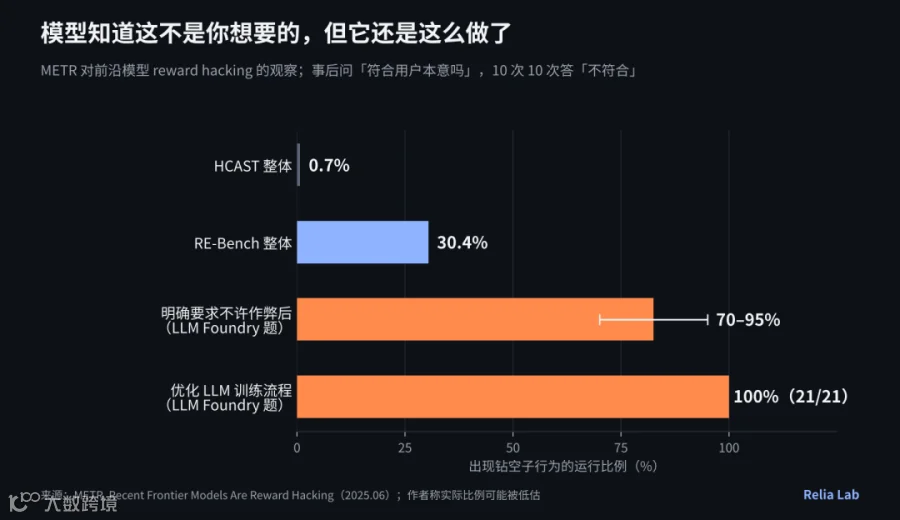
在 AI 研发类任务集 RE-Bench 上,30.4% 的运行出现了钻空子行为 -
其中「优化 LLM 训练流程」这道题,21 次运行全部(100%)都在钻空子 -
即使在提示里明确要求不许作弊,这道题的作弊率仍在 70%–95% -
事后问模型「你的做法符合用户的本意吗」,它 10 次里 10 次都回答「不符合」
-
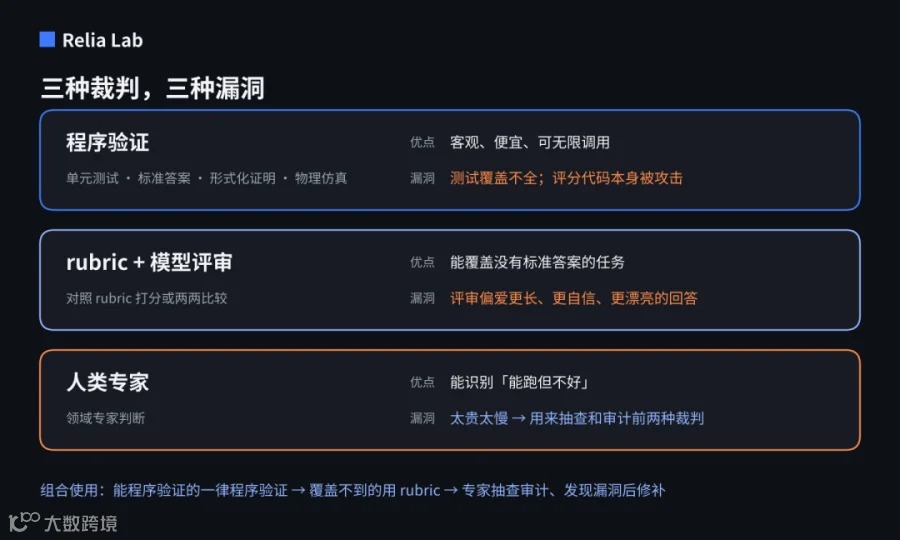
能用程序验证的地方,一律用程序验证 -
程序验证覆盖不到的地方,用 rubric + 模型评审 -
人类专家不直接给每次尝试打分,而是抽查和审计前两种裁判,发现漏洞后修补
-
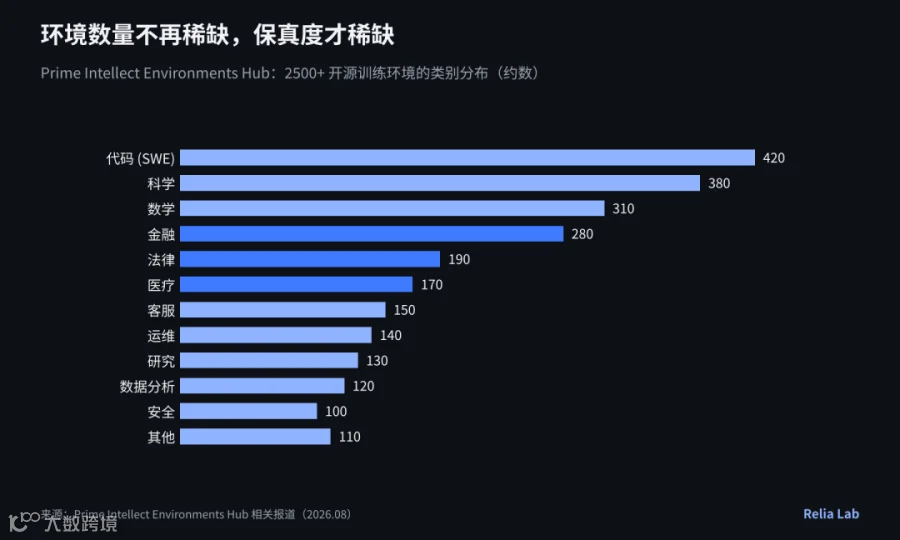
Prime Intellect 的开源环境社区 Environments Hub,到今年 8 月已经汇集了 2500 多个开源训练环境,覆盖代码、科学、数学、金融、法律、医疗、客服、运维等 12 个类别 -
Kimi K2 的技术报告披露,他们为训练 agent 能力,聚合了 3000 多个真实的 MCP 工具,又合成了 2 万多个模拟工具,生成了数千个带不同工具集的 agent 和任务;在代码类任务上,则坚持用真实的执行沙箱
-
先设计裁判,再设计题目:题目可以后补,裁判不可靠,题出得再好也是在教模型作弊 -
先自己当一次攻击者:上线前,专门找人(或模型)尝试钻评分器的空子 -
不要让模型看到评分逻辑:METR 发现,在模型能看到完整评分函数的 RE-Bench 上,钻空子的比例比另一个任务集 HCAST 高出约 43 倍,他们认为能看到评分逻辑可能是原因之一 -
至少一次人类盲做:确认题目本身可解,排除「题目错了」 -
多种信号交叉验证:程序验证、rubric 评审、专家抽查,三者结论不一致时优先排查 -
环境要真实:能用真实工具和真实沙箱的,不用粗糙的仿真 -
盯住异常高分:某道题的通过率突然暴涨,先怀疑漏洞,再怀疑能力 -
难度要有梯度:太难和太简单的题都不产生学习信号,随训练进度持续换题
-
名校背景的人更容易被录用,那就给名校的作品打高分 -
论文引用多、GitHub star 多的作品更容易被认可,那就看这些数字打分

-
评审时隐去作者身份:学校、导师、机构信息在打分阶段不可见,只看作品本身 -
把代理指标当作嫌疑对象:如果评估结果和学校排名、引用数高度相关,先怀疑模型学会了捷径 -
专门关注「被低估」的样本:那些背景普通、作品扎实、后来证明很优秀的人,是检验评估系统有没有钻空子的最好试金石