

导读AI 算子调优要靠真实硬件反馈指导多轮修改,再用外部记忆把经验带到后续任务。ForgeKernel 的公开榜单展示了指定负载上的性能,9 月公开的 SAGE 论文则用受控实验检验经验学习机制。两者可以互相参照,却不能据此排出“反馈”和“长程”的功劳大小。本文从 NEON 类比讲起,说明工具结果怎样进入 Agent、经验怎样更新,以及这些成绩离整网提速还有多远。
本文 2845 字,阅读约 7 分钟
从 NEON 看懂 AI 写算子
ForgeKernel 的榜单与 SAGE 的论文,各说明什么
先有能编程的硬件,再谈 Agent 怎么优化
反馈怎样进入 Agent,又怎样变成下一次修改
SAGE 怎样把一次试错变成可复用经验
95.5% 证明了什么,离实际收益还差什么
从 NEON 看懂 AI 写算子
如果你曾把普通循环改成 NEON 向量实现,就已经接触过这类工作的基本思路:计算任务没变,执行方式变了。
算子是矩阵乘法、求和、归一化等基本计算操作;Kernel 则是在芯片上执行这些计算的底层程序。本文所说的“写算子、调优算子”,主要就是编写和优化 Kernel。
以两个数组相加为例,ARM CPU 上的 NEON 可以让一条指令处理多对元素。用了向量指令之后,还能继续调整数据布局、访存与指令安排。GPU、NPU 上也需要类似的优化判断,只是计算单元、存储结构与编程方式不同。
实际难点常在计算之外:数据块能否放进片上存储,多个核是否分工均衡,搬运与计算能否重叠,以及同步是否既保证正确又避免多余等待。这些选择相互影响,某次修改可能更快,也可能重新引入错误。
因此,AI 写出一版代码只是起点,技术价值要由正确性和实际性能兑现。优化目标也有边界:在指定芯片、输入规模、精度要求与开发预算内找到更好的实现,很难证明已到绝对极限。
ForgeKernel 的榜单与 SAGE 的论文,各说明什么
以 ForgeKernel 为名的算子提交,提供了跨硬件性能的公开观察入口。
截至 2026 年 10 月 27 日本次核验,在 NVIDIA SOL-ExecBench 的 FlashInfer-Bench 合集、B200 硬件、评测栈 v1.1 下,ForgeKernel 列第一,完成 26/26 项任务,SOL Score 为 0.814101。这个分数用于衡量相对硬件理论性能界限的表现,不能直接读作“算力利用率 81.4%”。
同次核验中,ForgeKernel 在 CANNBench official-tasks 2.0 的 910C、950DT、950PR 三个硬件榜均列第一。以 950PR 榜为例,页面显示基准加速比 1.862×、测例通过比例 85%。榜首、加速比和测试覆盖应一起看,不能理解为每个算子、每个输入都已经通过验证。
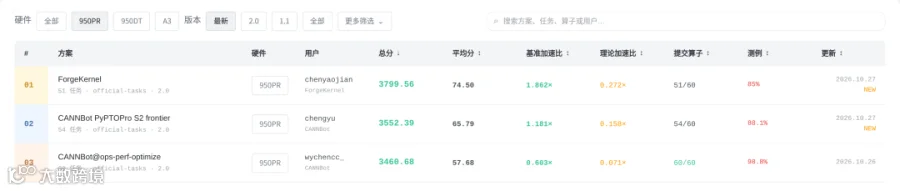 CANNBench 950PR 榜单,版本 2.0;ForgeKernel 列第一,同时显示加速比与测例覆盖。截图日期:2026-10-27 | 来源:CANNBench 官方动态页面
SAGE(通过外部记忆持续改进 NPU 算子代码的智能体框架)则提供了另一类证据。复旦大学、中国科学技术大学与华为的研究者于 2026 年 9 月 28 日公开预印本,研究如何让参数保持不变的大模型,借助工具和跨任务经验适应昇腾编程。
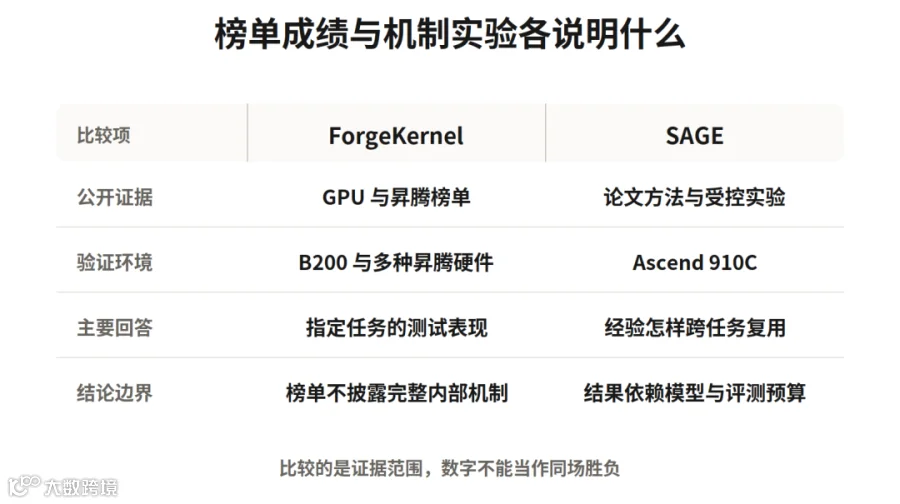
两者的评测集、指标与公开材料不同,不能将加速数字并排当作同场对决。榜单可以证明提交实现的测试表现;要解释系统为什么有效,还需要方法披露和受控比较。本文用 ForgeKernel 观察公开性能,用 SAGE 展开可核验的机制。
先有能编程的硬件,再谈 Agent 怎么优化
让 AI 改写 NPU 上的 Kernel,需要工具链开放相应的底层编程能力。
Ascend C 是华为 CANN 软件体系中面向昇腾的专用算子开发语言,兼容 C/C++ 编程习惯,提供计算、存储管理和数据搬运等接口。开发者可以安排数据分块、核间分工与同步;英伟达 GPU 的 CUDA 工具链也允许编写并调优在目标芯片上执行的 Kernel。
“支持自定义算子”还要看代码跑在哪里。例如,RK3588 所用官方 RKNN 公开自定义算子接口列出了 CPU、GPU 后端,没有 NPU 后端,不能通过该接口提交自写的 NPU Kernel。这是该接口的开放边界,不能据此断言芯片在硬件上绝对做不到。
接口开放之后,Agent 仍需要硬件知识。在采用 AIC/AIV 分离架构的昇腾芯片上,AIC 负责矩阵计算,AIV 负责向量计算;全局内存与片上存储之间的搬运、不同计算单元的同步,都有具体约束。把熟悉平台上的代码写法直接迁过去,并不能保证正确或高效。
SAGE 为此先人工整理速查表、调试指南和完整实现示例,再让 Agent 生成简单算子,与专家实现对照,提炼初始经验。论文说明,用于这一步的算子与后续 88 个评测算子分离。它的自动迭代建立在这些人工准备的知识与评测环境之上。
反馈怎样进入 Agent,又怎样变成下一次修改
SAGE 使用 OpenCode(提供工具调用与执行循环的编程智能体工具)组织开发。大模型负责理解任务、分析反馈和生成代码,OpenCode 支撑工具调用与多轮执行,SAGE 则在这个环境中管理经验的评价与复用。
Agent 调用编译、测试或诊断工具后,读取输出及报告,将反馈、当前代码和相关经验用于下一轮修改。诊断工具可以自主调用,无须人每轮分析后再告诉它改哪里。
反馈是否充分,要看它能否帮助 Agent 定位问题,并指导下一次修改。单个时延只能告诉它快慢;SAGE 还开放了输出中间结果的 DumpTensor、检查内存等运行问题的 msSanitizer、分析性能的 msProf 等工具,让它围绕当前假设按需取证。有效的信息需要与代码和硬件知识结合,形成可验证的修改,而非仅仅增加日志数量。
论文附录中的 Mla 融合注意力算子就有一条完整轨迹:最初代码出现挂起,修复后又有数值错误;DumpTensor 显示 softmax 输入为零,Agent 随后检查计算写入完成时机、输入布局和位置编码相关维度,经过多项修正才得到首个正确版本。
该版本耗时 0.420 毫秒。继续优化时,一次双缓冲修改破坏了数据搬运依赖,被撤回;后续通过调整同步、按 query token 分配多核工作,以及减少中转搬运,得到 0.155 毫秒的版本。相对首个正确版本,这个算子的时延下降约 63.1%。这是单个算子轨迹中的结果,不是整个模型的提速。
长程执行的价值就在这类过程中:保留正确版本,比较候选,识别失败方向,再继续探索。SAGE 为每个算子设置最多 30 轮交互,修复与优化共享预算。这里的“多轮”有明确上限,论文也指出尚未覆盖更长周期的复杂融合 Kernel 开发。
SAGE 怎样把一次试错变成可复用经验
在当前算子里反复修改,与把经验用于下一个算子,是两件事。SAGE 的重点是后者:大模型参数保持不变,更新的是外部经验和常驻规则。
 图 1:左侧对所有检索经验给予同样的评分目标;右侧区分实际采纳与未采纳经验,并将跨算子复用的经验提炼为常驻规则 | 来源:SAGE 论文 arXiv:2609.35568v1
它先用“采纳追踪效用估计”(ATU)记录每条检索经验是否参与诊断或代码修改,再结合阶段结束时的测试结果更新评分。成功修复或有效提速产生正向评分,由被采纳的经验分摊;失败阶段和检索后未采用的条目会得到小幅负向反馈。
例如,检索出四条经验,只用了其中一条来修改同步逻辑,就不应因为最终测试通过,让另外三条也获得同样奖励。这样的记录能改善经验排序,但仍是对经验效用的估计,不能证明每条经验独立贡献了多少性能。
接着,“效用门控巩固”(UGC)挑选价值评分为正、在多个算子中被反复采用的经验,提炼为简短规则,放进有限的常驻上下文。完整经验保留供检索,常用规则直接随任务提供;长期不用的规则会降低优先级,必要时退回可检索状态。
反馈提供修改依据,多轮执行支撑持续搜索,记忆负责跨任务复用。三者承担不同职责,运行得久、记录得多,都不能单独保证优化有效。
AGENTS.md、Skill 怎么用?一次端侧 NEON 优化把边界说清
95.5% 证明了什么,离实际收益还差什么
SAGE 主实验在 Ascend 910C 上评测 NPUKernelBench 的 88 个算子。各方法共享基础模型、初始知识、诊断工具、交互预算与硬件评测环境,主要变化是记忆机制。其中,Value Memory 对照也积累跨任务经验,但对同批检索经验使用统一评分目标,没有 SAGE 的采纳追踪和冷热规则巩固。
使用 GLM-5.2 时,SAGE 在预算内正确解出 84/88 个算子,执行通过率(ER)为 95.5%,对照 Value Memory 为 84.1%。在已经正确解出的算子中,86.9% 快于对应 torch_npu 实现,对照组为 75.7%。正确解出多少、解出后有多少更快,是两个不同指标。
两项提升分别为 11.4 和 11.2 个百分点,反映正确性覆盖与性能覆盖的不同变化。95.5% 描述的是预算内正确解出的比例,86.9% 的分母则只有已解出的算子。候选与基线使用相同输入及计时边界,预热 5 次、计时 100 次,以设备端事件测量执行时延。
模型能力也没有被经验库抹平:同一 SAGE 机制下,DeepSeek-V4-Flash、Qwen3-Coder-Next 的 ER 分别为 64.8%、31.8%。这些结果说明基础模型仍然影响经验的使用效果。受控比较主要检验记忆机制,工具与预算保持一致,未单独量化增加诊断反馈或延长执行的收益,因而不能给“反馈”和“长程”排出功劳大小。
工程价值还要再算三笔账:调优带来的运行节省,能否覆盖模型调用、编译和设备测试的投入;单算子加速,能否转化为整网时延与吞吐改善;输入形状、精度或软件版本改变后,是否仍然正确且更快。
因此,判断 AI 算子优化的分量,应看它在什么约束下,把哪些实现改对、改快,并留下了什么可复用经验。专家的工作也仍在其中:定义验收标准、准备可靠工具、审查适用边界,以及验证最终的模型收益。
参考资料
•NVIDIA SOL-ExecBench 官方项目与榜单: https://research.nvidia.com/benchmarks/sol-execbench
•CANNBench 官方榜单与评测说明: https://cannbench.com/leaderboard
•SAGE 论文全文与实验附录: https://arxiv.org/html/2609.35568v1
•Arm NEON 向量运算与访存接口参考: https://arm-software.github.io/acle/neon_intrinsics/advsimd.html
•Ascend C 概述、编程接口与硬件架构: https://asc.gitcode.com/guide/
•英伟达 CUDA 编程指南: https://docs.nvidia.com/cuda/cuda-programming-guide/index.html
•RKNN 自定义算子接口与执行后端定义: https://github.com/airockchip/rknn-toolkit2/blob/master/rknpu2/runtime/Linux/librknn_api/include/rknn_custom_op.h
文章仅做学术分享,如有侵权请联系删除,非常感谢!